Lost in Benchmarks 精读:用项目反应理论诊断大模型评测
大模型测评通常通过一组题目给模型打分,再据此比较模型能力。随着模型能力提升,一些题目逐渐变得容易,榜单上不同模型的得分也可能越来越接近。此时,仅看总分,很难判断题目还能提供多少区分模型的有效信息。
《Lost in Benchmarks? Rethinking Large Language Model Benchmarking with Item Response Theory》研究了这一问题。作者提出 PSN-IRT,用答题结果同时估计模型能力和题目属性,进一步分析测评数据集的难度、区分度、猜测率、可答性,以及面向高能力模型的测量空间。这项研究也检验了能否利用这些估计结果,选择较少的题目进行模型比较。
本文依据论文 PDF,对应 arXiv:2505.15055v3,2026 年 1 月 16 日版本。第一作者为 Hongli Zhou;arXiv 页面注明论文已被 AAAI 2026 接收为 Oral。本文纳入该版本正文及附录的 全部 5 张图、8 张表,图表沿用论文编号;表格同时提供中文转录和可展开的原图。文中的实验数值均为论文报告值,未进行独立复现。论文版本与元数据、官方代码仓库。
先理解大模型测评在做什么
一个 benchmark 可以理解为一份包含题目、参考答案和判分规则的试卷。不同试卷覆盖的能力不同:数学题检验数学求解,代码题检验程序生成,知识问答检验事实回答,选择题则要求模型从给定选项中作答。最终分数受到题目内容、难度分布、提示方式和判分规则共同影响。
最常见的汇总方式是计算答对题目的比例。假设一份试卷有 100 道题,模型 A 答对 90 道、模型 B 答对 89 道,这只能说明它们在该次评测中的正确率相差 1 个百分点。这个差距是否足以支持稳定的能力排序,还需要考虑题目构成、测量不确定性以及模型在哪些题目上出现差异。这个例子仅用于解释指标,不是论文中的实验。
如果两者都能答对某道题,这道题可以验证它们掌握了相应知识,但对区分这两个模型的帮助可能有限。如果所有模型都答错某道题,也不能仅凭这一现象判定题目具有很高的测量价值:题目可能很难,也可能存在信息不足或判分问题。
因此,评测需要同时关注两个对象:模型表现和题目能提供的测量信息。本论文将项目反应理论引入这一分析过程。“项目”在这里指单道题目,英文为 item。
介绍部分的目的与动机
论文关注两个现象。第一,不同 benchmark 可能给出不同的模型排名;第二,部分 benchmark 上强模型的得分接近,题目对高能力模型的区分空间不足。作者据此提出:除了统计整体成绩,还应诊断试题本身的测量特征。原论文第 1—2 页。
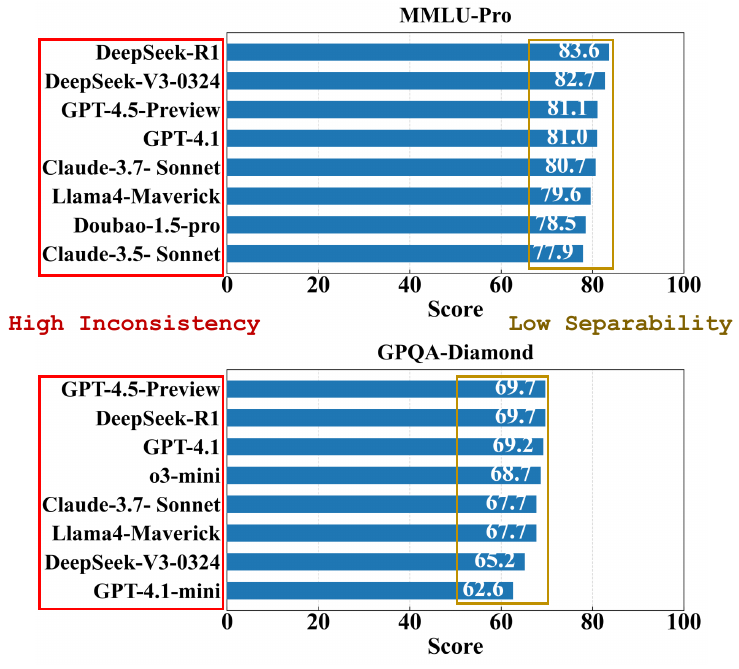
图 1|MMLU-Pro 与 GPQA Diamond 排行榜示例。 论文用两个榜单展示模型名次不一致以及强模型得分接近的现象。 来源:原论文第 1 页。
图 1 中,MMLU-Pro 和 GPQA Diamond 的模型排序有所不同,多个高分模型的分数也较为接近。它是论文用于说明问题的排行榜示例。图中的模型名单与后续正式实验使用的 12 个模型不同,不能把两者合并理解为实验配置。
跨数据集排名不同,本身并不必然意味着某个榜单错误。不同数据集测量的能力和侧重点不同,也可能产生合理的排序差异。论文的研究动机是进一步分析这些差异背后的测量条件,并检验某些题目是否已经难以区分当前模型。
作者希望回答三个具体问题:从模型逐题答对或答错的记录中,能否估计有解释性的模型能力与题目属性;这些属性能否帮助诊断现有 benchmark;根据题目的信息量选取较小子集,能否得到与人类偏好参考排名更一致的模型排序。
相关工作与论文的位置
项目反应理论(Item Response Theory,IRT)最初广泛用于教育与心理测量,核心思想是用受测者的潜在能力与题目属性共同描述答对概率。它已被用于分析 NLP 测试集,因此本论文的贡献不能表述为“首次将 IRT 用于大模型或 NLP 评测”。
Vania 等人的研究使用 IRT 分析 NLP 测试集,并讨论试题对后续能力进步的测量空间;本论文采用的 LEH 指标与这条研究路线相关。Byrd 与 Srivastava 则研究了如何预测自然语言问答题的难度与区分度,并在 HotpotQA 上分析这些属性与题目、答案及上下文特征的关系。Vania et al., 2021、Byrd & Srivastava, 2022。
另一类工作关注 benchmark 之间的一致性以及测评程序选择对结果的影响。BenchBench 研究 Benchmark Agreement Testing(BAT)的程序选择,并提出规范化建议与工具;本论文在选题实验中借助 BAT 思路,比较题目子集产生的排名与 Arena 参考排名。ADeLe 则从任务的认知需求出发分析评测,为理解 benchmark 测量什么能力提供另一种视角。BenchBench、ADeLe。
高效评测也是重要的相邻方向。tinyBenchmarks 研究如何通过少量题目估计模型在完整 benchmark 上的表现。本论文的选题实验进一步关注与外部参考排名的关系,而“复现完整试卷分数”和“提高与参考排名的一致性”是不同的目标,不能混用。tinyBenchmarks。
PSN-IRT 的具体研究位置,是使用分离的神经网络估计模型与题目参数,保留 IRT 概率函数,基于四参数模型系统分析多个 benchmark,并开展选题实验。它与已有 IRT、神经 IRT、排名一致性和小样本评测研究存在连续关系。原论文相关工作与方法,第 2—4 页。
方法:从答题记录估计题目属性
4.1 输入是模型逐题作答的结果
作者通过 OpenCompass 收集评测记录,并将每个“模型—题目”组合的结果表示为二值标签:答对为 1,答错为 0。由此得到一个响应矩阵,行对应模型,列对应题目,单元格记录该模型在该题上的判分结果。
PSN-IRT 学习这些记录中的统计关系。它所预测的是某个模型答对某道题的概率。真实大模型回答由原评测流程产生,PSN-IRT 不负责生成这些答案。
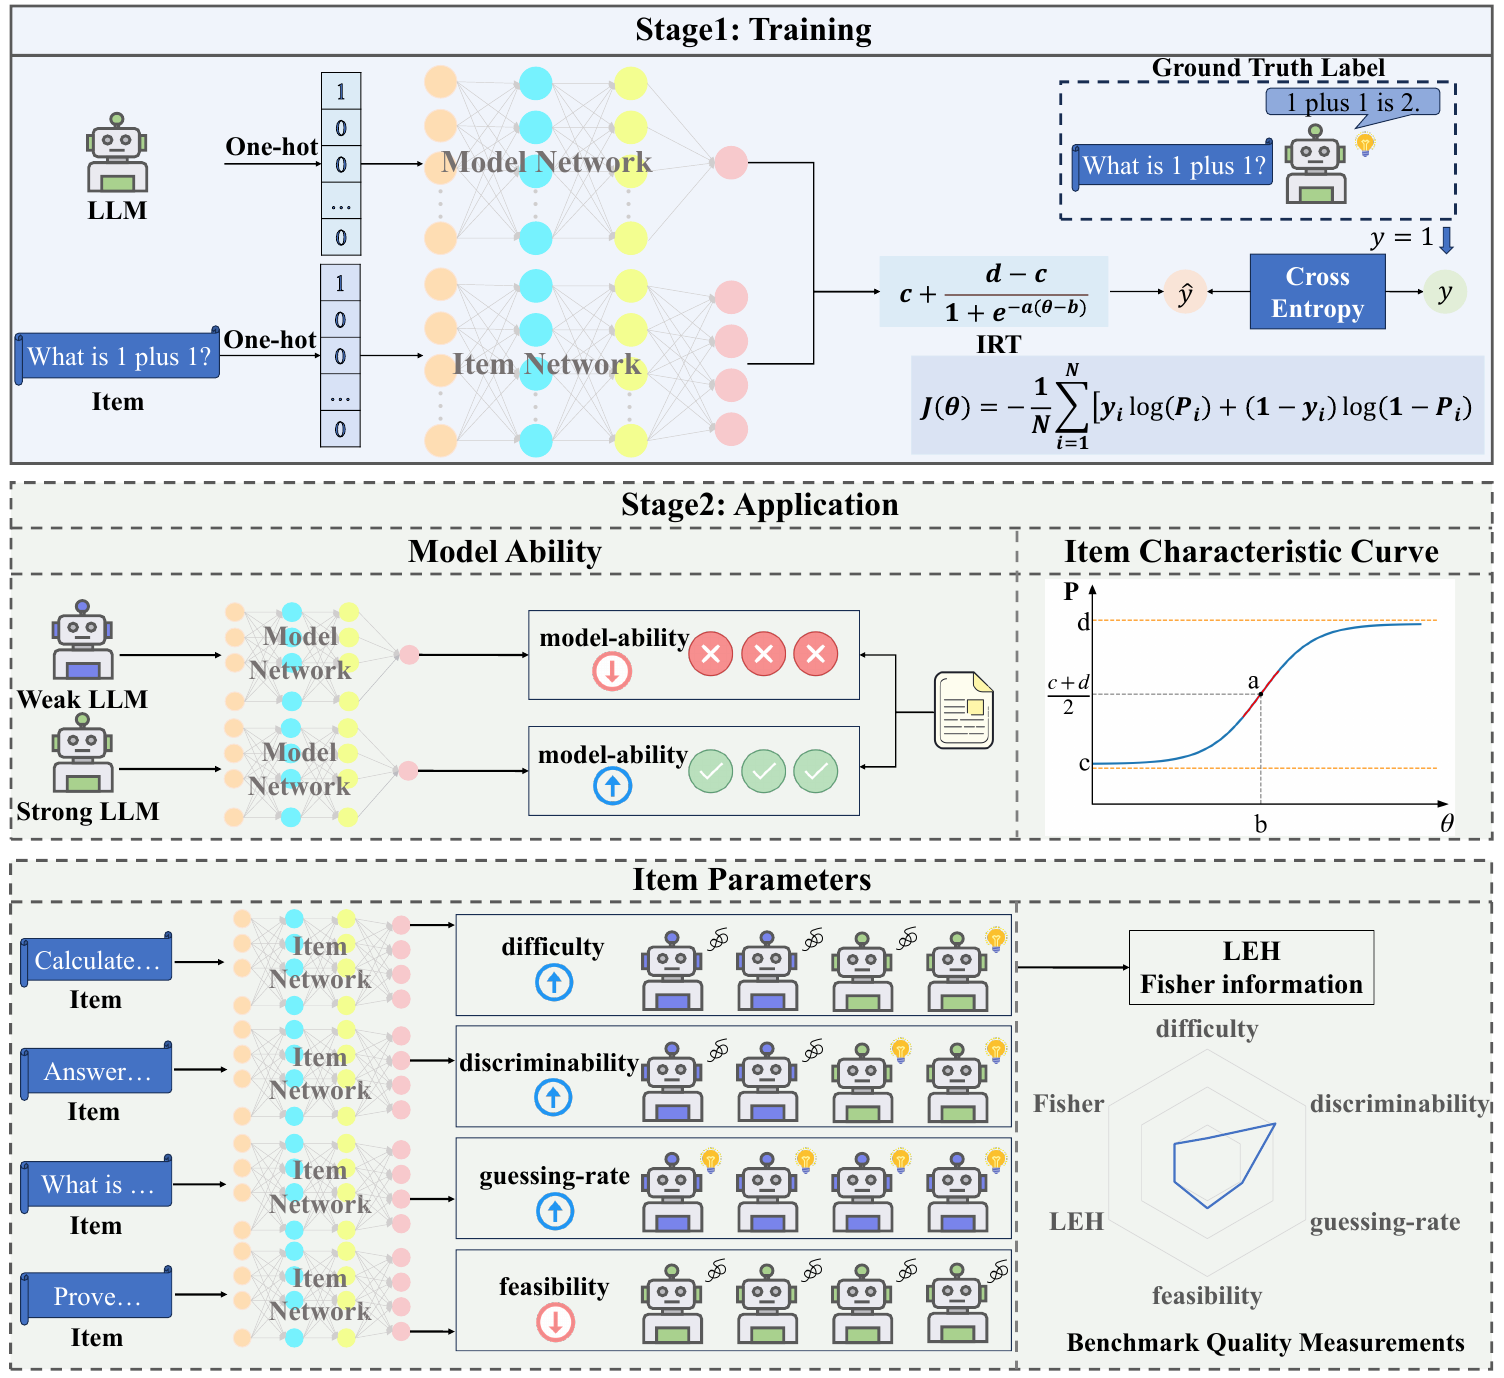
图 2|PSN-IRT 的训练过程与应用方式。 模型网络估计能力 θ,题目网络估计 a、b、c、d,通过 IRT 公式预测答对概率;训练后分别用于模型能力估计和题目属性诊断。 来源:原论文第 3 页。
4.2 两条网络分别输出模型参数与题目参数
PSN-IRT 全称为 Pseudo-Siamese Network for Item Response Theory,可译为“用于项目反应理论的伪孪生网络”。原始设计将模型标识和题目标识分别进行 one-hot 编码,送入各自的神经网络。两个路径各采用三层全连接网络与 ReLU 激活函数:模型网络输出能力参数 ,题目网络输出四个参数 。
随后,将这些参数代入四参数 Logistic 模型(4PL):
其中 是模型 答对题目 的预测概率。该式对应论文公式 2。原论文第 2—3 页。
这四个题目参数可按以下方式理解:
| 参数 | 名称 | 在概率曲线中的含义 | 解读边界 |
|---|---|---|---|
| 难度 | 曲线中点对应的能力位置;通常越大,需要的能力越高 | 是估计尺度上的位置,允许为负数,不能读成错误率 | |
| 区分度 | 控制曲线变化的陡峭程度 | 实际测量作用还受到 、 和被测能力位置影响 | |
| 猜测率 | 低能力端的答对概率下渐近线 | 不等同于已证实的随机猜测概率或训练数据泄漏比例 | |
| 可答性 | 高能力端的答对概率上渐近线 | 是模型估计量,不等同于人工确认的题目可解比例 |
当 时,概率为 ,不一定等于 0.5。例如,若 ,中点为 0.5;若 ,中点则为 0.4。这两个数值例子仅用于说明公式。
如果一道题的曲线很平,不同能力模型的答对概率变化较小;如果曲线在被测模型的能力区间内变化较快,该题可以提供更多区分信息。由此也能理解:一味增加题目难度,并不保证评测更有用。需要考察题目是否适合目标模型的能力范围。
4.3 如何训练
训练时,将预测概率与观察到的 0/1 标签进行比较,使用二元交叉熵损失,同时更新两个网络。能力和题目参数没有对应的人工“真实标签”,它们是通过拟合答题记录共同估计出来的。原论文公式 3,第 3 页。
这种设计保留了 IRT 参数的解释方式,同时用神经网络完成参数估计。不过,它仍遵循单维能力和单调性等 IRT 假设。对于数学、编程、知识等多种能力混合的测评,单一能力参数是一个简化描述。
此外,原始设计依赖训练中出现的模型与题目标识。论文明确指出,分析新题目需要重新训练。不能据此宣称模型仅阅读新题文本,就能直接预测其难度和质量。原论文第 4 页。
4.4 除四个参数外,还分析 LEH 与 Fisher 信息
LEH(Local Efficiency Headroom) 衡量在当前最高观察能力附近,答对概率曲线是否仍有明显的上升空间。论文将它定义为 ICC 在最高观察能力处的导数:
若曲线在这一位置已接近平坦,则更强的模型出现后,该题的正确率也可能变化有限。LEH 与所估计的能力尺度及当前模型集合有关;论文没有给出可用于所有研究的统一合格阈值。
Fisher 信息 描述一道题在某个能力位置上,能提供多少能力估计信息。对于二值结果,可以写为:
代入 4PL 曲线,得到论文公式 4:
这解释了为何仅按区分度 排序选题可能不够:Fisher 信息同时考虑曲线形状与目标能力位置。一道题即使区分度高,若对目标模型过于容易或困难,也未必具有较高信息量。原论文第 4 页。
实验设置:模型、数据与两层指标
5.1 实际参加实验的 12 个模型
论文第 4.1 节将以下 8 个模型作为较强模型:360GPT2-Pro、DeepSeek-V3、Doubao-pro、Gemini-1.5、Hunyuan-Turbo、Moonshot-v1、Qwen-Plus、Yi-Lightning。
另加入 4 个相对较弱的模型:Gemma-2B-it、Mistral-7B-Instruct-v0.1、Qwen2.5-3B-Instruct、Vicuna-7B-v1.3。加入能力较低的模型,可以扩大观察到的能力范围,减少“所有受测模型都答对”导致的信息不足。
以上名称和强弱分组沿用论文,不代表这些模型在当前时间的排名。论文将 Gemini 写为 Gemini-1.5,正文没有进一步明确 Pro 或 Flash 变体,因此此处不补充未经确认的具体版本。原论文第 4 页。
5.2 使用了哪些测评数据集
表 1|本研究使用的 11 个测评数据集。 来源:原论文第 5 页;数值按原表转录。
| 数据集 | 本研究题数 | 领域 | 原始判分指标 | 题目形式 |
|---|---|---|---|---|
| ARC-C | 295 | 通用 | EM | 选择题 |
| BBH | 6511 | 通用 | EM | 混合 |
| Chinese SimpleQA | 3000 | 知识 | LLM-as-a-Judge | 问答 |
| GPQA Diamond | 198 | 科学 | EM | 选择题 |
| GSM8K | 1319 | 数学 | EM | 问答 |
| HellaSwag | 10042 | 通用 | EM | 选择题 |
| HumanEval | 164 | 代码 | Pass@1 | 问答 |
| MATH | 5000 | 数学 | EM | 问答 |
| MBPP | 500 | 代码 | Pass@1 | 问答 |
| MMLU | 14042 | 通用 | EM | 选择题 |
| TheoremQA | 800 | 科学 | EM | 问答 |
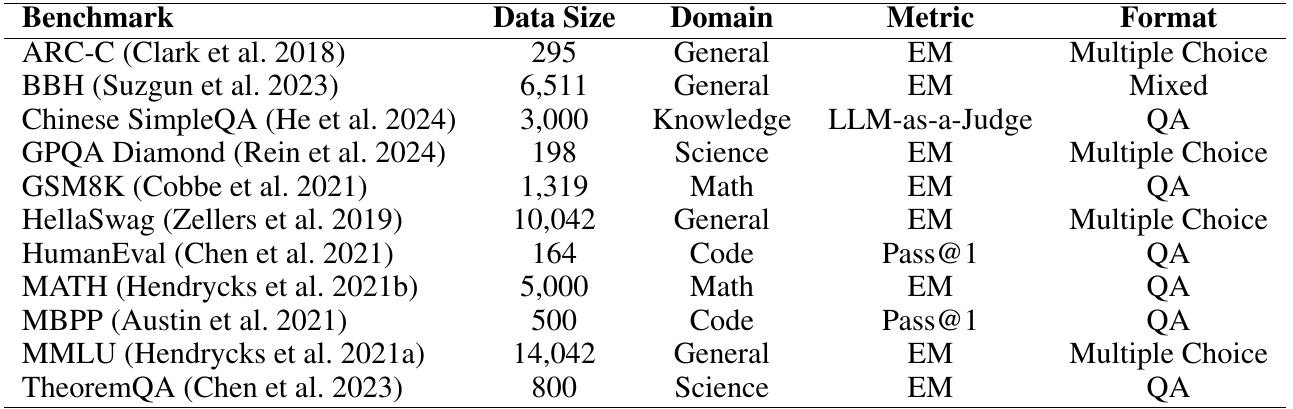
表 1 的题数合计为 41,871,是论文此次实验使用的题量。它们不一定等于各数据集所有发行版本的完整规模。例如,ARC-C 在该表中为 295 题,应按本研究配置理解。
这些数据集覆盖通用任务、知识、科学、数学和代码。BBH 包含多类任务;GPQA Diamond 为科学选择题;GSM8K 和 MATH 为数学问答;HumanEval 和 MBPP 为代码任务。不同领域的数据统一用于响应矩阵分析,并不意味着它们测量的能力完全相同。
表 1 中的指标属于原始大模型作答评测:EM(Exact Match)关注答案是否按评测规则与参考答案匹配;Pass@1 关注一次代码生成的成功情况;LLM-as-a-Judge 使用模型评审器辅助判断回答。作者将这些判分结果转换为二值记录。
表 2 中的 ACC、F1、AUC 则属于PSN-IRT 等估计方法的正确性预测评测。例如,ACC 为 0.7998 表示该估计方法对答对或答错记录的分类准确率为 79.98%,不能读成“12 个大模型的平均答题正确率为 79.98%”。
5.3 训练和比较对象
估计方法实验将“模型—题目交互记录”按 60% / 20% / 20% 划分为训练、验证和测试集。这种划分主要检验在已有模型和题目集合中预测留出交互的能力;它不能直接作为对全新模型或全新题目的零样本泛化证据。
训练采用 Adam,学习率 0.003、权重衰减 0.0001、batch size 512,根据验证集 F1 进行早停,patience 为 5 个 epoch。后续 benchmark 属性分析则在完整响应数据上训练 30 个 epoch。论文报告使用单张 NVIDIA A800-80G GPU。附录 A.1,第 10 页。
比较方法包括传统 IRT 的 MLE(最大似然估计)、MCMC(马尔可夫链蒙特卡洛)、VI(变分推断)、VIBO,以及采用神经网络的 Deep-IRT。主表中,传统 IRT 与 PSN-IRT 采用 4PL,Deep-IRT 采用 1PL;附录表 7 提供更多参数配置。因此,主表体现的是完整方法与配置的比较,不能将所有差异单独归因于某一种网络结构。
排名指标使用 Kendall 的 ,衡量两个排序的一致性。越接近 1,顺序越一致;越接近 −1,顺序越相反。论文中有两种不同用途:表 2 比较不同测试子集导出的模型能力排名,表 6 比较题目子集排名与 Arena 外部参考排名。两者检验的问题不同。
实验一:能否预测答对,以及排名是否稳定
这个实验先检验估计方法是否能较好地解释留出的答题结果。输入是某个模型与题目的标识,输出是答对概率;通过 ACC、F1 和 AUC 评价预测结果。
作者还将测试集划分为两个子集,分别估计模型能力,再计算两份排名的 Kendall 。如果题目子集变化后,模型排序仍较一致,就说明该比较中的排名具有较好的稳定性。原论文第 4 页。
表 2|不同估计方法的正确性预测与模型排名稳定性。 来源:原论文第 5 页;数值按原表转录。
| 模型 | IRT 形式 | 估计方法 | ACC | F1 | AUC | Kendall τ |
|---|---|---|---|---|---|---|
| IRT | 4PL | MLE | 0.7211 | 0.8034 | 0.7012 | 0.9697 |
| IRT | 4PL | MCMC | 0.7070 | 0.7811 | 0.7278 | 0.9697 |
| IRT | 4PL | VI | 0.7201 | 0.8015 | 0.6940 | 0.9091 |
| IRT | 4PL | VIBO | 0.7188 | 0.8007 | 0.7055 | 0.9697 |
| Deep-IRT | 1PL | 深度学习 | 0.7974 | 0.8516 | 0.8519 | 0.9697 |
| PSN-IRT | 4PL | 深度学习 | 0.7998 | 0.8538 | 0.8485 | 1.0000 |
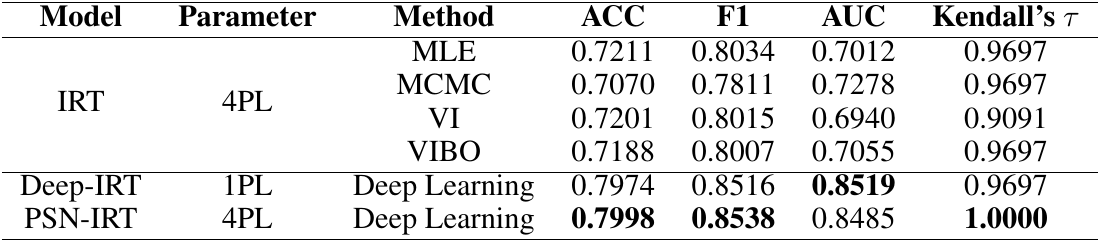
在表 2 中,PSN-IRT 的 ACC 为 0.7998、F1 为 0.8538,均高于所列传统 IRT 方法;与 Deep-IRT 相比,ACC 高出 0.0024,即 0.24 个百分点,F1 高出 0.0022。PSN-IRT 的 AUC 为 0.8485,低于 Deep-IRT 的 0.8519,因此不能表述为它在所有预测指标上都最优。
PSN-IRT 的 Kendall 为 1.0000,表示这次子集比较的模型排序完全一致。它支持的是该实验条件下的排名稳定性,不意味着模型排名具有普遍正确性。附录表 7 也显示,部分传统 IRT 配置同样得到 1.0000。
这些结果提供了对参数估计效果的间接支持。不过,预测答对较准确,不等于每一个难度、猜测率或可答性参数都已得到独立真值验证;该实验没有提供这些属性的人工标准答案。
实验二:加入语义表示和图网络会怎样
作者比较了原始设计与两个变体。Embedding 变体使用 Instructor-XL 生成题目文本的语义向量,替代题目 one-hot 标识;GNN 变体通过图结构聚合模型和题目的交互信息。原论文第 4 页及附录 A.2。
表 3|输入表示和网络结构的消融实验。 来源:原论文第 5 页;数值按原表转录。
| 方法 | ACC | F1 | AUC | Kendall τ |
|---|---|---|---|---|
| PSN-IRT | 0.7998 | 0.8538 | 0.8485 | 1.0000 |
| + Embedding | 0.7808 | 0.8413 | 0.8310 | 0.9394 |
| + GNN | 0.7928 | 0.8490 | 0.8197 | 0.7273 |
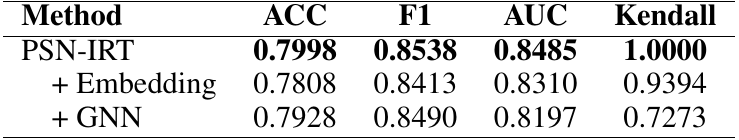
在这组实验中,两种变体都没有超过原始 PSN-IRT。尤其是 GNN 的排名一致性从 1.0000 降至 0.7273。作者解释,题目文本语义相似并不保证测量属性相似,而邻居聚合可能削弱个体模型和题目的统计特征。
这里应区分观察结果与机制解释:表格直接支持的是这两个具体变体表现较低;关于语义和聚合机制为何影响性能,是作者提出的解释。结果不支持“语义信息对所有测评都无用”或“GNN 不适合全部 IRT 任务”等普遍结论。
实验三:换一部分题目,参数还一致吗
作者随机抽取 30%、50%、70% 的题目,分别重新训练 PSN-IRT,并将共同题目在子集上的参数估计与完整数据上的估计进行比较,计算 Pearson 相关系数。该实验检验题目池变化后,参数的相对变化是否仍保持一致。
表 4|随机题目子集与完整数据估计之间的 Pearson 相关系数。 来源:原论文第 5 页;数值按原表转录。
| 题目比例 | 难度 b | 区分度 a | 猜测率 c | 可答性 d |
|---|---|---|---|---|
| 30% | 0.9009 | 0.8186 | 0.8274 | 0.9025 |
| 50% | 0.7437 | 0.7835 | 0.8776 | 0.9330 |
| 70% | 0.9519 | 0.7414 | 0.8320 | 0.9442 |
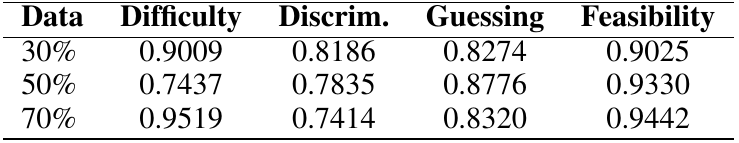
相关系数范围为 0.7414 至 0.9519;原表注明所有相关性均达到 。例如,30% 子集中的难度与完整数据估计之间的相关系数为 0.9009。
这支持所报告抽样条件下参数具有较高相关性。但 Pearson 相关不能证明参数绝对值相等,也不能证明它们就是题目的真实属性。表中相关系数并未随题目比例增加而全部单调上升,例如区分度一列从 0.8186 变为 0.7835,再变为 0.7414。
实验四:用参数诊断现有 benchmark
这一阶段在完整响应矩阵上训练模型,获得题目属性,然后比较各数据集。它关注测评数据集的性质,而不是训练一个新的问答大模型。
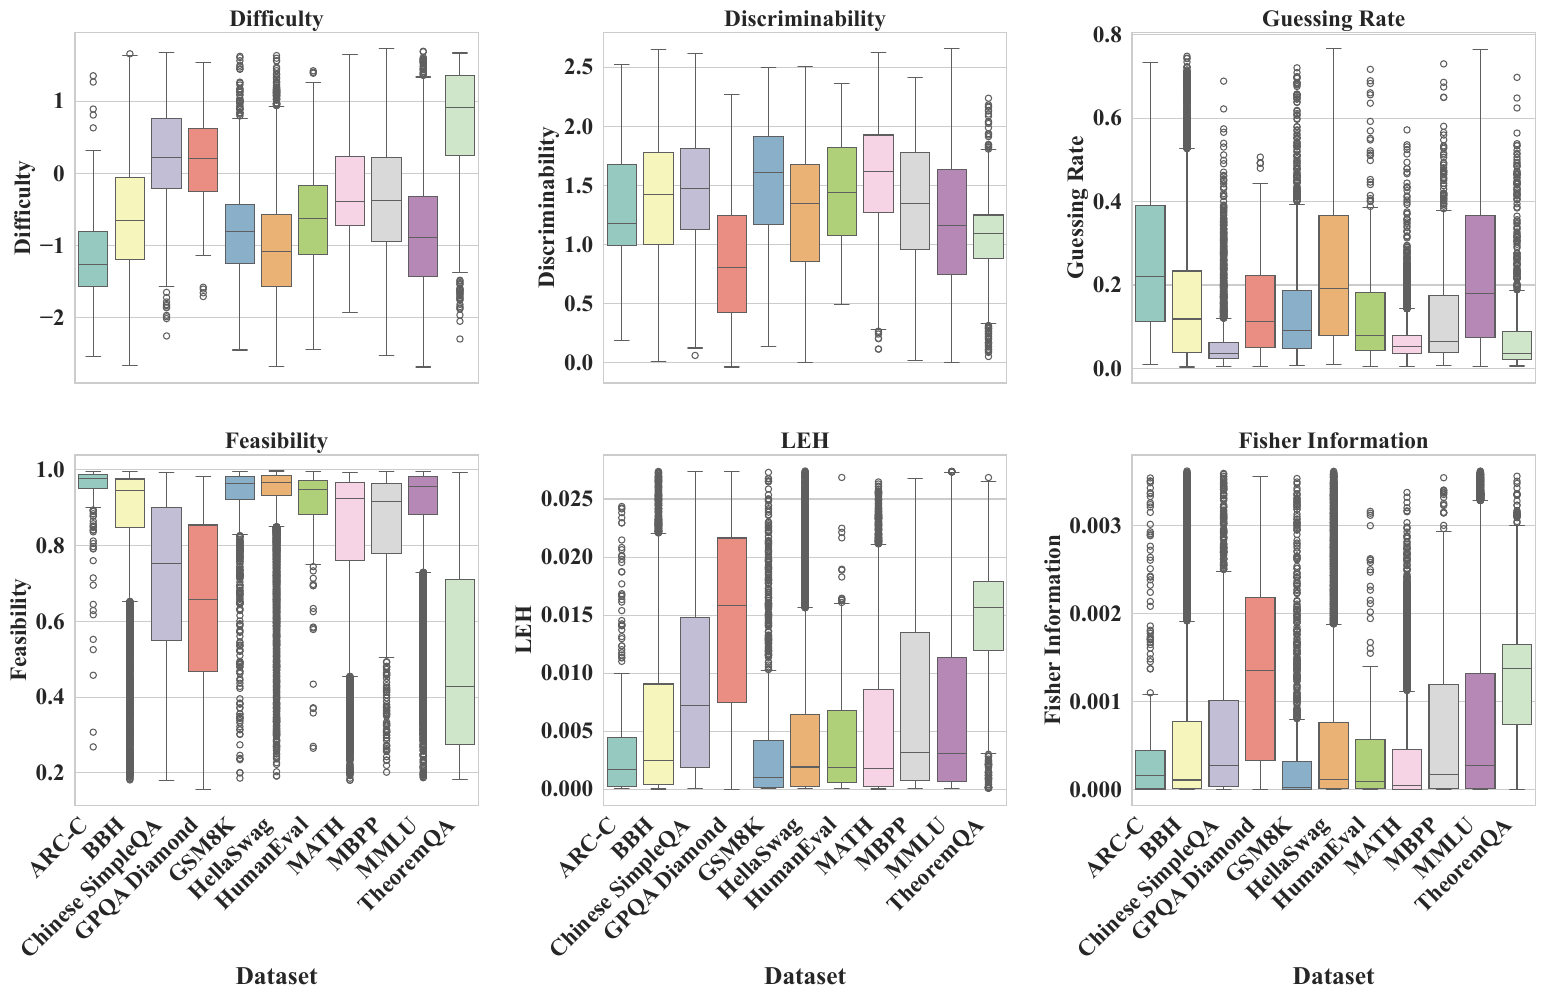
图 3|11 个测评数据集的六类题目属性分布。 六个面板依次展示难度、区分度、猜测率、可答性、LEH 和 Fisher 信息,刻画数据集内部的分布差异。 来源:原论文第 7 页。
图 3 的箱线图展示了数据集内部题目属性的分布。阅读时需要同时观察中位数、分布宽度和离群点;平均值或单一名次无法描述全部题目。不同面板的纵轴不同,不能直接将它们的高度相互比较。
表 5|根据题目属性均值得到的数据集相对排名。 来源:原论文第 6 页;数值按原表转录。
| 数据集 | 难度 | 区分度 | 猜测率 | 可答性 | LEH | Fisher | 排名之和 |
|---|---|---|---|---|---|---|---|
| Chinese SimpleQA | 2 | 3 | 1 | 9 | 3 | 5 | 23 |
| TheoremQA | 1 | 10 | 3 | 11 | 2 | 2 | 29 |
| MBPP | 5 | 6 | 4 | 8 | 4 | 4 | 31 |
| MATH | 4 | 1 | 2 | 7 | 7 | 10 | 31 |
| GPQA Diamond | 3 | 11 | 6 | 10 | 1 | 1 | 32 |
| BBH | 6 | 5 | 8 | 6 | 6 | 7 | 38 |
| MMLU | 9 | 9 | 9 | 5 | 5 | 3 | 40 |
| GSM8K | 8 | 2 | 5 | 3 | 11 | 11 | 40 |
| HumanEval | 7 | 4 | 7 | 4 | 9 | 9 | 40 |
| HellaSwag | 10 | 7 | 10 | 2 | 8 | 6 | 43 |
| ARC-C | 11 | 8 | 11 | 1 | 10 | 8 | 49 |
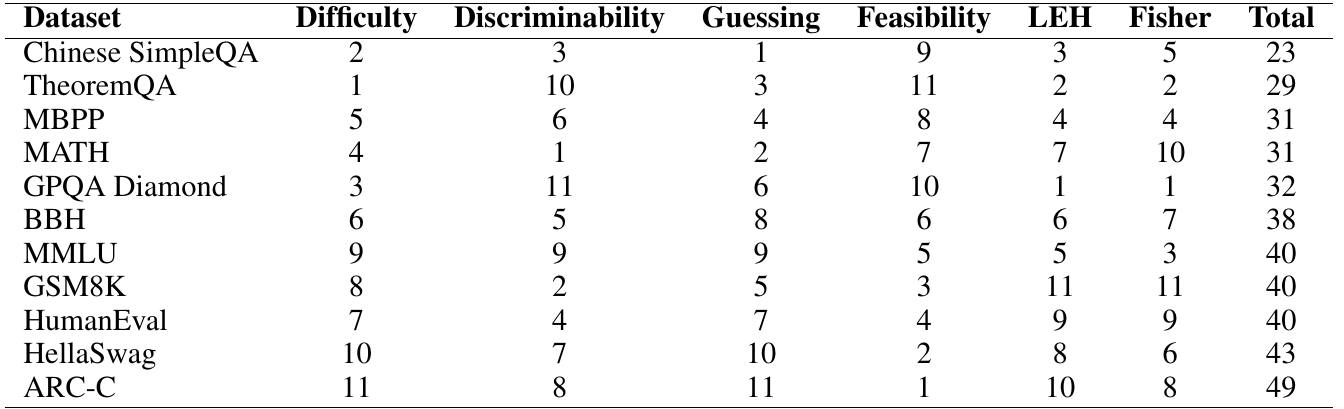
表 5 先对每个数据集的各项属性取均值,再根据作者采用的评价方向排序;每列名次越小,表示在该项标准下排名越靠前。“排名之和”是六个名次的相加,例如 Chinese SimpleQA 为 23,排在该汇总表首位。
这个总和是基于名次的汇总,不能当作具有统一物理含义的质量分数,也不表示 Chinese SimpleQA 对所有评测目标都最好。它同时在可答性一列排第 9;TheoremQA 在难度排第 1,在区分度排第 10,在可答性排第 11。不同属性之间存在取舍。
9.1 难度与剩余测量空间
作者认为,部分现有题目相对当前高能力模型已经偏容易,其 ICC 在强模型能力附近趋于平坦,因而 LEH 较低。这个诊断针对论文所选模型、题目和估计尺度,不能外推为“所有 benchmark 对全部未来模型都已失效”。
难度参数也不存在“1.0 是最大值”的规定。图 5 的示例就包含难度 1.7275 的题目。难度高低需要与目标模型能力放在同一估计尺度上比较,而不是采用未经定义的统一阈值。
9.2 高猜测率作为污染风险线索
ARC-C、HellaSwag、MMLU 的猜测率估计相对较高,作者指出选择题形式可能是影响因素之一;对异常高猜测率题目,也提出可能存在数据污染风险的解释。
这里的“数据污染”指评测题目或答案可能曾出现在模型训练资料中。但高 本身不能确认具体模型看过具体题目;选项线索、捷径、模型集合差异以及参数拟合也可能影响估计。论文提供的是需要进一步调查的线索,没有完成对预训练数据的逐题溯源验证。原论文第 6 页。
9.3 低可答性作为题目复核线索
TheoremQA 和 GPQA Diamond 的可答性估计相对较低。作者将其解释为可能与复杂科学背景、问题描述不充分或题目歧义有关。
由于 是高能力端答对概率的估计上限,低值说明拟合曲线存在较低上限,并不单独证明题目无解。模型能力覆盖、参考答案、判分规则以及任务与单维能力假设的匹配情况,也需要检查。更稳妥的应用是将低 题目列为人工复核候选。原论文第 6 页。
9.4 难度与区分度的关系
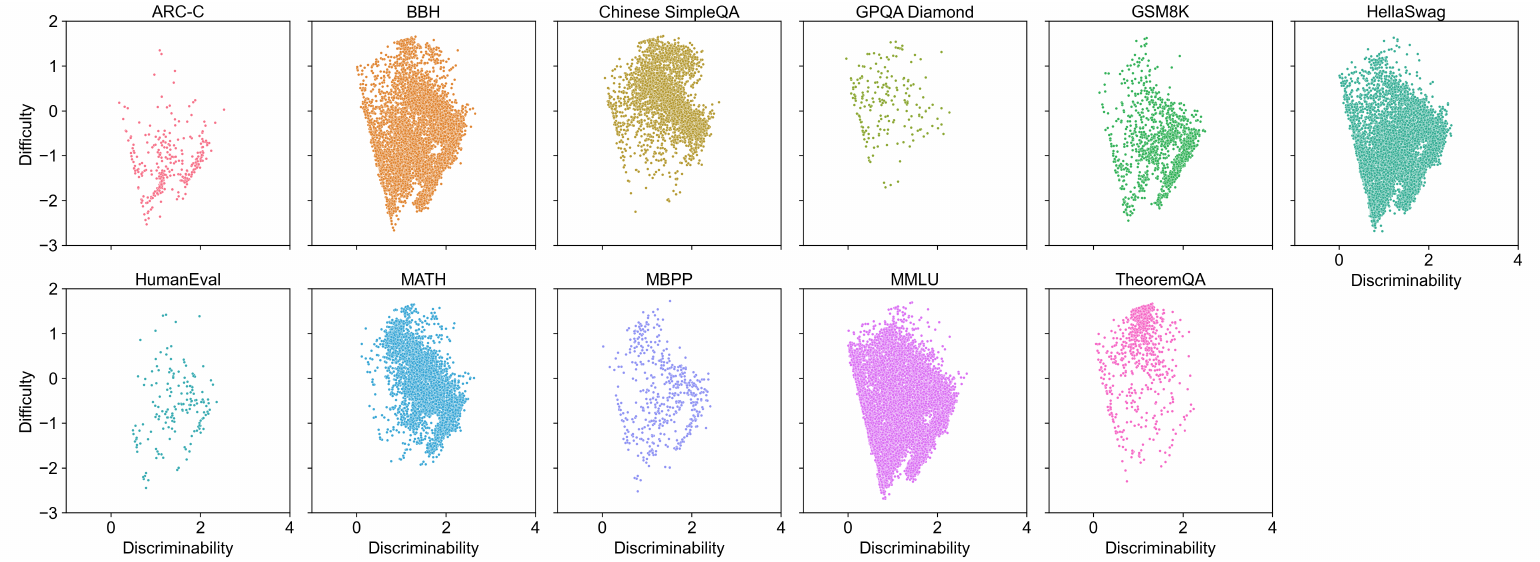
图 4|题目难度与区分度的关系。 各散点图对应一个数据集;每个点对应一道题,横轴为区分度,纵轴为难度。 来源:原论文第 12 页。
作者根据这些散点分布讨论:在部分数据集中,难度处于较极端位置的题目,其区分度也可能较低。MATH、GSM8K 的平均区分度较高,而 GPQA Diamond、TheoremQA 较低。
这些图反映的是该响应数据和估计方法中的关联,不能据此断言提高难度必定降低区分度。对于不同能力群体,同一道题提供的测量信息也可能不同。附录 B.3,第 11—12 页。
9.5 单道题目的案例
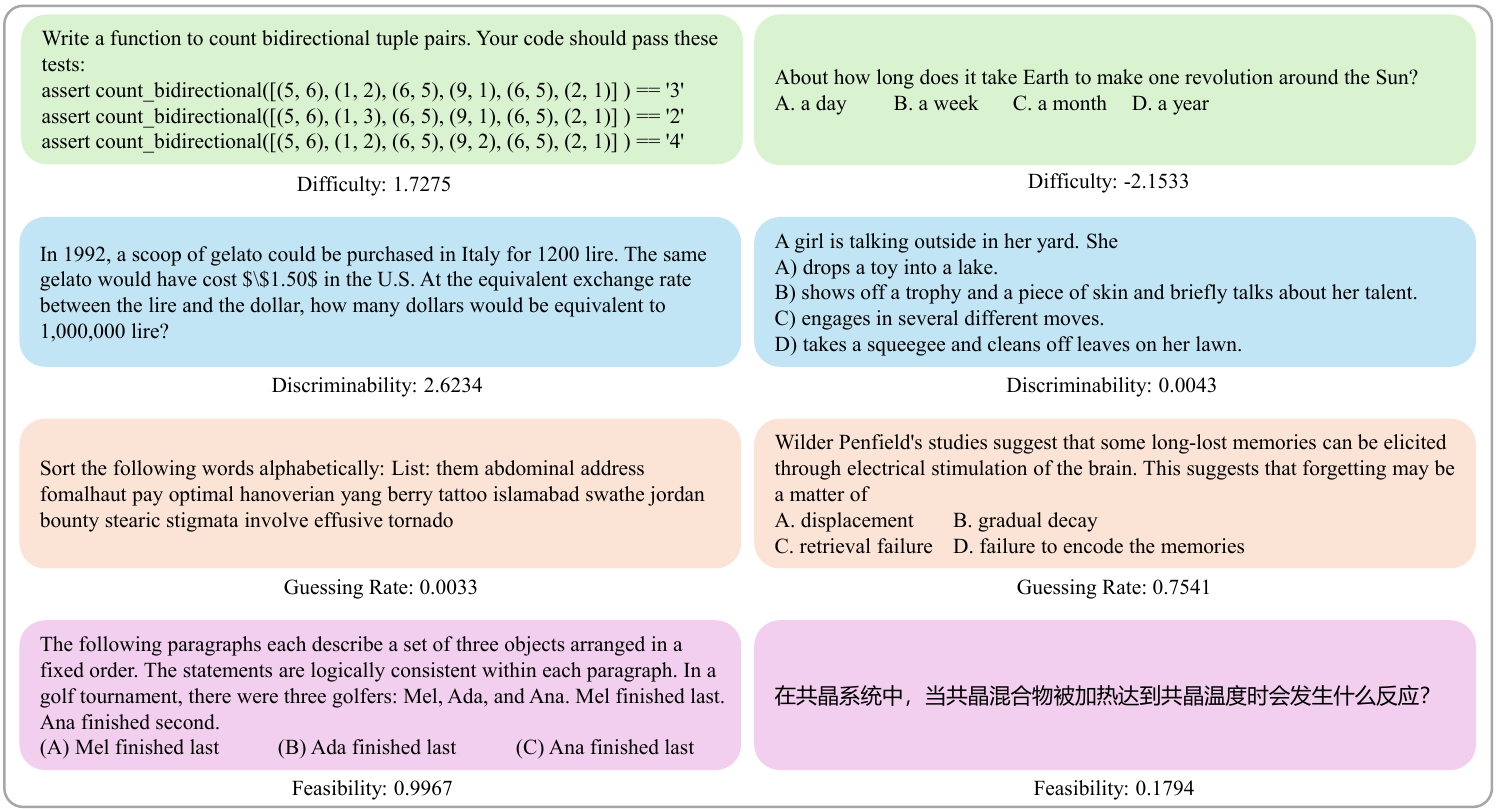
图 5|四种题目参数的高值与低值案例。 每一行呈现一对参数估计值不同的题目,用于说明难度、区分度、猜测率和可答性的含义。 来源:原论文第 13 页。
图 5 依次展示四组案例。代码题与地球公转事实题的难度估计分别为 1.7275 和 −2.1533;定量推理题与常识推断题的区分度分别为 2.6234 和 0.0043;字母排序题与记忆研究选择题的猜测率分别为 0.0033 和 0.7541;逻辑排列题与共晶系统问答的可答性分别为 0.9967 和 0.1794。
这些案例使参数含义更加具体,但它们仍是从实验答题记录估计得到的值。它们不能替代对代码测试正确性、参考答案质量、题目信息完整性或模型训练来源的独立审查。
实验五:较少的题目能否得到更一致的排名
这个实验使用 Chatbot Arena 与 OpenCompass Arena 两个公开榜单的结果构建参考模型排名,再比较不同题目选择方法得到的排名与其一致程度。该参考反映人类评价与偏好,是一种外部比较基准,不等于所有任务中唯一正确的能力顺序。原论文第 6—7 页。
作者比较完整题集,以及 400 题和 1000 题的子集。选择方法包括 Random(随机选择)、Clustering(聚类选择)、Discrim.(按区分度选择)和 Fisher(按 Fisher 信息选择)。同时设置包含弱模型和排除弱模型两种比较条件,以检验对强模型的区分情况。
表中的方差描述各模型分数的分散程度,Kendall 描述与外部参考排名的一致性。较大的分数差距与正确排序之间没有简单等价关系,需要同时查看。
表 6|不同选题策略的模型分数方差及与 Arena 参考排名的一致性。 来源:原论文第 6 页;数值按原表转录。
| 题目规模 | 策略 | 含弱模型:方差 | 含弱模型:τ | 排除弱模型:方差 | 排除弱模型:τ |
|---|---|---|---|---|---|
| 全部 | All | 0.0434 | 0.6444 | 0.0010 | 0.2381 |
| 400 | Random | 0.0421 | 0.6444 | 0.0007 | 0.2381 |
| 400 | Clustering | 0.0308 | 0.6000 | 0.0058 | 0.1429 |
| 400 | Discrim. | 0.1841 | 0.5556 | 0.0000 | 0.2381 |
| 400 | Fisher | 0.0049 | 0.6889 | 0.0033 | 0.7143 |
| 1000 | Random | 0.0406 | 0.6444 | 0.0009 | 0.2381 |
| 1000 | Clustering | 0.0166 | 0.6444 | 0.0041 | 0.2381 |
| 1000 | Discrim. | 0.1805 | 0.6000 | 0.0000 | 0.3813 |
| 1000 | Fisher | 0.0039 | 0.6889 | 0.0030 | 0.9048 |
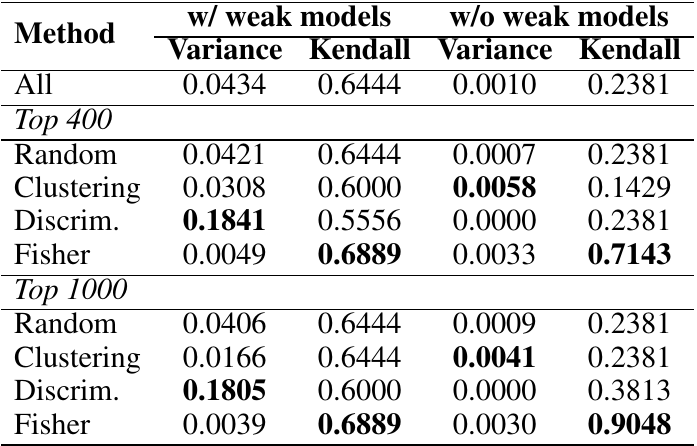
在排除弱模型条件下,全部题目的 为 0.2381;随机选 1000 题仍为 0.2381;Fisher 选 400 题为 0.7143,选 1000 题为 0.9048。这个结果支持:在这次比较中,按 Fisher 信息挑选的小题集与 Arena 参考排名更一致。
在包含弱模型条件下,Fisher 的 400 题和 1000 题方案都为 0.6889,全部题目与随机方案为 0.6444。两种模型条件下的提升幅度不同,不能只引用最高的 0.9048 来概括所有设置。
Clustering 在排除弱模型的 400 题设置中具有较大的分数方差 0.0058,但排名一致性为 0.1429。按区分度选题的部分方差显示为 0.0000,该显示值受原表保留小数位数影响。由此可见,题目能否把分数拉开、能否准确估计目标能力、能否与外部参考顺序一致,是需要分别检查的性质。
1000 题约为 41,871 题的 2.4%。这描述的是子集题量比例,不能写成“完整流程仅需原来 2.4% 的成本”:题目参数的初始标定依赖已有完整评测记录,计算和重新标定的成本也需考虑。论文结果尚不能证明该子集对后续所有新模型都维持相同表现。
附录完整结果:参数配置与数据集均值
11.1 不同 IRT 参数配置
1PL 主要包含题目难度;2PL 加入区分度;3PL 进一步加入下渐近线参数;4PL 还加入上渐近线参数。增加参数能够描述更多曲线形状,也增加了估计问题的复杂度。
表 7|1PL 至 4PL 的完整方法比较。 来源:原论文第 11 页;数值按原表转录。
| 模型 | 方法 | IRT 形式 | ACC | F1 | AUC | Kendall τ |
|---|---|---|---|---|---|---|
| IRT | MLE | 1PL | 0.7219 | 0.8035 | 0.6970 | 1.0000 |
| IRT | MLE | 2PL | 0.7172 | 0.7998 | 0.6963 | 0.9091 |
| IRT | MLE | 3PL | 0.7218 | 0.8031 | 0.7057 | 0.9697 |
| IRT | MLE | 4PL | 0.7211 | 0.8034 | 0.7012 | 0.9697 |
| IRT | MCMC | 1PL | 0.7168 | 0.8011 | 0.7268 | 0.9697 |
| IRT | MCMC | 2PL | 0.7232 | 0.8130 | 0.7301 | 0.9697 |
| IRT | MCMC | 3PL | 0.7172 | 0.8081 | 0.7297 | 1.0000 |
| IRT | MCMC | 4PL | 0.7070 | 0.7811 | 0.7278 | 0.9697 |
| IRT | VI | 1PL | 0.7209 | 0.8024 | 0.6822 | 0.9697 |
| IRT | VI | 2PL | 0.7198 | 0.8012 | 0.6938 | 1.0000 |
| IRT | VI | 3PL | 0.7189 | 0.8011 | 0.6956 | 0.9697 |
| IRT | VI | 4PL | 0.7201 | 0.8015 | 0.6940 | 0.9091 |
| IRT | VIBO | 1PL | 0.7007 | 0.7801 | 0.6901 | 0.9697 |
| IRT | VIBO | 2PL | 0.7301 | 0.8048 | 0.6987 | 0.8788 |
| IRT | VIBO | 3PL | 0.7172 | 0.7993 | 0.7048 | 0.9091 |
| IRT | VIBO | 4PL | 0.7188 | 0.8007 | 0.7055 | 0.9697 |
| Deep-IRT | 深度学习 | 1PL | 0.7974 | 0.8516 | 0.8519 | 0.9697 |
| PSN-IRT | 深度学习 | 1PL | 0.7948 | 0.8497 | 0.8473 | 0.9091 |
| PSN-IRT | 深度学习 | 2PL | 0.7560 | 0.8266 | 0.8259 | 0.9697 |
| PSN-IRT | 深度学习 | 3PL | 0.7965 | 0.8510 | 0.8510 | 0.8788 |
| PSN-IRT | 深度学习 | 4PL | 0.7998 | 0.8538 | 0.8485 | 1.0000 |
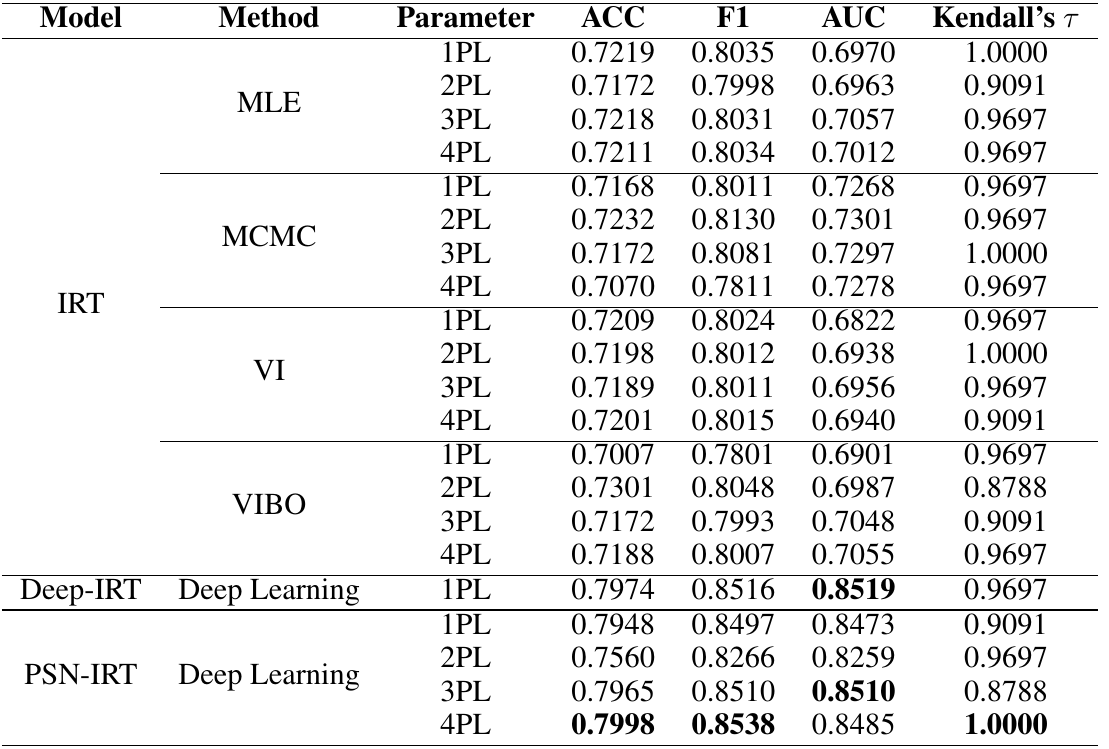
在 PSN-IRT 的四种配置中,4PL 的 ACC 和 F1 最高,AUC 则低于其 3PL 配置的 0.8510。Deep-IRT 的 AUC 为 0.8519,是该完整表中的最高值。传统 IRT 中,性能也没有随参数数目增加而统一提升。
此外,MLE-1PL、MCMC-3PL、VI-2PL 的 Kendall 同样为 1.0000。因此,可以说 PSN-IRT-4PL 在作者报告的多项指标上具有竞争力,不能说只有这一方法能产生稳定排名。附录 B.1,第 10—11 页。
11.2 各数据集的题目属性均值
表 8|各数据集的题目属性均值。 来源:原论文第 11 页;数值按原表转录。
| 数据集 | 难度 b | 区分度 a | 猜测率 c | 可答性 d | LEH | Fisher |
|---|---|---|---|---|---|---|
| ARC-C | -1.1637 | 1.2822 | 0.2621 | 0.9481 | 0.0041 | 0.0005 |
| BBH | -0.6033 | 1.3845 | 0.1657 | 0.8747 | 0.0057 | 0.0006 |
| Chinese SimpleQA | 0.2656 | 1.4474 | 0.0609 | 0.7088 | 0.0089 | 0.0006 |
| GPQA Diamond | 0.1902 | 0.8598 | 0.1518 | 0.6437 | 0.0142 | 0.0014 |
| GSM8K | -0.7899 | 1.5255 | 0.1491 | 0.9167 | 0.0038 | 0.0004 |
| HellaSwag | -1.0353 | 1.2920 | 0.2449 | 0.9304 | 0.0047 | 0.0006 |
| HumanEval | -0.6351 | 1.4459 | 0.1565 | 0.8957 | 0.0046 | 0.0005 |
| MATH | -0.2396 | 1.5793 | 0.0673 | 0.8290 | 0.0054 | 0.0004 |
| MBPP | -0.3456 | 1.3625 | 0.1345 | 0.8221 | 0.0071 | 0.0007 |
| MMLU | -0.8383 | 1.1968 | 0.2381 | 0.8921 | 0.0067 | 0.0008 |
| TheoremQA | 0.6548 | 1.0656 | 0.0888 | 0.5012 | 0.0145 | 0.0013 |
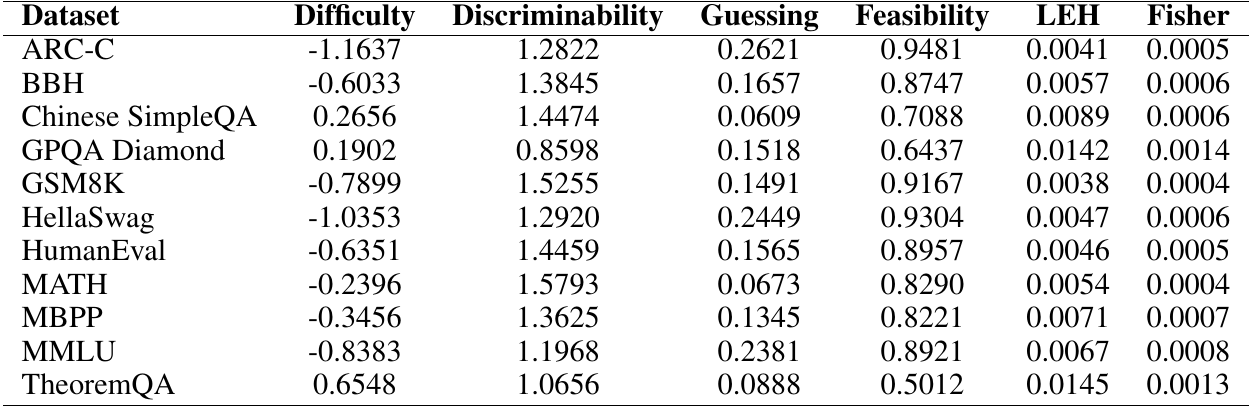
表 8 给出了均值尺度的信息。例如 TheoremQA 的平均难度为 0.6548,ARC-C 为 −1.1637;这表示它们在该模型估计尺度上的相对位置,不代表难度是 65.48% 或 −116.37%。TheoremQA 的平均可答性为 0.5012,也不能理解为已人工确认只有一半题目可解。
**原文一致性说明:**表 5 将 GPQA Diamond 与 TheoremQA 的 LEH 名次分别列为第 1 和第 2;表 8 的 LEH 均值却分别为 0.0142 和 0.0145。若按较大 LEH 排名,这两个顺序不一致,论文没有在相应位置解释原因。本文保留两张表的原始报告值,不自行改写名次;需要精确引用这两个数据集的 LEH 排序时,应进一步核验作者数据或实现。
局限与适用边界
这篇论文说明,逐题响应数据可以提供比整体正确率更丰富的测量分析。在所报告实验中,PSN-IRT 能预测留出交互的答对情况,产生较稳定的排名,并为题目筛选提供可用信号。将它作为测评诊断工具时,还需要保留以下边界。
- **参数依赖模型群体与估计尺度。**本文的题目属性由所选 12 个模型及其答题结果共同估计。更换模型群体、提示设置或判分方式后,不能默认参数保持不变。
- **跨领域能力被压缩为单一参数。**一个模型可能擅长代码而不擅长知识问答,单维 无法完整表达能力结构。多维 IRT 或分领域分析属于可以进一步检验的方向。
- **参数有解释性,但并非独立验证的真值。**高猜测率提示进一步调查,低可答性提示复核候选;具体污染、歧义或答案错误的判断仍需独立证据。
- **测试划分与新对象泛化需要区分。**交互记录留出实验不等于全新模型、全新题目或未来模型的可靠泛化验证;原始 one-hot 路径对新题目需要重新训练。
- **外部参考排名有任务范围。**Arena 反映公开人类评价与偏好。与其更加一致,是相对于该参考的结果,不能直接外推为专业任务、生产使用或所有能力上的排序更准确。
- **数值差距缺少完整不确定性报告。**主结果表未提供多随机种子重复实验的置信区间,不能把每一个小幅数值差距都称为统计显著提升。表 4 报告的相关性检验也不能转用于其他结果表。
对于评测设计,论文给出的可操作启示是:先明确要区分哪些能力范围的模型,再考察题目在该范围内的信息量;异常参数可作为复核线索;选题策略应同时检验排名、覆盖范围和标定成本。题量、难度与分数差距都无法单独代表测评质量。
全部图表索引与来源
正文保留图 1 至图 5、表 1 至表 6;附录保留表 7、表 8。本文已全部纳入:图 1 榜单示例(第 1 页)、图 2 方法流程(第 3 页)、图 3 属性分布(第 7 页)、图 4 难度与区分度散点(第 12 页)、图 5 题目案例(第 13 页);表 1—4(第 5 页)、表 5—6(第 6 页)、表 7—8(第 11 页)。以上页码指该版本 PDF 页码。
全部图表图像均来自 Hongli Zhou 等作者的原论文,图像以原始内容裁切,仅转换文件格式;中文图注为内容说明,表格转录保留原始数值和小数精度。原图中的英文、加粗及案例内容可通过各图表的大图链接核对。本文对诊断含义和证据边界的解释与原始报告值分开陈述。
主要来源:论文 arXiv v3、论文 PDF、DOI、PSN-IRT 官方仓库。文中相关工作链接用于补充研究背景,实验数据以本论文对应版本为准。
See also
- PCFNet 论文解读:用频域特征与物理约束预测海表温度 2026-10-28
- AutoPrune 论文解读:让 LLM 设计视觉 Token 剪枝规则 2026-10-22
- OFA-MAS 论文精读:一个通用模型,怎样为不同任务选择智能体并生成协作图 2026-10-20
- M³Prune 论文精读:先组内讨论,再跨模态协作,怎样剪掉多余通信 2026-10-19
- RADAR 论文精读:扩散模型如何自动生成多智能体通信图 2026-10-19