M³Prune 论文精读:先组内讨论,再跨模态协作,怎样剪掉多余通信
给一张飞机照片,询问它的首飞日期,系统需要先识别机型,再从外部资料中找到对应事件。视觉判断、资料检索和日期核对可以交给不同的 Agent,但它们交换的信息也可能带来重复和干扰。正确资料已经被检索到,并不意味着团队最终一定会选择它。
M³Prune 研究怎样减少这种通信冗余。它把多模态多智能体系统表示成通信图,先学习文本组、视觉组各自内部的连接,再学习两组之间的连接;训练中逐步关闭低价值通道,推理时使用得到的剪枝图。
本文依据所提供的 20 页论文 PDF,保留原图编号、页码和实验数值,并用明确标注的教学算例解释数学表达。实验结果均为论文报告,未独立重跑;公开仓库仅作为作者提供的实现入口,本文不声称完成逐行代码核验。
论文信息与阅读路线
| 项目 | 信息 |
|---|---|
| 题目 | M3Prune: Hierarchical Collaborative Pruning for Efficient Multi-Modal Multi-Agent Retrieval-Augmented Generation |
| 作者 | Taolin Zhang、Weizi Shao、Zijie Zhou、Chen Chen、Daiyang Yu、Tingyuan Hu、Chengyu Wang、Xiaofeng He |
| 阅读版本 | 20 页 PDF,含方法、实验和附录 |
| PDF 标注信息 | MM ’26;DOI:10.1145/3767308.3836330 |
| 来源链接 | DOI(按 PDF 标注)、作者代码仓库 |
| 相关精读 | AgentPrune:学习谁该听谁、SafeSieve:从角色判断到合作经验 |
先把三个对象分开:Agent 生成内容,软连接矩阵记录可学习分数,二值邻接矩阵与掩码决定哪些消息允许传递。本文的剪枝对象主要是 Agent 之间的通信边。
阅读方法部分时,可以依次追踪四个问题:给谁传消息、如何给连接打分、怎样根据任务表现调整分数、什么时候把连接真正关闭。
1. 图1:为什么检索到正确答案,仍然可能答错
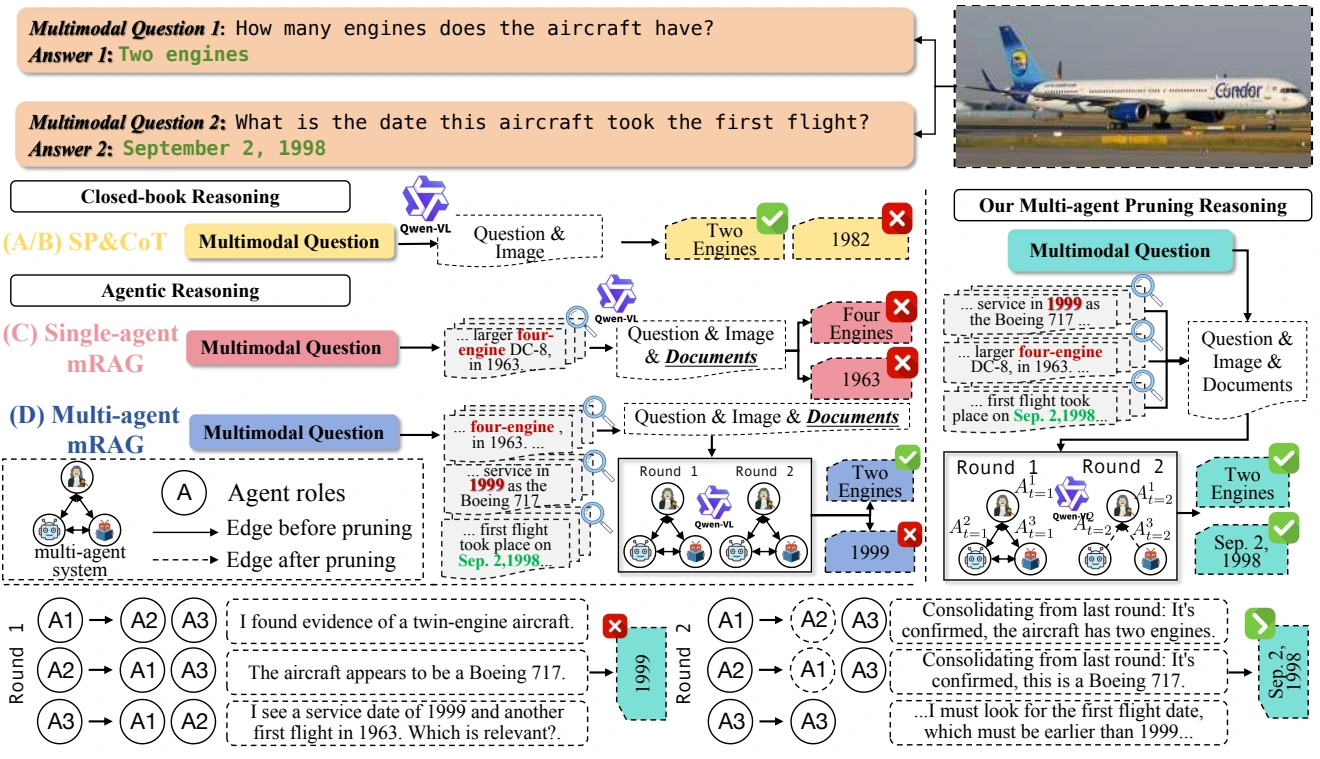
图1,PDF 第2页。左侧依次展示闭卷推理、单智能体 mRAG、多智能体 mRAG,右侧为作者提出的通信剪枝方式。图片可点击查看原尺寸。
图中针对同一张飞机照片提出两个问题:它有几个发动机,以及它何时首飞。发动机数量可以从视觉线索判断,首飞日期通常还需要外部知识。mRAG 即多模态检索增强生成,将问题、图片与检索资料共同交给多模态大模型处理。
单个 Agent 需要同时识图、理解资料、分辨事件和整合答案。多个 Agent 可以分工,但图中的固定通信方案仍混淆了几个事实:1999 年是投入运营的时间,1963 年对应其他机型的线索,1998 年 9 月 2 日才是示意问题需要的首飞日期。
关键矛盾是:不同 Agent 把机型、发动机数量和各种日期不断相互转发,未必能帮助日期判断。重复或冲突的消息会增加上下文长度,也可能带偏后续分析。
图1是说明问题的示意案例。它支持作者的研究动机,但不能单独作为剪枝效果的统计证据。实际效果还要看后面的数据集实验。
2. 图2:先优化模态内部,再优化跨模态通信
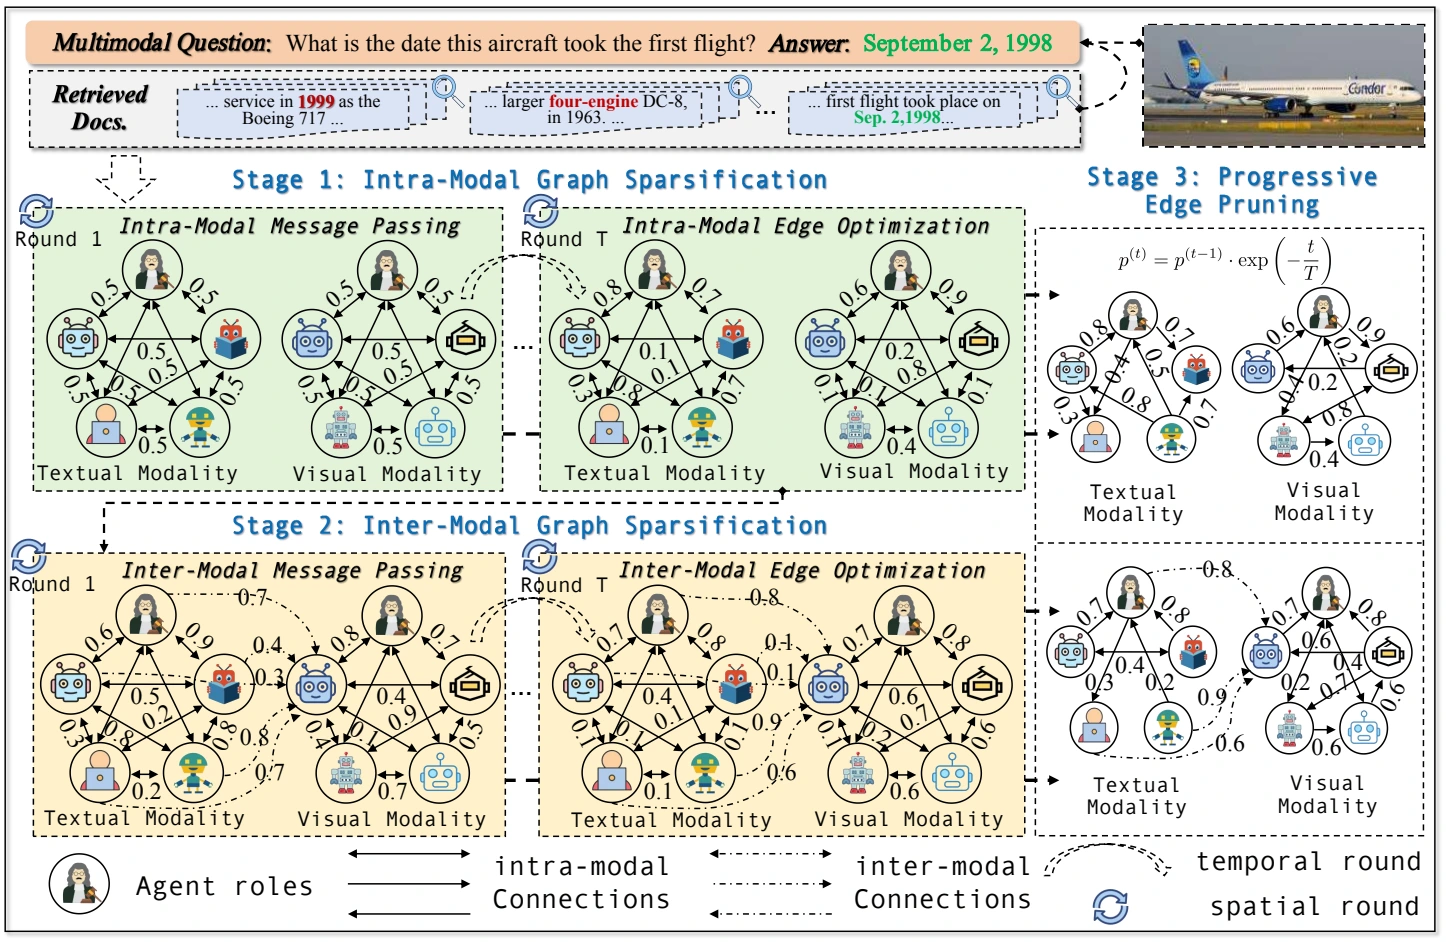
图2,PDF 第5页。绿色区域为模态内图稀疏化,黄色区域为模态间图稀疏化,右侧展示渐进式边剪枝。跨模态连接数量较多,作者只画出部分连接作为示意。
绿色区域先处理两个组:文本 Agent 之间交流,视觉 Agent 之间交流,并分别学习各自内部哪些连接更有用。
黄色区域继承前面的模态内结构,再加入文本到视觉、视觉到文本的双向连接,学习哪些跨模态交流值得保留。进入这一阶段后,模态内部的连接仍存在,两类信息可以共同参与推理。
右侧的剪枝操作在训练中逐步关闭低分边。附录 Algorithm 1 将训练分为两个核心阶段:模态内优化与剪枝、跨模态优化与剪枝。图2把剪枝单独画出,用于说明它怎样改变结构。
这里的先后明确对应通信图的训练与优化流程。论文 §4.3 说明,推理时使用训练后得到的剪枝图,不能直接把图2读成每道新问题都要重新训练并剪一次图。
3. 模态内、跨模态,与Spatial、Temporal是两个划分维度
模态内和跨模态回答“信息在哪些类型的成员之间流动”;Spatial 和 Temporal 回答“信息属于同一轮,还是跨轮传递”。两组概念可以组合。
| 连接类别 | Spatial:同轮 | Temporal:跨轮 |
|---|---|---|
| 模态内 | 本轮文本 A → 本轮文本 B;本轮视觉 A → 本轮视觉 B | 上轮文本 A → 下轮文本 B;上轮视觉 A → 下轮视觉 B |
| 跨模态 | 本轮视觉 A → 本轮文本 B,或反方向 | 上轮视觉 A → 下轮文本 B,或反方向 |
Temporal 还可以把 Agent 自己的上一轮结果传到下一轮。论文第3页脚注说明,初始时间连接包含跨轮的所有 Agent,也包括自身;空间连接不含同轮自连接。
例如,第一轮视觉 Agent 判断图中可能是波音 717,这个判断可以通过 Temporal 连接进入第二轮文本 Agent 的上下文,帮助它继续核对首飞资料。多轮讨论仍然在处理同一道题。
同轮交流也不要求所有成员同时发言。论文实现设置对初始空间图进行 DAG 采样,确定可执行的顺序,避免成员在同轮内相互等待尚未产生的输出。
4. 从0/1连接到连续分数:怎样读公式(3)
约定行表示接收者、列表示发送者, 表示第 个 Agent 可以向第 个 Agent 传消息,等于 0 表示不通过这一位置传递。
软邻接矩阵 则给候选连接一个连续分数。完整符号 可读为:模态 、第 轮、同轮空间连接中,从 到 的软分数。上标 、 是类别与轮次标签,不是在做乘方。
公式(3)可以拆成两行理解:
第一行构造分数,第二行进行 Softmax 归一化。, 表示把指定项加起来。归一化后的各项为正,总和为 1。
以下为教学算例。先忽略连接含义,仅对三个普通分数 进行 Softmax:
分数较大的项分到更多权重。温度 调整集中程度:在分数不全相同时,温度降低会放大差异,温度升高会让分布更平均。把上例温度改为 0.5,结果约为 。
是小正数,用来避免直接计算 。 表示随机抽取 Gumbel 噪声;括号中的 0、1 是分布参数,不是噪声取值范围。作者用这一操作初始化可学习的软邻接矩阵。
Softmax 本身不会把有限输入对应的权重直接变成零。让分数变小与真正删除连接,是后面两种不同操作。
5. 分数怎样参与消息汇总:公式(4)与(5)
论文还把软分数转换成实际聚合权重。省略模态与轮次标记后,式(5)是:
是可以给 Agent 发消息的邻居集合, 表示属于。分母将这些来源的分数取指数后相加,得到总和为 1 的分配。
教学算例中,假设 A 从 B、C 接收消息,软分数分别为 0.8、0.2。再次经过这一归一化后,权重约为 0.646、0.354。因此,连接软分数 0.8 不直接等于聚合时的 80% 权重,更不能解释成该消息有 80% 概率正确。
式(4)把汇总消息抽象写成:
是来源 Agent 的输出, 是它在接收者这里的权重。只有 B、C 时,展开为 。如果教学上暂时令 、,结果就是 。
实际 Agent 生成的是自然语言回复。正文将聚合抽象成上述加权和,没有详细说明如何对文字回复执行数值加权;不能仅凭这一公式推断具体的文本编码或拼接实现。
Temporal 消息按类似方式处理,只是来源属于上一轮。Agent 随后结合问题、检索资料、自身状态与聚合信息更新回答,经过若干轮讨论后,由 summary Agent 汇总最终结果。
6. 怎样学出有用连接:任务反馈、正则与策略梯度
优化目标同时考虑答题表现和结构约束
模态内阶段的式(6)为:
表示让后面的目标尽可能大,下面列的是允许调整的变量。 是用通信图 完成任务后的表现; 是按采样概率计算的期望表现。
教学上,若以 0.6 的概率选到得分 0.9 的图,以 0.4 的概率选到得分 0.5 的图,期望为 。这衡量采样机制整体的平均表现。
双竖线表示范数。核范数 是矩阵奇异值之和,用于约束结构;Frobenius 范数 则是所有元素平方求和再开平方。核范数鼓励低秩结构,但不直接计算非零边数,实际删边由后面的掩码完成。
式(6)还要求两种软矩阵与对应邻接矩阵的 Frobenius 偏差之和不超过 ,以限制偏离程度。这是论文提出的约束形式,不能把它视为任何实现自动满足的性能保证。
通过整张图的答题得分调整采样参数
底层 Agent 可能调用不可微的大模型 API,不能直接穿过回答生成过程求梯度。因此,作者采用策略梯度。临时用 统称软连接参数,式(7)可写为:
是梯度,表示各参数朝哪个方向变化能增加目标; 表示采样近似。 是第 张采样图, 是当前参数下选到它的概率, 是其任务得分。
流程是:采样 张图,分别运行任务并评分,再用得分加权概率梯度。在期望意义上,这会推动采样机制向更好的平均表现调整。系统获得的是整套通信方案的结果,没有逐条边的人工重要性标签。
参数按 更新, 是学习率。式(7)展示任务表现项的梯度估计,正则项等也参与最终优化。
式(8)中的 表示连乘,例如 。作者用跨轮次、跨所选边的软权重乘积表达图采样概率,时间连接部分从第2轮开始。完整概率表达依赖具体采样规则,正文该式未展开所有分布细节。
7. 跨模态阶段:协调两个方向的通信模式
第二阶段保留学到的模态内图,加入文本到视觉、视觉到文本的 Spatial 与 Temporal 连接,共四类跨模态矩阵。目标为任务表现减去结构正则,再加上模态对齐分数。
对齐项是本文一个具体设计。为便于读式(12),记同一种连接类别下:,。再用两个向量缩写对应行:,,则:
表示交换行列, 表示取第 行的全部列。、 分别是文本、视觉 Agent 数量,外面的系数用于缩放。分式是两个行向量的余弦相似度。
教学算例中,、 的点积为 0.56,向量长度分别约为 0.825、0.721,余弦相似度约为 0.942,说明两组分配模式比较接近。
这一项直接比较双向连接模式,作者希望借此促进跨模态理解的一致性。它没有直接比较两段回答的语义嵌入。虽然名称中使用 ,但它被加到最大化目标中,在这里发挥奖励作用。
8. 从小权重到真正删边:Top-K与二值掩码
训练还需要把连续分数转换成实际通信决策。式(13)的核心为:
是指示函数,条件成立返回 1,否则返回 0; 表示并且;Top-K 选择分数最高的若干位置; 表示对应位置相乘。
教学上,四个候选位置的分数为 ,若保留最高的两项,掩码为 ,与原来的 相乘后,第二、四条连接才真正关闭。条件 阻止已删除连接恢复。
原文将保留数量写成 ,并把 定义为矩阵元素数量,不能无条件将其替换成当前非零边数。这里 Top-K 的保留数量,也不同于策略梯度中采样图数量 。
剪枝率按指数衰减。为避免与讨论轮次混用,这里用 重记原文剪枝更新索引:
每次乘上的系数小于 1,所以后续步骤的剪枝力度逐渐减小。已删除边不会恢复,图仍累计变得更稀疏。教学上取 、,前两步剪枝率约为 0.303、0.112;这只是计算示例。
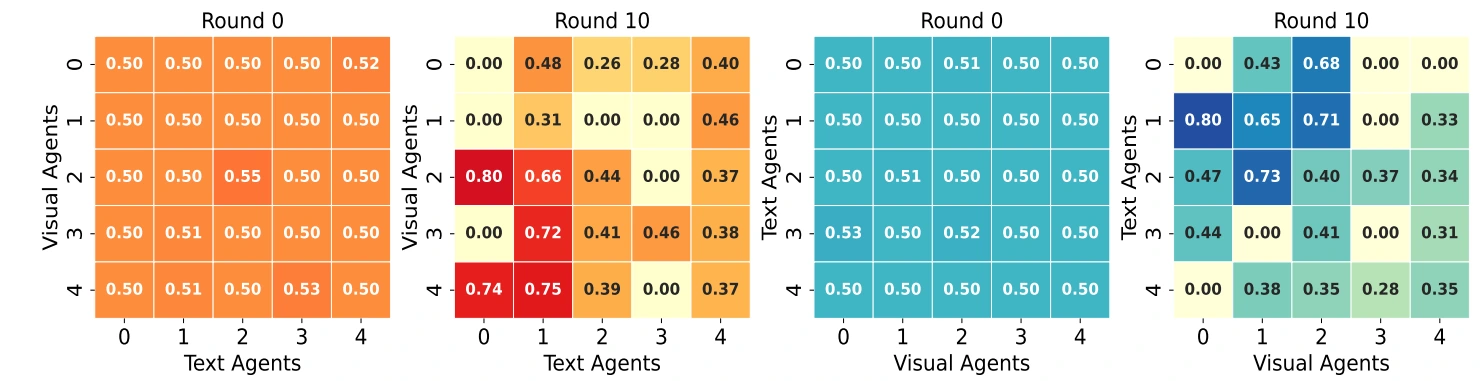
图3,PDF 第8页。左半部分为视觉到文本,右半部分为文本到视觉,展示 ScienceQA 上连接权重的演化。
初始分数比较接近,优化后部分位置得到较高权重,部分变为零。这是结构变化的可视化;热图本身不能逐条证明高分连接具有更强的因果贡献。图中演化标记也不应直接等同于默认每道题的讨论轮数,正文默认讨论轮数为2。
9. 创新定位:重点看分层通信设计
Softmax、Gumbel-Softmax、策略梯度、核范数、余弦相似度和 Top-K 都是已有工具。通信剪枝的基本问题也已有直接相关工作:本文参考文献 [48] AgentPrune 研究通信冗余,并剪枝同轮、跨轮消息传递图。
M³Prune 的方法贡献定位在多模态协作:把模态内和模态间连接分开优化,在跨模态阶段加入双向连接对齐项,并配合渐进式剪枝形成紧凑图。具体工具如何组合、这些结构选择是否带来额外收益,比公式长度更能说明研究价值。
这里描述的是作者提出的设计。判断每项设计是否严格首创,还需要与相关方法逐项比较。本文后面的实验可以检验模块是否有帮助,但不能自动完成全部新颖性论证。
10. 实验设置:三类任务、三种基础模型
| 数据集 | 测试内容 | 论文报告的测试规模 |
|---|---|---|
| ScienceQA | 结合文字与可选视觉上下文的科学选择题 | 约4,200题 |
| MultimodalQA | 从文本、图片等证据中完成问答;本文重点使用文本与图像 | 约3,660题 |
| Vidoseek | 视觉文档检索与问答,覆盖文字、表格、图表和版面等类别 | 约1,100题 |
基础模型为 Llama3.2-VL-11B、Qwen2.5-VL-7B 和 Qwen-VL-Max。默认讨论2轮,采样图数量10,学习率0.1,容忍参数0.1。ScienceQA 配置5个文本与5个视觉 Agent,Vidoseek 为4加4,MultimodalQA 为5加4。
模态内、模态间训练各使用40条样本。Vidoseek 没有官方训练集,论文使用 MultimodalQA 训练集学习其通信结构。这里的训练目标是图参数,不能理解成用40条数据从头训练一个多模态大模型。
对照组包括直接回答与 CoT、Wiki-LLaVA 等单智能体 RAG,以及 OmniSearch、ViDoRAG、HM-RAG、E-Agent 等多智能体框架。
通用任务报告 Acc* 与 EM。Acc* 由 DeepSeek-V3 对语义一致性打1至5分,达到4分计为正确。本文的 EM 将完全匹配或回答包含标准答案都计为正确,比严格逐字匹配更宽松。ScienceQA 主表报告答题准确率。
11. 主结果:总体平均提升,不代表每个子任务都占优
下表摘取表1、表2、附录表9与表10的均值。箭头左侧为对应评测中最佳多智能体基线,右侧为 M³Prune。
| 基础模型 | ScienceQA | 通用任务平均Acc* |
|---|---|---|
| Llama3.2-VL-11B | 85.39 → 86.61 | 45.69 → 48.98 |
| Qwen2.5-VL-7B | 84.60 → 87.67 | 57.49 → 66.05 |
| Qwen-VL-Max | 93.66 → 97.41 | 62.74 → 73.11 |
通用任务列的最佳基线均为 ViDoRAG。ScienceQA 中,Llama 对应 ViDoRAG,两个 Qwen 模型对应 HM-RAG。例如 Qwen-VL-Max 在 ScienceQA 提高3.75个百分点,在通用任务平均 Acc* 提高10.37个百分点。
通用任务 Average 是表中 Vidoseek 六个子类别与 MultimodalQA 两个子类别的平均值,不能当成某一个数据集的整体准确率。原表还报告了带“±”的结果,本文摘录均值以便比较,不另行推断波动项的统计定义。
平均优势没有覆盖所有单项。Llama 在 Vidoseek 单跳任务上的 M³Prune Acc* 为44.65,低于 HM-RAG 的56.72。更合适的结论是:所报告评测中,总体平均收益在三种基础模型上都出现,但幅度和任务分布不同。
12. 消融实验:哪些部件在起作用
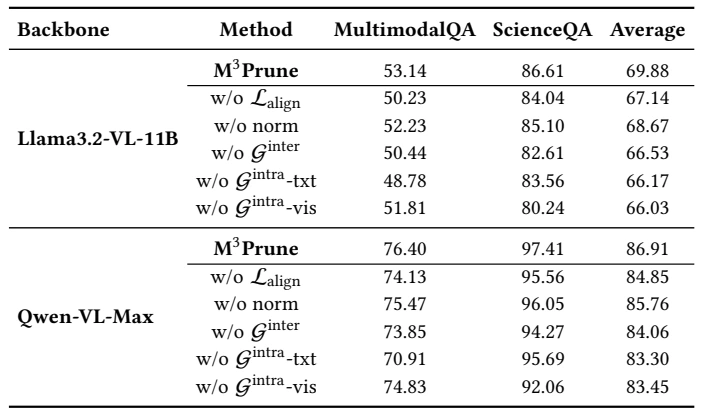
表4,PDF 第7页。w/o 表示去掉对应部分;Average 为该表两个数据集分数的平均值,其聚合范围不同于主结果表2。
以 Qwen-VL-Max 为例,完整模型的 Average 为86.91。去掉对齐项后为84.85,下降2.06个百分点;去掉范数正则后为85.76,下降1.15;关闭学习到的跨模态通信后为84.06,下降2.85。
这些结果支持对齐项、结构正则和学习到的跨模态交互对当前配置有贡献。关闭跨模态图的设置,是聚合各模态内部输出而不进行学习到的跨模态通信。
表中 w/o intra-txt 与 w/o intra-vis 的实际操作需要单独说明:作者把对应 Agent 组的输出替换成无信息回复,移除该模态的有效贡献。它们主要说明文本和视觉信息都重要,不能单独证明模态内剪枝优于其他通信策略。
依照该表,MultimodalQA 对去掉文本信息更敏感,ScienceQA 对去掉视觉信息更敏感。这是当前数据集与配置下的结果,不应扩展成所有多模态任务的固定性质。
13. 效率分析:比较准确率与token开销
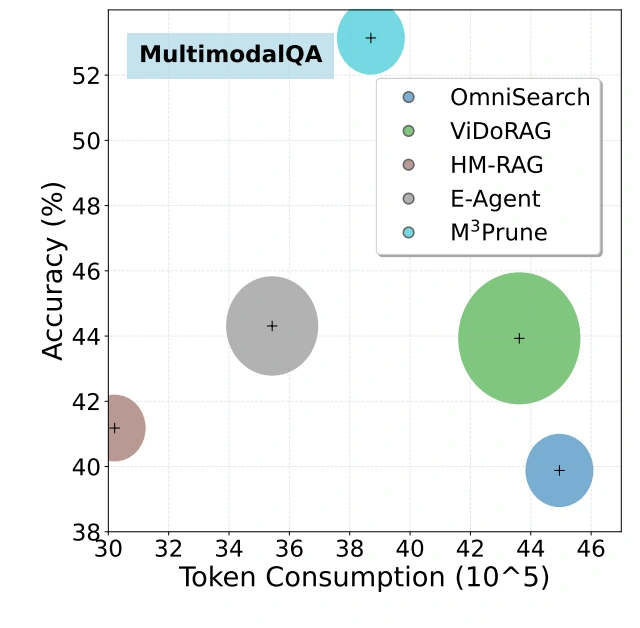
图4,PDF 第8页。Llama3.2-VL-11B 在 MultimodalQA 上的比较,token 总数包含所有 Agent 的输入与输出;附录图22、23补充其他模型和数据集。
横轴越靠左,token 消耗越小;纵轴越靠上,准确率越高。相对 OmniSearch、ViDoRAG,M³Prune 同时提高准确率并减少 token。相对 HM-RAG、E-Agent,它使用更多 token,换来更高准确率。
因此,它不是图中开销最低的方法。该图更适合说明在准确率与通信消耗之间获得更好的折中。论文使用 Acc./#Token 讨论效率,这也不直接等同于实际运行时延、GPU 时间或所有 API 的货币成本。
14. 鲁棒性分析:一个Agent提供错误信息时会怎样
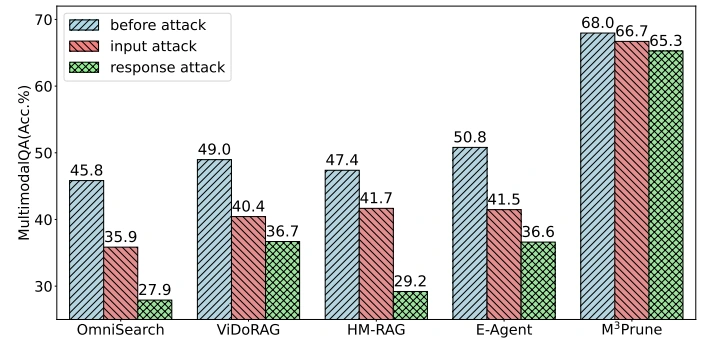
图5,PDF 第8页。正文说明在 MultimodalQA 上使用 Qwen2.5-VL-7B,分别比较无攻击、输入提示攻击和回答攻击。
输入提示攻击让一个成员忽略跨模态通信,坚持自己的判断;回答攻击让一个成员故意产生错误答案和误导性解释。图中 M³Prune 从无攻击时的68.0,降至输入攻击时的66.7、回答攻击时的65.3。回答攻击造成2.7个百分点的下降。
ViDoRAG 从49.0降至36.7,下降12.3个百分点。该设置下,M³Prune 的下降较小,支持其对这两类错误成员干扰具有更好的耐受性。
作者将这一稳定性归因于对冗余和噪声连接的筛选。但方法 §4.3 将剪枝确定在训练阶段,图5本身没有证明系统能在攻击发生后在线识别成员并即时删边,也没有覆盖所有提示注入或恶意协作场景。
15. 参数实验:更多讨论、更强剪枝都不保证更好
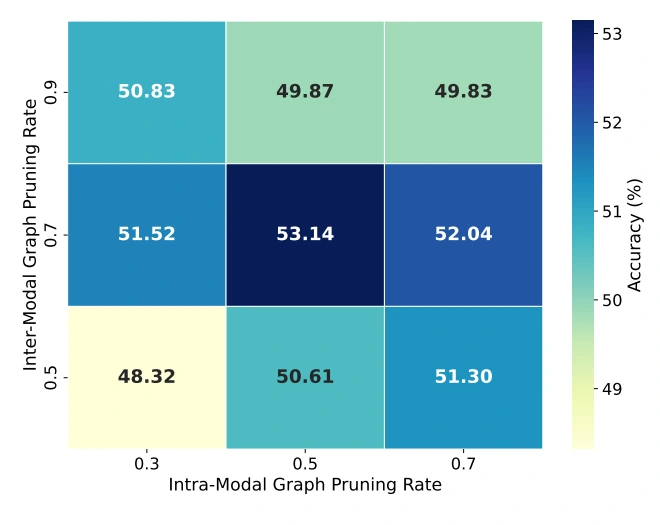
图18,PDF 第14页。Llama3.2-VL-11B 在 MultimodalQA 上的参数分析,横轴为模态内剪枝率设置,纵轴为模态间剪枝率设置,格内数字为准确率。
本组最优值53.14对应模态内0.5、模态间0.7。保持模态内设置为0.5,将模态间设置从0.7提高到0.9,准确率降至49.87。说明在这一扫描范围内,过强剪枝会损失必要通道。图17在另一基础模型上也展示了不同设置的差异。
这些是剪枝率参数设置,不能直接读成所有实际执行最后恰好删掉某个固定比例的边。方法还有渐进更新、已有连接掩码与采样过程。
讨论轮次也不是越多越好。附录表6中,Llama 在 ScienceQA 上讨论2、4、8轮的分数分别为86.61、86.37、86.29。表7中,训练样本从40条增加到80条也没有继续提高平均表现。
表8改变 Agent 数量后同样出现下降:默认配置平均56.36,增加配置为53.70,减少配置为53.52。附录文字说明调整涉及每个数据集中的文本与视觉 Agent。因此,角色数量和组合是需要选择的配置,不能把增加成员等同于增加收益。
16. 局限与证据边界
首先,论文的核心学习对象是通信结构,推理沿训练得到的剪枝图执行。任务适应性不应被直接解释成每个新问题都会在线重学拓扑。
其次,连接分数、消息权重与事实正确概率不同。高分表示在相应优化规则下更值得使用,整图反馈也不能为每条边提供独立因果解释。核范数约束结构,二值掩码负责实际删边,两者不能混为同一个性质。
第三,消融实验支持若干模块有贡献,但替换模态输出的设置移除了信息本身。若要隔离分层设计的独立收益,还需要在相同基础模型、Agent 角色、检索证据和预算下,直接比较无剪枝、平铺剪枝、分层剪枝,以及一次性和渐进式剪枝。
第四,主结果比较的多智能体基线不包含论文引用的 AgentPrune。现有结果能展示相对所列框架的表现,尚不足以单独回答相对已有通信剪枝算法的全部增益来自哪里。不同表格与图的聚合范围也有差异,不宜直接拼成同一总体指标。
最后,本文没有重新运行实验,也没有完成实现级复核。自然语言消息的数值加权、完整采样分布和矩阵约束如何落实到实际调用,应结合固定版本代码进一步核对。报告的准确率与 token 收益限于给定任务、模型和配置。
参考来源与延伸阅读
- M3Prune: Hierarchical Collaborative Pruning for Efficient Multi-Modal Multi-Agent Retrieval-Augmented Generation,本文所依据的20页PDF。DOI(按PDF标注)。
- 作者提供的 M3Prune 仓库。README 列出模态内训练、跨模态训练与评测入口。
- AgentPrune:Cut the Crap,ICLR 2025。本文参考文献[48],是理解通信冗余与时空图剪枝的重要相关工作。
- 站内精读:AgentPrune、SafeSieve。
原图及表格来自所提供的 M³Prune PDF,版权归原作者;该PDF第1页标注 CC BY 4.0。本文仅做图表区域裁切与 WebP 格式转换,中文解说、教学数字与证据边界均在正文中说明。
See also
- PCFNet 论文解读:用频域特征与物理约束预测海表温度 2026-10-28
- AutoPrune 论文解读:让 LLM 设计视觉 Token 剪枝规则 2026-10-22
- OFA-MAS 论文精读:一个通用模型,怎样为不同任务选择智能体并生成协作图 2026-10-20
- RADAR 论文精读:扩散模型如何自动生成多智能体通信图 2026-10-19
- AgentPrune 论文精读:学习谁该听谁,让多智能体通信更省 token 2026-10-18