RADAR 论文精读:扩散模型如何自动生成多智能体通信图
让多个大模型智能体分别分析问题、编写程序和检查结果,可以形成分工;但这些成员应该怎样交流,仍然需要设计。所有人互相发送完整回答,可能增加重复推理和 token 消耗;只安排一条简单的接力链,又可能遗漏必要的信息交换。
RADAR 把这个组织问题交给图生成模型:输入具体任务,逐步预测成员角色及其连接,再让智能体按照生成的通信图执行任务。它的核心操作可以理解为给图填空——当前缺少什么角色,这个角色应该与哪些已有成员交流。
本文依据所提供的 17 页论文 PDF 展开,页码均指该版本;实验数字来自论文,未独立重跑。文中概率和三节点生成过程明确作为教学算例,另核对作者仓库固定提交中的生成入口、任务条件和有效规模实现,不将这些检查等同于完整复现。
论文信息与阅读路线
| 项目 | 信息 |
|---|---|
| 题目 | RADAR: Redundancy-Aware Diffusion for Multi-Agent Communication Structure Generation |
| 作者 | Zhen Zhang、Wanjing Zhou、Juncheng Li、Hao Fei、Jun Wen、Wei Ji |
| 阅读版本 | 所供 17 页 PDF;首页标注 arXiv:2605.09907v2,2026-06-01 |
| 发表信息 | ICML 2026;以论文首页及官方页面为准 |
| 原文 | arXiv v2、OpenReview |
| 官方代码 | cszhangzhen/RADAR |
| 核对的实现版本 | 固定提交 71d92b5 |
| 相关精读 | AgentPrune:学习谁该听谁、SafeSieve:逐步剪掉通信、M³Prune:分层多模态通信剪枝 |
阅读时先区分三个过程:图生成器决定角色和连接,智能体根据连接传递文本,任务评估再为生成器提供反馈。生成图的步骤数、图神经网络的层数、智能体实际讨论的轮数,是三个不同的量。
1. 引言:为什么需要按任务生成通信结构
论文引言从单智能体的能力扩展到多智能体协作,再把注意力转向组织方式。成员能力相同,信息流向不同,也可能产生不同的最终答案和成本。
固定拓扑有各自的使用场景:链式结构适合顺序接力,星形结构通过中心角色协调,树形结构支持层级分工,全连接结构提供广泛的信息交换。问题在于,一套结构未必适合所有任务。简单算术可能只需要短流程,代码生成则可能需要分析、实现和测试之间更丰富的依赖关系。
自动设计方法已经尝试解决人工配置问题。引言将其概括为协调智能体驱动、搜索驱动和图学习驱动:前者可能依赖中心协调者,搜索方法需要评估多种配置,部分图学习方法采用一次性结构生成。作者据此提出更细粒度的逐步生成需求。这是论文的研究论证,不能直接推导出所有单步模型都无法表达复杂结构。
另一个问题是通信冗余。即使拓扑足够灵活,也可能包含重复传递、相似角色之间的反复讨论和低贡献连接。因此,任务适配与通信效率需要一起考虑。
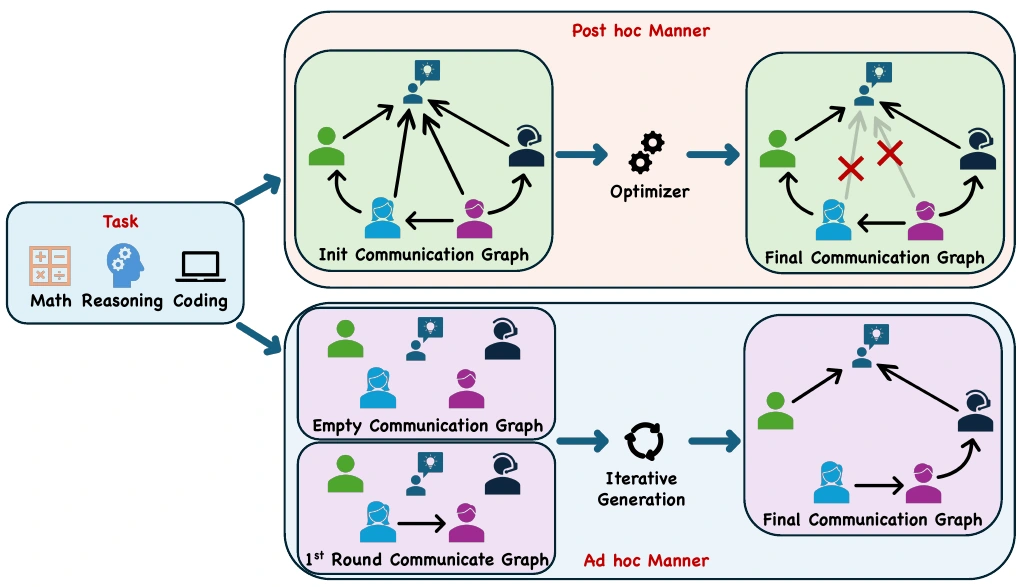
图1,PDF 第2页。上半部分先建立通信图,再删除部分连接;下半部分根据任务逐步形成通信结构。图片来自原论文,可点击查看原尺寸。
上半部分的红叉表示被移除的边。这类事后优化围绕已有拓扑做调整。下半部分表达 RADAR 的目标:在结构形成时就考虑连接价值与冗余,让结构生成和效率控制共同进行。
2. 相关工作:从协作范式到图生成
相关工作按三个研究层次组织,和引言的三类技术路线不完全对应。
第一层是 LLM-agent Collaboration,讨论怎样协作。论文概括了 LLM-Debate 的多轮辩论、MetaGPT 的标准操作流程,以及 AutoGen 支持的嵌套对话、树形和星形等可配置交互。它们建立了不同的协作范式,作者进一步关注这些流程怎样自动适应任务。
第二层是 Multi-agents as Graphs,把协作变成可优化的图。按照 RADAR 文中的描述,GPTSwarm 同时优化节点提示和边关系;G-Designer 使用变分图自编码器处理交互拓扑;MaAS 学习可为不同任务采样的架构分布。图表示使角色与连接能够参与学习。
第三层是图生成技术。ARG-Designer 使用自回归建模,GTD 已采用条件离散图扩散生成通信拓扑。因此,RADAR 的定位需要包含已有生成方法:它进一步将有效规模作为冗余信号,引入任务条件下的逐步结构生成。
以上是 RADAR 对这些工作的组织与概括,并非对每篇相关论文的完整算法评价。原文依据为第2–3页的 Related Works。
3. 问题表示:通信图究竟存储什么
论文把多智能体系统写成有向图 。节点是智能体,边表示信息流; 表示存在从节点 到节点 的通信。这一行、列约定应固定,不能与采用相反矩阵约定的其他论文混用。
一个智能体包含基础大模型、角色、状态与工具。相同的大模型可以通过不同角色提示承担分析、编程或检查职责。图生成器主要产生角色与连接安排,实际文本回答由后续的大模型调用生成。
例如,以下是一个教学用的代码任务流程:
A:分析算法 → B:编写程序 → C:检查程序
对应的邻接矩阵为:
B 可以读取 A 的输出,C 可以读取 B 的输出。增加 A→C,就允许检查者直接参考算法分析;不增加这条边,则通过已有路径传递相关信息。
论文第4页式(6)给出目标:
是问题, 衡量准确率等任务效果, 衡量成本, 控制权衡。这个表达明确了目标;每个部分怎样进入训练,需要继续结合具体更新公式和实现阅读。
4. 图2:训练和使用是两条不同的流程
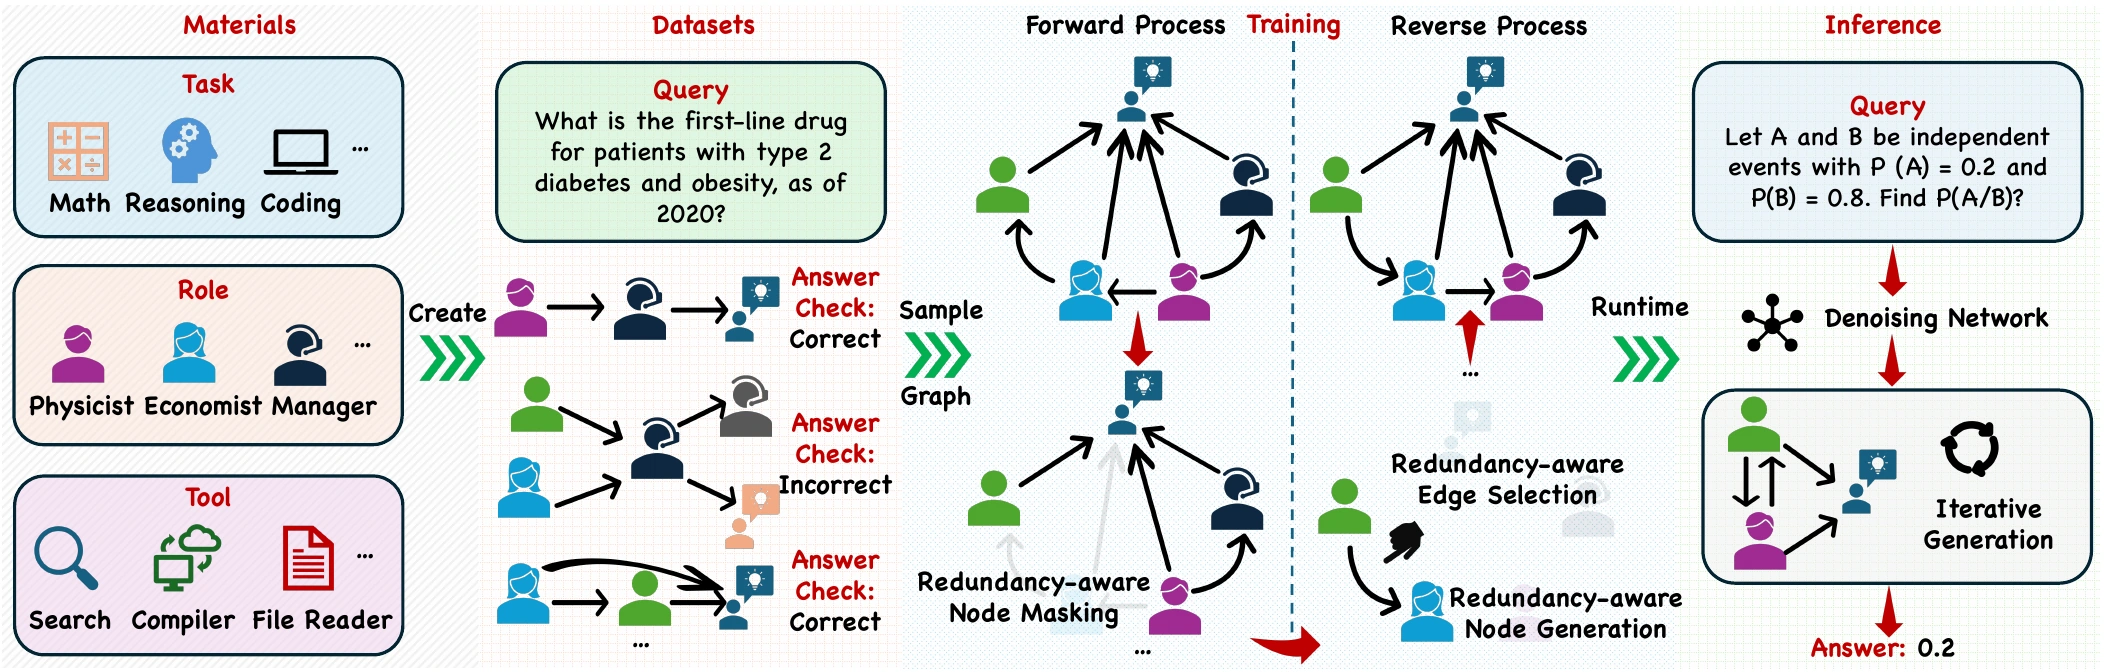
图2,PDF 第5页。左侧准备角色、工具和基础拓扑,中间进行遮蔽与恢复学习,右侧为新问题生成通信结构。图片来自原论文。
训练阶段先构造多种基础拓扑,例如全连接、网状、星形、分层和随机结构,随机分配角色,然后执行训练任务,得到结构与任务表现相关的样本。论文 §5.3 报告每个数据集采样 50 个训练问题;一个问题可以对应多种配置,这不等于只有 50 张训练图。
之后,模型通过完整图与遮蔽图之间的对应关系学习恢复结构,再利用实际任务表现进一步调整。使用阶段面对新问题,去噪网络从遮蔽状态开始逐步生成图,再交给智能体系统执行。
生成器不需要在每次使用前重新跑完整训练流程,也不需要事先知道新问题的正确通信图。
5. 扩散怎样自动排图:把角色和连接当作待填的类别
假设输入是“编写一个计算中位数的程序”。为了说明操作,设模型依次生成检查者 C、程序员 B、分析者 A。角色、顺序和概率均为教学示例,不是作者报告的一次真实采样。
第一步,图中只有一个待填的节点 [MASK]。去噪网络根据任务,给它的角色输出概率,例如检查者 0.70、程序员 0.20、分析者 0.10。程序采样得到检查者 C,把角色写入节点。
第二步,保留 C,再添加一个 [MASK]。模型同时预测待填节点的角色及其与 C 的连接。例如:
| 待预测内容 | 教学示例中的概率 |
|---|---|
| 新节点是程序员 | 0.80 |
| 新节点是分析者 | 0.15 |
| 新节点是检查者 | 0.05 |
| 存在示例中的 B→C 连接 | 0.90 |
| 不存在该连接 | 0.10 |
角色类别的三个概率总和为 1;连接有无是另一次分类,两个概率总和也为 1。它们并不是把整张表的数字共同归一化。
假设采样得到程序员以及这条连接,就形成 B→C。第三步再添加待填节点,预测为分析者 A,决定建立 A→B、不建立 A→C。最终的变化是:
起点: [MASK]
第1步:C:检查者
第2步:B:程序员 → C:检查者
第3步:A:分析者 → B:程序员 → C:检查者
这里 C、B、A 是生成顺序,A、B、C 是示例图的执行顺序。生成图时还没有发生这三个智能体之间的实际文本讨论。
从实现角度,自动设计发生在每一步的分类预测和采样:问题与当前局部图进入神经网络,网络输出角色和连接类型的概率,采样结果被写入图。连接还可以被预测为空,因此增加节点不意味着必须与全部已有成员连接。
6. 这些概率从哪里来:先遮住已知图,再学习恢复
训练程序手中已经有完整图,因此可以人为遮住节点角色及其相关边。以上面的教学图为例:
正向遮蔽:
A → B → C  →  B → C  →  C  →  完全遮蔽状态

反向恢复:
完全遮蔽状态  →  C  →  B → C  →  A → B → C
实际实现包含用于标记未知节点、未知边的特殊类型,图中写成逐步变小的形式只是为了展示剩余已知信息。
每个反向步骤都是一道有答案的训练题:输入问题与不完整图,预测刚才被遮住的角色和连接。原图提供训练目标。预测正确对象的概率偏低时,损失较大;训练更新参数,使正确恢复获得更高概率。
只表达学习方向、忽略轨迹权重等细节时,恢复损失可示意写成:
这是一种离散遮蔽扩散。正向过程逐步破坏图中的已知信息,反向过程学习恢复;它不要求向图加入像素式的高斯噪声。
面对新问题时,训练原图已经不再作为输入。网络依靠学到的条件分布,从遮蔽状态反复补全。局部结构可以有多种补全方式,概率采样因而能够产生不同的新图,而不只是查找一张预存模板。
7. 两个网络分别学习什么
排序网络 决定训练中节点被遮蔽的顺序。 是原图, 是顺序, 是有效规模信号。不同顺序产生不同的中间图,会影响恢复学习的过程,因此遮蔽顺序也被优化。
去噪网络 决定怎样恢复一步。它根据当前不完整图和问题,预测待恢复节点的角色及其与已有节点之间的连接。
去噪网络内部先将节点、边映射为数值向量,再通过图上的消息传递整合局部结构信息。论文使用注意力描述邻居贡献:不同邻居的向量可以获得不同权重,形成更新后的节点表示。
这里的消息是数值特征,与智能体执行任务时交换的自然语言回复不同。图神经网络传递特征,不会在每一层都额外调用大模型让成员聊天。
得到特征后,预测头输出角色和连接类别。论文用混合多项分布处理一组连接的预测,使每一步恢复一个节点及其连接,而不是为每条候选边设置单独的生成步骤。作者报告生成步数为 ,它不等于整个模型的总计算量必然随节点数线性增长。
原文依据为 §4.2,PDF 第5页。§5.3 的实现配置将排序网络描述为三层 RGCN、去噪网络描述为三层 GAT,隐藏维度为 32;任务编码使用 all-MiniLM-L6-v2,输出 384 维向量。
8. 有效规模怎样让生成过程关注冗余
有效规模衡量一个节点的局部连接中,有多少来源在结构上相对不重叠。论文第4页式(7)给出入向有效规模:
是给节点 发送信息的邻居, 是角色,指示函数 在两者角色相同时为 1。公式从来源数量中,扣除来源之间同角色连接形成的冗余项。
一个可手算的教学例子是:检查者 C 接收数学求解者 A、B 的输入,而且 A→B 已存在。C 有两个来源,来源内部有一条同角色有向边,所以:
如果 A、B 之间没有连接,这个扣除项为零,入向有效规模为 2。仅仅角色相同、但没有相应连接,不会对这一项贡献扣分;有连接但角色不同,也不会计入这个同角色项。
作者同样考虑向外传播的冗余,并组合为:
排序网络和去噪网络都会使用这类信号。去噪部分将有效规模作为偏置加入节点表示,影响后续角色、连接预测。它不是一道“分数低就禁止连接”的硬规则,也不直接检查两段文本是否语义重复。
有效规模还与邻居数量相关,比较时需要结合图规模和密度理解。公开实现对该量按 进一步归一化,空邻域贡献设为 0;不能将代码中的归一化数值直接当作上面原始算例的 1.5。
9. 学会恢复图,还需要学会把任务做对
论文 §4.3 包含结构恢复、遮蔽顺序学习和任务效果反馈三部分。
去噪网络根据原图学习恢复角色及连接。排序网络的节点选择属于离散采样,作者采用 REINFORCE,根据采样顺序对应的恢复反馈更新选择倾向。
随后,生成图被交给真实的多智能体系统执行任务。准确率等任务效用通常无法直接通过大模型 API 反向传播,因此作者采用策略梯度,用执行结果调整生成决策的概率。训练中采用周期性、子采样的效用评估,控制实际任务调用的成本。
这个反馈过程解释了为什么模型有机会偏向有用的组织方式:结构恢复提供生成能力,实际任务表现提供与解题目标相关的调整信号。两者不构成找到全局最优图的保证。
还应区分目标式(6)与更新式(16):前者写明成本权衡,后者展示的策略梯度主要是任务效用项,未完整展开成本项如何进入该更新。阅读时不宜自行把省略的细节补成作者已经报告的具体实现。
10. 对照代码:使用阶段真正执行的循环
固定提交中,model/gd.py 的 generate_graph 从一个完全遮蔽节点开始,调用 predict_new_node 预测角色和连接,恢复节点,清理空边和遮蔽边,再添加新的遮蔽节点。这个循环持续到传入的 num_nodes。
下面是解释流程的伪代码,省略了张量、边类型转换和日志处理,不能直接当作运行脚本:
graph = one_masked_node()
for step in range(configured_node_count):
    role_probs, edge_probs = denoiser(graph, task_embedding)
    role = sample(role_probs)
    connections = sample(edge_probs)
    graph = fill_masked_node(graph, role, connections)
    graph = remove_empty_and_masked_edges(graph)
    if step + 1 < configured_node_count:
        graph = add_masked_node(graph)
predict_new_node 支持采样与取最大概率;generate_graph 的调用选择采样。model/denoising.py 返回节点概率 p_v 和边概率 p_e,将任务向量投影后用于预测,并以可学习权重加入有效规模偏置。
这也明确了一个边界:此入口中的节点数由参数配置。论文报告固定五个候选成员时,部分孤立节点在执行中不活跃,因此有效参与人数可能较少;这不意味着该函数已经学习了完全自由的停止生成人数策略。
本文的有向箭头示例遵循论文定义,未逐段复原中间图到实际运行系统的全部转换。正文对去噪网络的概括与公开实现中的自定义消息传递、GRU 等细节也有层次差别,具体复现应以固定代码与运行配置继续核对。
11. 实验:准确率与token开销分别支持什么
作者在 MMLU、GSM8K、MultiArith、SVAMP、AQuA 和 HumanEval 上评估。前五项以准确率衡量表现,HumanEval 使用 pass@1,即单次生成的代码通过测试的比例。主实验主要使用 gpt-4o-mini,多智能体设置以五个成员为主;结果来自论文报告。
| 数据集 | Vanilla 单智能体 | RADAR | 提升:百分点 |
|---|---|---|---|
| MMLU | 78.54 | 83.66 | 5.12 |
| GSM8K | 87.45 | 92.51 | 5.06 |
| MultiArith | 96.85 | 98.81 | 1.96 |
| SVAMP | 86.67 | 93.26 | 6.59 |
| AQuA | 78.92 | 82.84 | 3.92 |
| HumanEval | 87.08 | 91.28 | 4.20 |
| 六项平均 | 85.92 | 90.32 | 4.40 |
表1位于 PDF 第8页。与表中平均成绩最高的其他方法 ARG-Designer 相比,RADAR 的平均值从 88.57 提高到 90.32,相差 1.75 个百分点。百分点是两个百分数的直接差,不能写成相同数值的相对百分比提升。
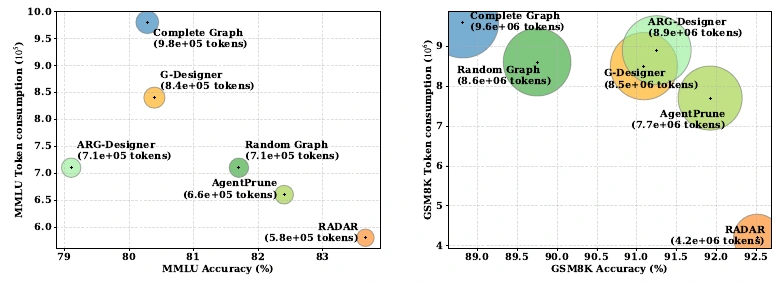
图3,PDF 第7页。横轴为准确率,纵轴为累计 token 消耗;越靠右下方表示这两个指标的组合越有利。图片来自原论文。
GSM8K 图中,RADAR 使用约 420 万 token,G-Designer 为 850 万,全连接图为 960 万。该图支持 RADAR 在相应评测设置下,以较低 token 消耗取得较高准确率。它报告的是累计量,不能当作单道题的费用。
节省 token 也不等于推理更快。第9页表4报告 RADAR 推理时间为 17.55 分钟,AgentPrune 为 14.25 分钟,AFlow 为 7.32 分钟。作者解释,逐问题生成结构增加了额外开销。
图3与表4分别出现 420 万和 650 万的 GSM8K token 数值,后者列名为 Overall Token。两处统计边界没有在相邻文字中充分说明,比较时应保留各自口径,不能直接混用。
12. 消融、攻击与结构统计:设计是否起作用
消融实验通过移除部分设计,检查完整系统的哪些部分与性能有关。表2在 MMLU 上报告:
| 设置 | 准确率 | 相对完整模型下降:百分点 |
|---|---|---|
| 完整 RADAR | 83.66 | — |
| 去掉有效规模 | 81.05 | 2.61 |
| 去掉任务效用反馈 | 82.96 | 0.70 |
| 去掉问题输入 | 79.08 | 4.58 |
| non-diffusion 对照 | 79.10 | 4.56 |
去掉问题输入后下降较大,支持任务条件对当前生成框架有作用;去掉有效规模和效用反馈也降低成绩。non-diffusion 行采用 ARG-Designer,并非其他部分完全相同、只替换一个扩散模块,因此 4.56 的差距不能全部归因于扩散机制本身。原文依据为第8页表2。
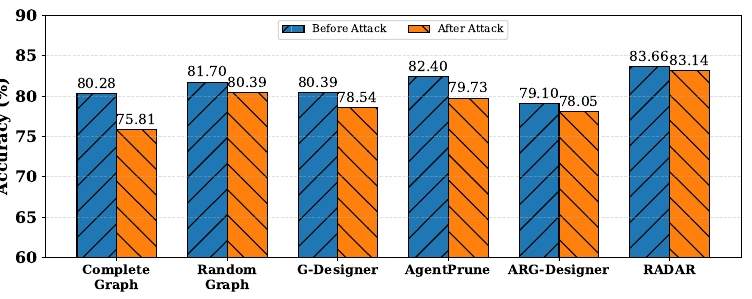
图4,PDF 第7页。作者将五个智能体中的两个修改为故意提供错误信息的角色,比较攻击前后的准确率。图片来自原论文。
在这一攻击设置下,全连接图从 80.28 降至 75.81,RADAR 从 83.66 降至 83.14,分别下降 4.47 和 0.52 个百分点。它支持所测试提示扰动下的鲁棒性优势;该实验没有单独证明减少冗余是优势的唯一原因,也不能代表所有攻击场景。
第9页表5进一步报告生成图的结构:RADAR 的平均活跃节点数为 4.60、密度为 0.289、有效规模为 0.92;G-Designer 对应为 4.92、0.302、0.73,ARG-Designer 为 3.79、0.317、0.68。RADAR 保留了较多活跃成员,同时使用较稀疏的连接,并取得较高的有效规模。
这些结构统计与作者的目标相符,但有效规模仍是预定义的结构指标,不能直接替代对消息新增语义信息量的测量。表5还报告了标准差,以上仅列均值。
13. 图7:不同问题得到怎样的团队
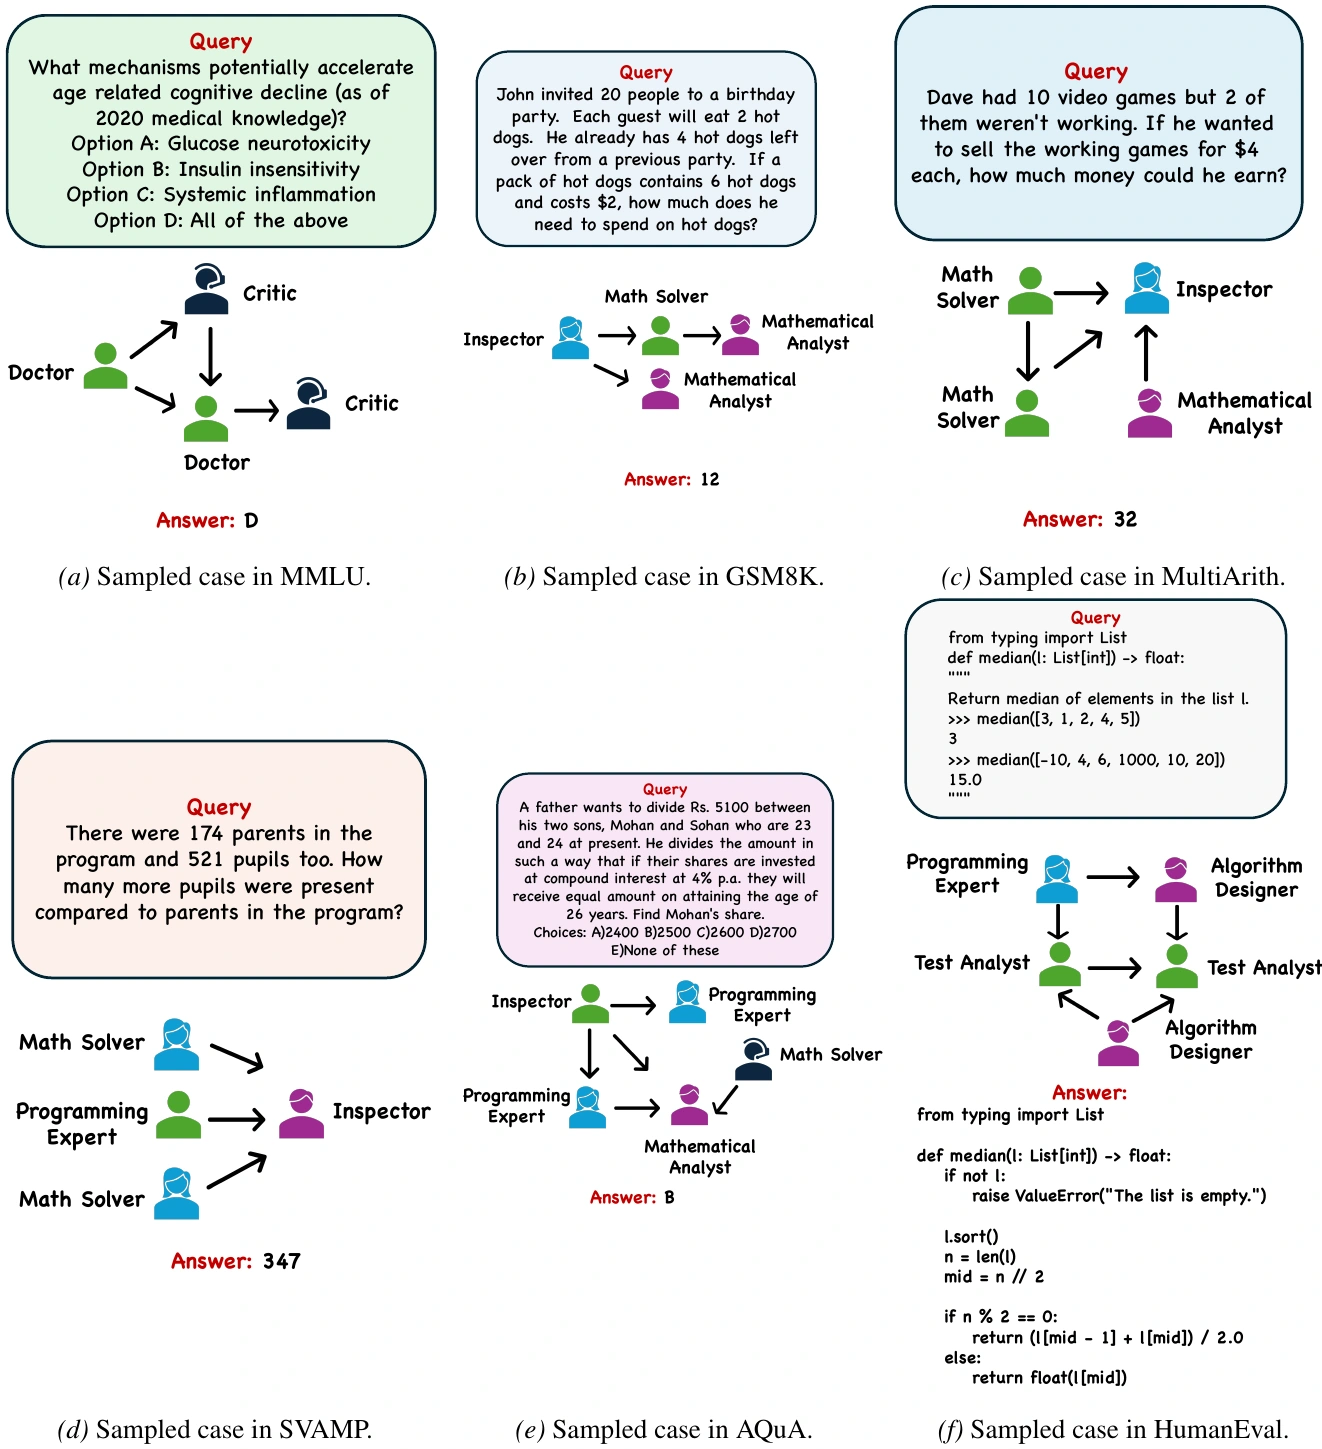
图7,PDF 第17页。六个案例分别来自 MMLU、GSM8K、MultiArith、SVAMP、AQuA 和 HumanEval;角色与连接随任务改变。图片来自原论文,建议点击查看细节。
图中的数学题使用求解者、分析者和检查者,代码任务使用程序专家、算法设计者和测试分析者。附录说明,最大人数固定为五时,较简单任务不一定激活全部成员,AQuA 和 HumanEval 的展示案例则使用五个成员。
这些案例帮助理解“任务条件化”的输出长什么样,但六个选例不等于整个任务分布的统计证据。对自适应能力的判断,还应结合去掉问题输入的消融和生成图的整体分布。
14. 讨论与适用边界
RADAR 提供了一条可学习的组织路径:用离散遮蔽构造恢复任务,让网络根据具体问题逐步预测角色和连接,再用任务反馈调整生成倾向。与围绕初始图做局部删除的方法相比,它关注结构形成时的冗余控制。
实验在六个基准上报告了准确率和 token 效率收益,也显示逐问题生成结构会增加时间开销。结果适用于作者的模型、样本和运行配置,不构成任意智能体团队都能取得相同收益的保证。
阅读和复现时还需要保留几个边界:有效规模反映局部结构,未直接验证消息内容是否重复;节点容量在公开生成接口中由参数指定;式(10)的概率归一化写法与式(16)对成本项的展示需要结合实现核对;主结果表没有提供各方法多次独立运行的波动范围,小差距的稳定性需要更多证据。
节点角色预测也应理解为在既定角色类型中选择。论文将更动态的角色组合或生成列为后续方向,因此不宜把目前系统解释成已经能够无限制发明角色、人数和工具配置。
实际选用这种方法时,可以分别考察任务效果、累计 token、端到端时间和生成结构的可执行性。它们衡量不同的工程与研究目标,单个指标不足以代表整个系统的收益。
来源与延伸阅读
- RADAR 原论文,arXiv:2605.09907v2。方法主要见 §3–4,实验见 §5,案例见附录 D。
- RADAR 的 OpenReview 页面。
- 官方实现,固定提交 71d92b5。本文重点核对
model/gd.py、model/denoising.py与model/utils.py,未执行模型训练或完整复现。 - AgentPrune 论文精读、SafeSieve 论文精读、M³Prune 论文精读。可对照阅读结构生成与通信剪枝的不同决策过程。
本文图1、图2、图3、图4与图7均摘自 RADAR 原论文,保留原编号,用于相关方法与实验的解释;教学概率、手算例和简化伪代码为本文组织的辅助说明。
See also
- PCFNet 论文解读:用频域特征与物理约束预测海表温度 2026-10-28
- AutoPrune 论文解读:让 LLM 设计视觉 Token 剪枝规则 2026-10-22
- OFA-MAS 论文精读:一个通用模型,怎样为不同任务选择智能体并生成协作图 2026-10-20
- M³Prune 论文精读:先组内讨论,再跨模态协作,怎样剪掉多余通信 2026-10-19
- AgentPrune 论文精读:学习谁该听谁,让多智能体通信更省 token 2026-10-18