AutoPrune 论文解读:让 LLM 设计视觉 Token 剪枝规则
AutoPrune 让大语言模型设计视觉 token 剪枝规则:成熟算法先给出一组选择,再按搜索得到的规则,替换少量不确定的选择。在主要设置中,CDPruner 从576个视觉 token 中先选32个,修正规则至少保留其中30个、最多等量替换2个,最终仍输出32个。
这里有两个阶段:离线阶段搜索规则,实际使用时执行规则。保留数量是预先给定的预算;不同图片和问题会产生不同的 token 选择。目标多模态模型的参数在整个过程中保持冻结。
论文信息
| 项目 | 内容 |
|---|---|
| 题目 | An AI4AI Framework for Visual Token Pruning |
| 方法 | AutoPrune |
| 作者 | Zhen Liu、Wenli Huang、Wei Song、Yuhan Liu、Zhiqin Yang、Jingwen Fu |
| 阅读版本 | arXiv:2608.07193v2,2026年9月6日,17页,含补充材料 |
| 原文 | 论文页面、PDF |
| 代码 | AIM-ResearchLab/AutoPrune |
图表与实验数字来自上述版本。下文的语义化例子用于解释运算,不是论文中的可视化样本;实现说明以PDF为依据。
为什么需要自动设计剪枝规则
多模态模型通常先把图片编码为数百至数千个视觉 token,再交给语言模型处理。视觉 token 越多,后续计算、输入处理延迟和KV缓存开销通常越大。剪枝希望保留回答问题所需的信息,减少重复背景和相似特征。
已有方法利用重要性、相似度、问题相关性或信息多样性设计规则。难点在于如何组合这些判断,以及怎样适配不同预算和模型。让LLM从头生成完整程序,又要同时处理庞大的设计空间、张量尺寸、索引和数值约束。
AutoPrune将问题限定为:利用已有剪枝策略提供可靠初选,再搜索受约束的修正规则。 基础算法积累的经验得以保留,LLM将搜索集中在评分、候选组织和选择等环节。
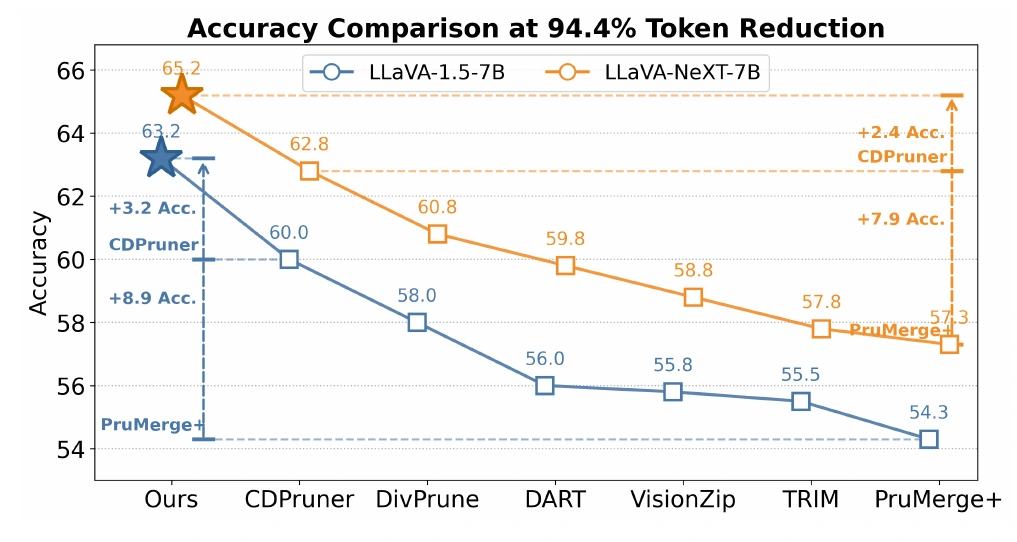
图1,PDF第1页。蓝色对应LLaVA-1.5-7B,橙色对应LLaVA-NeXT-7B。在同样删除94.4%视觉token的条件下,AutoPrune的汇总分数比CDPruner分别高3.2和2.4分。
输入、输出与两个模型角色
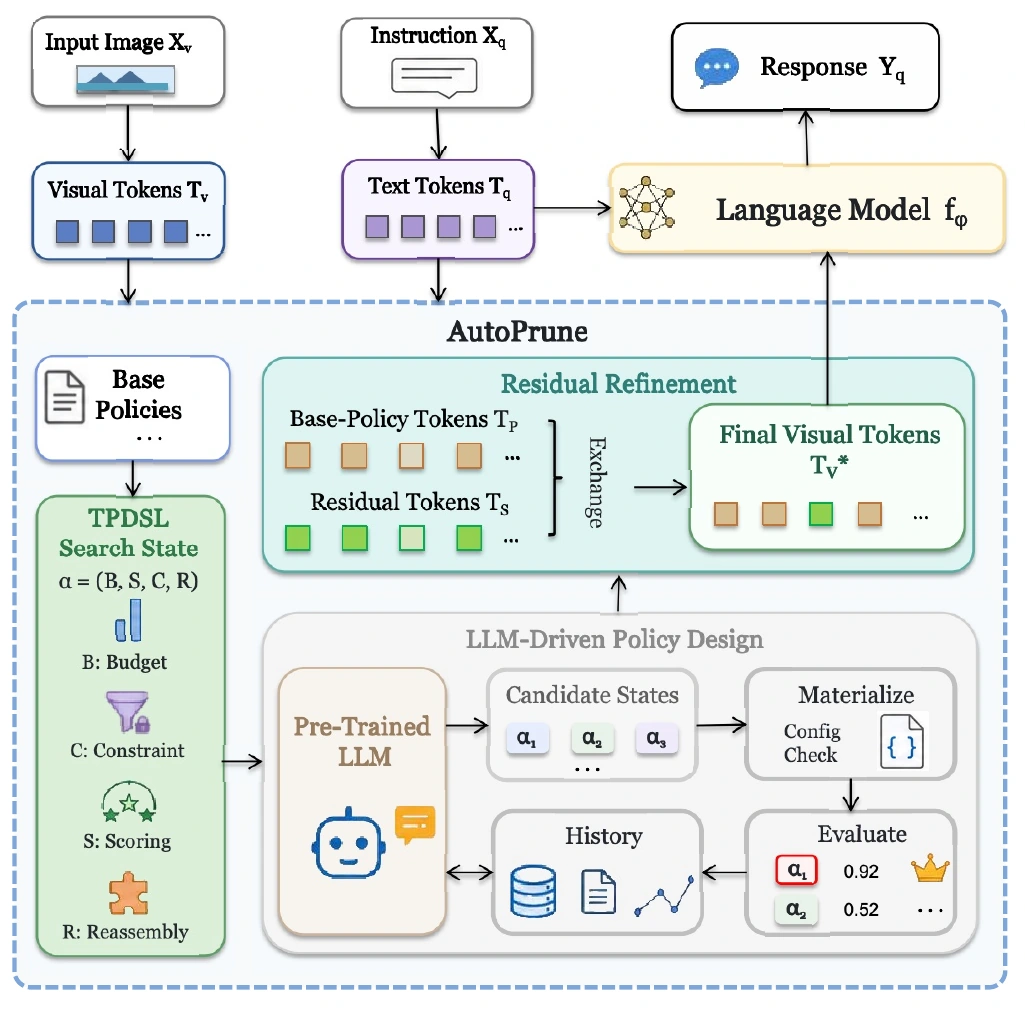
图2,PDF第3页。下半部分搜索策略配置,上半部分按配置修正token选择,最终视觉token与文字token共同进入语言模型。
设图片编码产生 个视觉 token,每个token包含 个特征数值。预算为 时,最直观的尺寸变化是:
图片 → 视觉编码器 → N×d 的视觉特征
                         ↓ 剪枝与重组,预算为K
                       K×d 的视觉特征
                         ↓ 与文字token一起送入语言模型
                       问题的回答
例如,主要设置从576行特征变成32行特征。主要节省的是语言模型处理视觉输入的开销,视觉编码器仍需先提取图像特征。
| 角色 | 主要工作 | 默认实例 |
|---|---|---|
| 设计规则的LLM | 根据工具箱、预算和评测反馈,提出策略配置 | Qwen-Plus |
| 目标多模态模型 | 读取剪枝后的视觉特征与问题,生成答案 | LLaVA-1.5-7B |
搜索阶段的输出是配置及其可执行程序;处理一张图片的输出是具体保留的视觉token。两者对应不同的数据类型。
TPDSL:让LLM组合可执行操作
TPDSL全称为Token Pruning Domain-Specific Language。它将一套候选配置表示为:
| 配置 | 负责的内容 |
|---|---|
| :预算控制 | 将目标保留数量落实为本次运行的预算及相关参数 |
| :token评分 | 选择评分信号、相似度计算和分数融合方式 |
| :选择约束 | 构建候选池,限制替换数量,保留基础选择并控制冗余 |
| :token重组 | 整理顺序和输出特征,按配置融合部分被丢弃的信息 |
一套完整搜索状态由基础策略 与配置 共同组成。基础策略提供初选,配置规定怎样评估、修正并输出这组选择。
TPDSL包含131个操作原子,分为9组:token来源与基础策略、预算、评分、相似度、分数融合、候选池、选择约束、重组、合法性检查。每个操作有预定义语义和标准接口;候选配置组合其中的兼容操作及参数。
这些原子包含不同的参数和处理变体,其中重组与token处理组占81项。131表示工具箱规模,不表示每个候选都要执行131个步骤。
离线搜索:提出配置、运行评测、反馈改进
主要实验使用LLaVA-1.5-7B、MME和源预算 搜索一次,然后将选中策略重新实例化,用于其他预算与模型。搜索运行10轮,每轮提出5个候选。
- 提出配置。 Qwen-Plus接收TPDSL操作库、基础策略、预算和搜索历史,输出若干候选 。预算32是给定的条件。
- 实例化。 Materialize将操作名称绑定到实现,补齐默认参数、预算与模型相关字段,构成可执行策略。
- 合法性检查。 检查token数量、索引有效性与唯一性、数值稳定性、特征尺寸和确定性执行。失败候选被排除,并记录诊断。
- 任务评测。 用候选策略处理评测图片,让目标模型答题,按MME规则给策略打分。
- 更新历史。 汇总配置、分数与失败原因,供下一轮参考。最后从所有合法候选中选出最高分配置 。
TPDSL+基础策略+预算+历史
             ↓
LLM提出候选配置 → 实例化与检查
                         ↓
              用候选程序剪枝并答题
                         ↓
                 得分与诊断 → 历史
这里的改进发生在策略配置上,目标模型的权重保持冻结。部署时直接执行找到的策略,无需额外调用设计用LLM。
Residual Refinement:先选32个,再少量交换
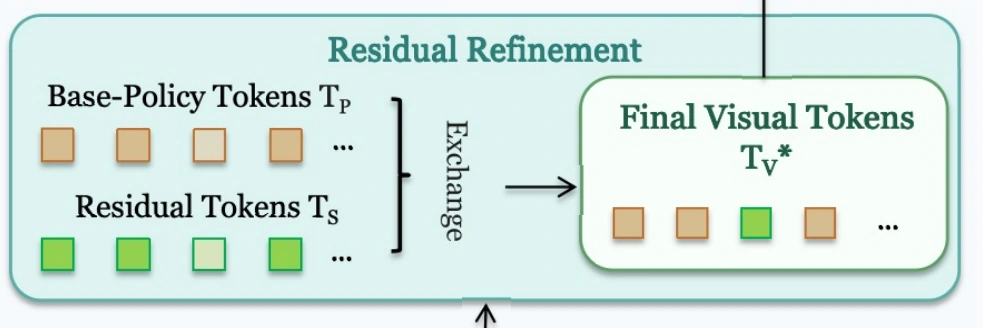
图2局部。橙色为基础策略的初选,绿色为候选池,右侧为修正后的视觉token。图中方块数量仅作示意。
基础策略给出初选
给定全部视觉token 、问题 和预算 :
默认由CDPruner先选32个。此时程序仍能访问全部576个视觉特征,后面可以从未选中的位置寻找替代者。
用多种信号评分
最终配置综合五类信号:
| 信号 | 判断依据 |
|---|---|
| 问题相关性 | 当前token与问题的相关程度 |
| 注意力代理显著性 | 用近似指标估计值得关注的程度 |
| 空间中心性 | 图像位置提供的先验 |
| 冗余密度 | 与其他token的信息重复程度 |
| 局部对比度 | 局部视觉变化的明显程度 |
各项归一化后进行加权乘积融合:
是第 个token的综合分数, 是某项归一化评分, 控制该项的影响。这些分数由程序计算,用来估计选择价值。
建立候选池并约束交换
程序按配置构建候选池 ,同时考虑信息多样性。高分token可能高度相似,选择时还要控制信息重复。
交换模块确定两组token:
- :从初选中换出的低置信度选择。
- :从候选池中补入、原来没有选中的token。
更新后的集合为:
并要求:
主要32-token设置中,、。允许换0、1或2个,每次等量换入换出,最后始终为32个。候选池可以很大,实际补入数量受上述约束限制。
例如,问题是“汽车是什么品牌、什么颜色”,初选可能已经包含多个表达车身颜色的token,却遗漏车标。修正规则可以换掉一个重复的车身token,补入包含车标信息的候选。这个例子说明的是信息互补;程序实际按数字特征、评分和约束决定交换对象。
补入者应当比被换出的选择更适合当前集合。它的价值还取决于已有信息:重复描述车身颜色的高分token,未必比补充品牌信息的token更有增益。
重组并输出
重组操作整理最终token的顺序和特征尺寸,按配置还可融合被丢弃token的部分信息:
最终视觉特征再与文字token一起送入语言模型。这里的“残差”指围绕基础选择作有限修正。
算法1逐行对应
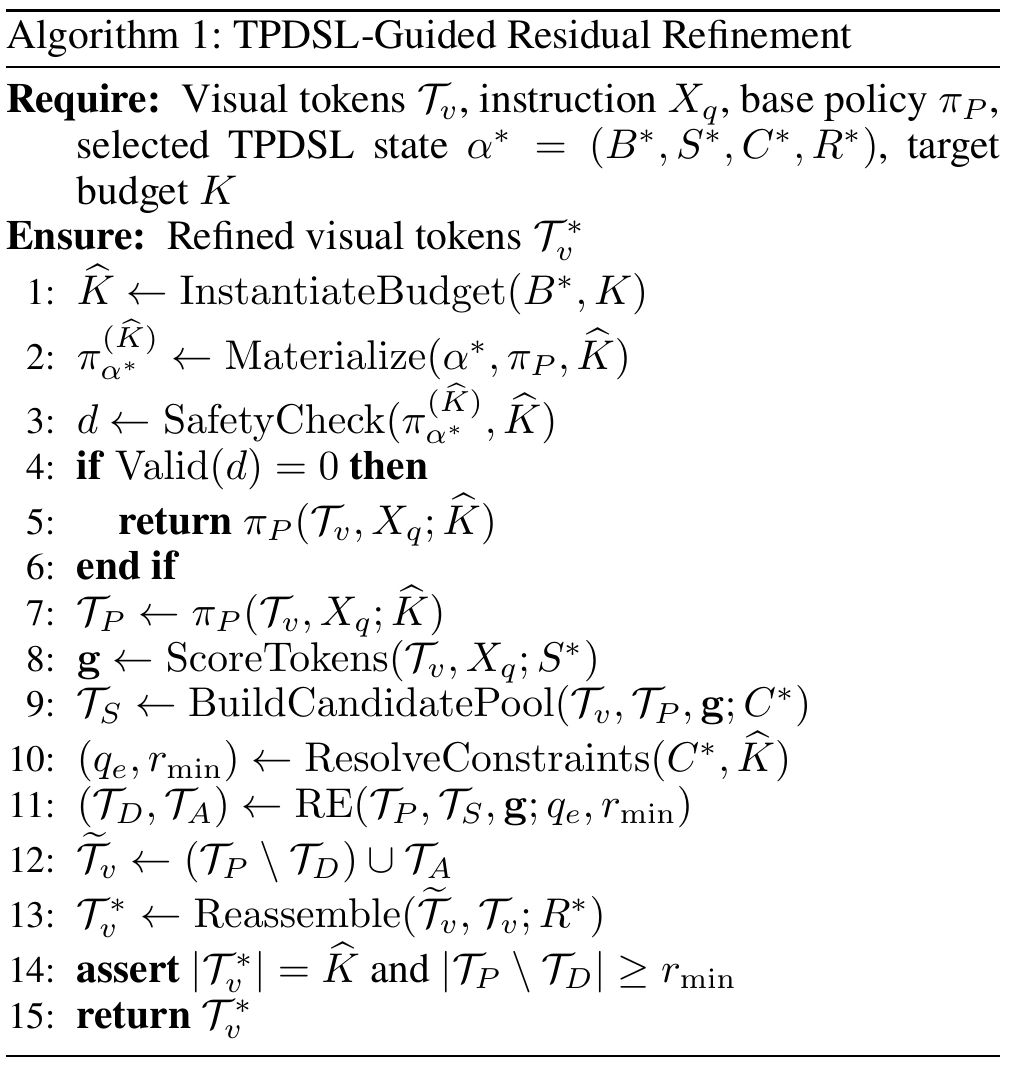
Algorithm 1,PDF第4页。输入包含已经选好的配置,输出为修正后的视觉token。
| 行号 | 操作 | 含义 |
|---|---|---|
| 1 | InstantiateBudget | 根据预算配置和外部要求,确定实际预算 |
| c-1 5-5 9-11 9h-2L532 67 19 159h-2c-5 0-9-4-11-9l-5-22c-1-6 2-12 8-13z"/> | ||
| 2 | Materialize | 将选定配置与基础策略接成可执行程序 |
| 3 | SafetyCheck | 生成合法性检查记录 |
| 4—6 | 失败时返回基础策略结果 | 检查不通过便结束本次修正,使用基础策略输出 |
| 7 | 计算 | 基础策略先选出 |
| c-1 5-5 9-11 9h-2L532 67 19 159h-2c-5 0-9-4-11-9l-5-22c-1-6 2-12 8-13z"/> 个token | ||
| 8 | ScoreTokens | 根据 给全部视觉token计算综合分数 |
| 9 | BuildCandidatePool | 根据特征、初选和评分组织候选池 |
| 10 | ResolveConstraints | 确定最多替换数 与最少基础保留数 |
| 11 | RE | 决定换出集合 与补入集合 |
| 12 | 更新集合 | 从初选中移除 ,加入 |
| 13 | Reassemble | 整理并输出最终视觉特征 |
| 14 | assert | 确认总数量等于预算、基础选择保留数满足要求 |
| 15 | return | 返回视觉token,供后续语言模型答题 |
第3行检查程序合法性;策略的答题成绩来自离线评测。第11行决定交换名单,第12行实际更新集合。第14行的断言要求约束成立,不负责自动补齐或修复结果。
实验设置与指标
论文在三个目标模型上测试:LLaVA-1.5-7B、LLaVA-NeXT-7B和Qwen2.5-VL-7B。作者报告覆盖14个多模态基准,涉及普通视觉问答、科学推理、文字与图表理解、视觉幻觉和综合能力。
主要基准包括VQAv2、GQA、VizWiz、ScienceQA-IMG、TextVQA、POPE、HallBench、MME、MMBench中英文、MM-Vet、ChartQA、AI2D与OCRBench。不同表使用对应的基准组合。
论文将Acc.定义为汇总得分:MME先按模型评测套件进行尺度归一化,再与其余指标求平均;Rel.用于报告相对完整token模型的表现,完整模型设为100%。下面数值按原表列出。
主文表1—表7
| 表格与页码 | 实验怎样做 | 主要结果与解释 |
|---|---|---|
| 表1,第5页:剪枝效果对比 | LLaVA-1.5-7B从576压到32个token;NeXT从2880压到160个,均删除94.4%。与PruMerge+、TRIM、VisionZip、DART、DivPrune、CDPruner比较 | AutoPrune的Acc.为63.2、65.2,比CDPruner高3.2、2.4分;原表Rel.为99.7%、99.9%。优势指汇总成绩 |
| 表2,第5页:推理效率 | NeXT、单张RTX 3090,各剪枝方法保留320个token。比较计算量、输入处理与生成延迟、缓存、显存和MME | 对完整模型,FLOPs从41.7T降至4.2T,Prefill指标从815降至128,约为9.9倍计算量减少、6.4倍输入处理加速 |
| 表3,第6页:迁移到Qwen | 将源模型找到的策略用于Qwen2.5-VL-7B,测试256、128、64、32个token,无额外LLM搜索 | 各预算下Acc.均优于作者复现的CDPruner。例如128个token时,55.58提高到60.66;完整模型为78.06 |
| 表4,第6页:组件消融 | 在LLaVA-1.5-7B、MME、32个token下,分别去掉基础保留约束、多评分融合、多样性选择 | 完整方法1413.46;去保留约束1223.29,去融合1391.70,去多样性1400.80。保留约束的影响最大 |
| 表5,第6页:更换设计用LLM | 比较Qwen-Max、Qwen-Plus、DeepSeek-V4-Flash,其余条件一致 | MME为1411.04、1413.46、1414.34,最大差3.30分。检验设计用LLM的影响 |
| 表6,第7页:替换数量消融 | 最终预算固定32,将替换上限设为0、1、2、4、8、16、32 | 不替换1373.00;最多换2个最好,为1413.46;允许换全部32个降至1217.88 |
| 表7,第7页:更换基础策略 | 将五种其他剪枝策略接入统一执行接口,比较基础策略单独使用与加入AutoPrune修正 | 五种策略的MME均提高,增益22.46—145.40分。该表比较统一接口下的修正收益,不用于重排原始完整系统 |
表2与表1的预算不同。表2的9.9倍和6.4倍均相对完整token模型计算;与同预算CDPruner相比,AutoPrune的FLOPs、生成延迟、缓存和显存相同,Prefill指标为128对131,MME从1453.0提高到1457.9。
表5更换的是负责设计规则的LLM;表3更换的是看图答题的目标模型。这两类迁移需要分别理解。
表6为什么支持有限修正
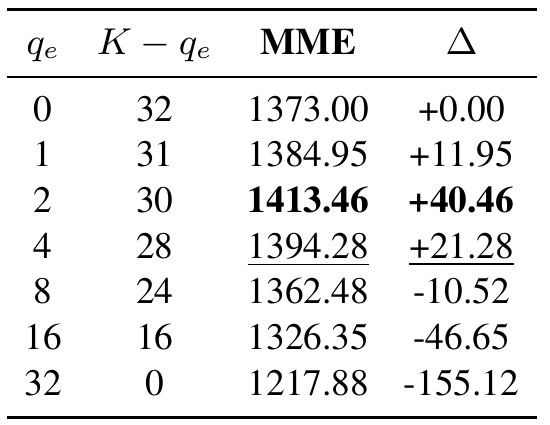
表6,PDF第7页。 为最多允许替换的数量, 表示该限制下至少保留的基础选择数;所有设置最终均为32个token。
允许少量替换可以修正初选中的局部不足。提高替换上限没有持续带来收益:上限2对应最佳分数,4下降到1394.28,8下降到1362.48,后者已低于基础策略。
该结果支持这一设置下的受限修正设计:保留主体选择,将调整集中在少量不确定位置。它没有证明所有模型和预算下都应固定替换2个。
补充材料表8—表14
| 表格与页码 | 内容或实验怎样做 | 结果与作用 |
|---|---|---|
| 表8,第11页:操作库组织 | 列出9组、131个TPDSL原子的功能和示例 | 方法说明表,展示LLM可用的设计空间 |
| 表9,第12页:最终配置 | 列出选中配置的预算、评分、约束与重组方式 | 固定32-token预算;五类信号与加权乘积;多样性选择;、;兼容原接口的重组 |
| 表10,第14页:LLaVA多预算对比 | 比较32、64、128个token;只在32-token设置搜索,其他预算重新实例化 | 相比CDPruner,Acc.分别提高3.2、2.5、2.3分;表1的32-token结果是其中一部分 |
| 表11,第15页:NeXT多预算迁移 | 将源策略用于NeXT的160、320、640个token设置 | 相比CDPruner,Acc.分别提高2.4、1.9、1.7分;表1的160-token结果是其中一部分 |
| 表12,第16页:跨预算迁移 | 在LLaVA上将源规则用于16、32、64、128个token,无额外搜索 | 原表Rel.为96.6%、99.7%、100.9%、102.3%。超过100%表示汇总成绩超过完整token模型 |
| 表13,第17页:搜索方式对比 | 与OpenEvolve和EvoPrompting风格搜索比较;统一基础策略、MME、32-token预算及10×5候选数量 | MME分别为1407.23、1409.21、1413.46,AutoPrune在该设置下最高 |
| 表14,第17页:随机种子稳定性 | 用43、44、45、46四个种子,各运行一次10×5搜索 | 四次均产生50个合法候选,最佳分均为1413.46,候选均分为1408.23—1408.94 |
表14的Mean、Min、Std统计的是每次搜索内部50个候选的成绩分布。表8、表9说明方法及配置;表10、表11扩展已有结果,不能将每张表都理解为互相独立的新实验。
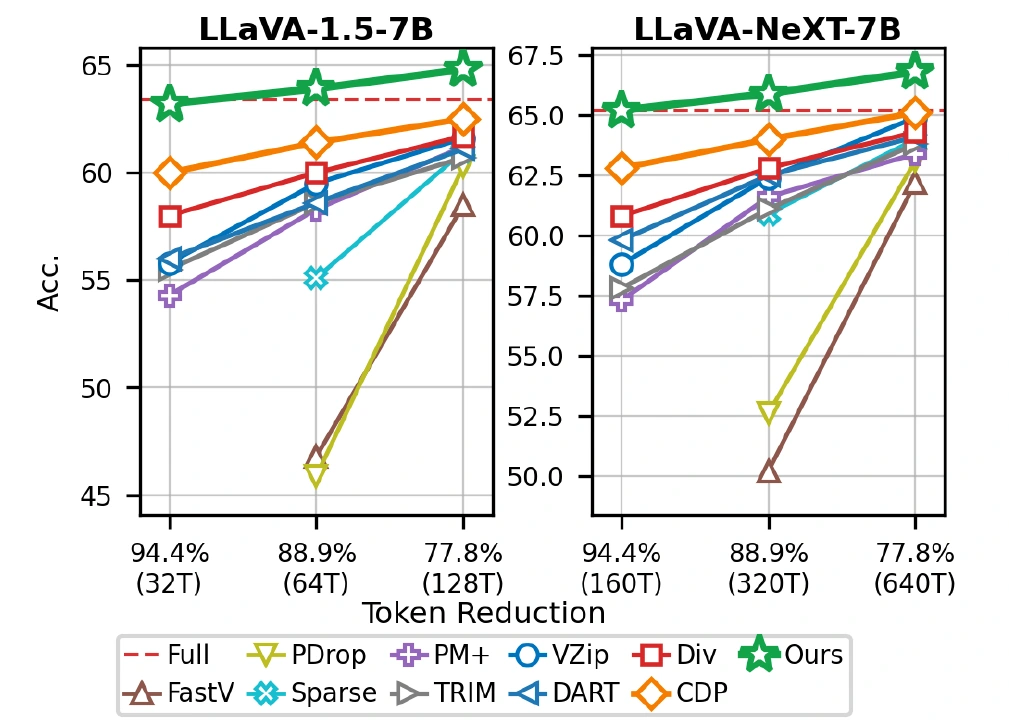
图3,PDF第5页,对应表10、表11。横轴从左到右保留的token逐渐增加;绿色星号为AutoPrune,红色虚线为完整token模型。
在表12中,变化的是最终保留数量 ;表6变化的是允许替换上限 。前者检验同一规则能否用于不同预算,后者检验固定预算下修正多少更合适。
结果边界与复现要点
AutoPrune的效果依赖基础策略、TPDSL能表达的操作以及任务评测器。主要策略在MME、LLaVA-1.5-7B和32-token设置下选出,跨任务、预算和模型的结果体现其在所列条件下的迁移能力。
“保留99%以上性能”来自表1的两个LLaVA设置,指汇总指标。Qwen迁移结果仍有明显下降,例如128-token设置的Acc.为60.66,完整模型为78.06;不能将LLaVA上的比例用于所有架构。
表3的Qwen版CDPruner由作者按论文协议复现。表7的替代基础策略通过统一接口实现,比较的是受控执行管线内的修正收益。这些实现条件会影响对照结果的解释。
无须微调意味着目标模型权重保持冻结。离线阶段仍需运行候选策略评测;主文报告了10×5的搜索规模,但没有给出完整搜索耗时与费用。表2测量的是部署推理效率。
PDF给出了组件、约束与流程,未逐项展开全部评分函数、最终权重和具体交换门槛。精确复现需要结合官方代码核对。图表中的性能数字来自原文,本文未独立重跑基准。
参考来源
本文图片均截取自上述论文,并在对应图注中标明原图编号与PDF页码。
See also
- PCFNet 论文解读:用频域特征与物理约束预测海表温度 2026-10-28
- OFA-MAS 论文精读:一个通用模型,怎样为不同任务选择智能体并生成协作图 2026-10-20
- M³Prune 论文精读:先组内讨论,再跨模态协作,怎样剪掉多余通信 2026-10-19
- RADAR 论文精读:扩散模型如何自动生成多智能体通信图 2026-10-19
- AgentPrune 论文精读:学习谁该听谁,让多智能体通信更省 token 2026-10-18