OFA-MAS 论文精读:一个通用模型,怎样为不同任务选择智能体并生成协作图
一道数学题可能需要计算和检查,一项编程任务可能需要实现、测试与修正。即使使用同一个大语言模型,参与者承担什么角色、谁能读取谁的回答,也会改变多智能体系统的表现。
OFA-MAS 把这种组织工作交给一个图生成器:输入题目,逐步选择智能体角色并预测连接,形成一支面向当前任务的团队。它关注的核心问题是,能否把多类任务中的组队经验学进同一个模型,而不是为每个数据集分别维护一套拓扑设计模型。
可以把它理解为一个“自动组队与分工安排器”。TAGSE 描述当前团队的状态,MoE 参与决定下一位成员及其连接,三个训练阶段逐步教会模型怎样搭结构、怎样匹配任务、怎样参考实际表现。团队构建完毕后,被选中的大模型智能体才按图解题。
本文依据所提供的 12 页论文 PDF 和官方代码的固定提交展开。实验数字均来自论文报告,未独立重跑训练和完整基准;代码部分为静态核对,并对注意力掩码的边界情况作了数值检查。教学示例会明确标注,不将解释性的角色需求等同于模型实际生成的自然语言。
论文信息与阅读路线
| 项目 | 信息 |
|---|---|
| 题目 | OFA-MAS: One-for-All Multi-Agent System Topology Design based on Mixture-of-Experts Graph Generative Models |
| 作者 | Shiyuan Li、Yixin Liu、Yu Zheng、Mei Li、Quoc Viet Hung Nguyen、Shirui Pan |
| 阅读版本 | arXiv:2601.12996v1,2026 年 1 月版本,12 页;本文页码均指该 PDF |
| 原文 | arXiv v1、PDF |
| 官方代码 | Shiy-Li/OFA-MAS |
| 核对的代码提交 | 45c989d,重点为 experiment/OFA/model_ofa.py |
| 相关精读 | AgentPrune:学习谁该听谁、SafeSieve:逐步剪掉多智能体通信、RADAR:生成多智能体通信图 |
文中原论文图表均注明位置,图片可点击查看原尺寸。原图版权归论文作者,按所供 PDF 标注的 CC BY 4.0 许可使用;裁切与格式转换不改变图中数据。
1. 动机:从每个领域一个设计器,到多个领域共用一个设计器
论文讨论的 one-for-one 与 one-for-all,指的是拓扑设计模型怎样训练与部署,不是系统只有一个智能体,或让一个智能体承担全部工作。
在论文设置的 one-for-one 范式中,MMLU、GSM8K、HumanEval 等数据集分别训练自己的设计模型。这样做可以适应特定任务,但新增任务时需要额外收集数据、训练、调参与维护;不同领域之间可能共享的协作模式也难以统一利用。
例如,数学解题中的“分析—求解—检查”,与编程中的“设计—实现—测试”有一定结构相似性。角色不同,但都可能包含产出与核验之间的信息依赖。作者据此提出:在统一角色池和多领域数据上训练一个图生成器,能否学到可复用的组织经验?这种相似性是方法动机,并不意味着所有任务都应采用同一条链。
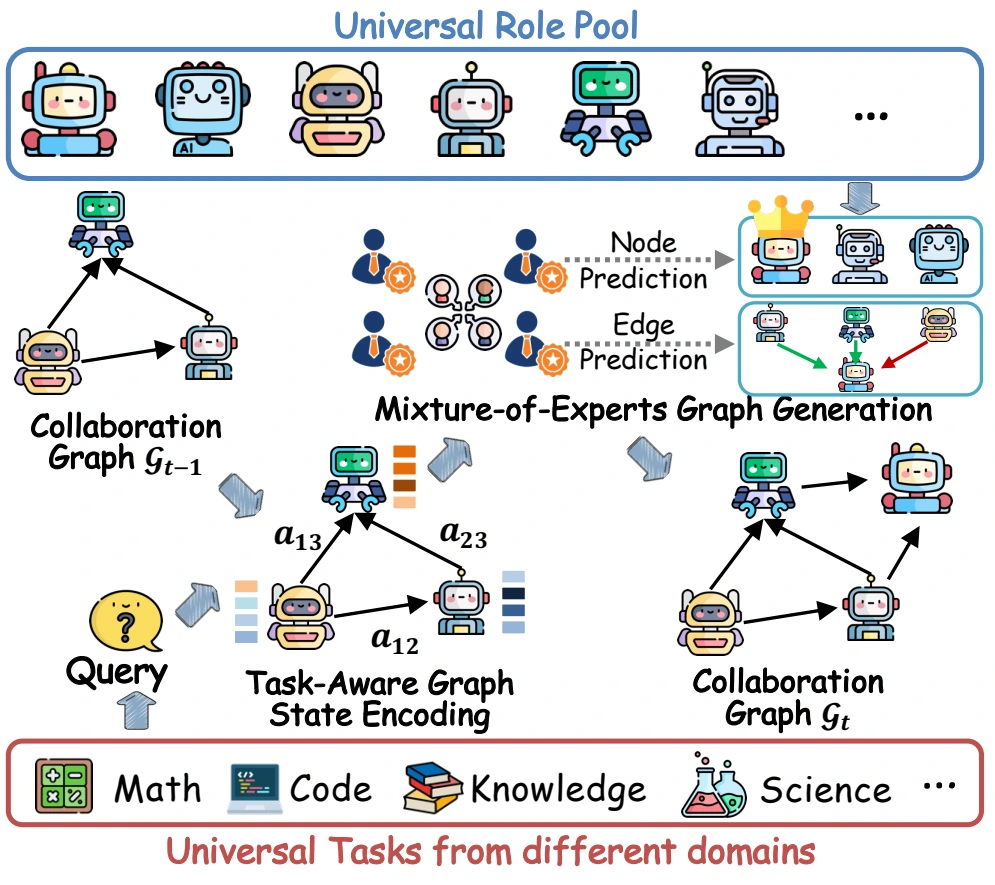
图1a,PDF 第2页。统一设计器根据任务与角色信息生成协作图;一个设计器可以输出不同的多智能体配置。
为了实现这一点,论文提出两个相互配合的设计:TAGSE 让当前图的表示受到任务语义影响;MoE 用多个内部网络建模不同的生成策略。随后通过三个阶段训练,逐步建立结构先验与任务匹配能力。
2. 先区分角色池、当前团队和 MoE 专家
理解整篇论文,最容易混淆的是下面三个对象。
| 对象 | 包含什么 | 是否已经在执行题目 |
|---|---|---|
| 统一角色池 | 19 个候选角色及其描述,例如编程专家、检查者等 | 否,候选描述只作为选择依据 |
| 当前协作图 | 已经选入的角色节点,以及已有的有向连接 | 构图时主要处理向量;图生成后才执行协作 |
| MoE 内部专家 | 默认 8 个小型神经网络 | 它们参与图预测,不是 8 个实际对话的 LLM 智能体 |
因此,“候选池有 19 个角色”不等于“先让 19 个角色都解题,再根据表现淘汰”。推理时,模型每一步给候选角色打分,选择一个角色添加为节点,或选择结束。
论文用有向无环图 表示团队。节点对应具有特定角色的智能体,边 表示 可以接收 的信息。一个角色类型也可以对应多个节点;核对的 sample() 没有屏蔽已经用过的角色,因此不能把“生成 4 个节点”直接理解成“选择 4 种不同角色”。
3. 整体流程:为一道题逐步构建一张图
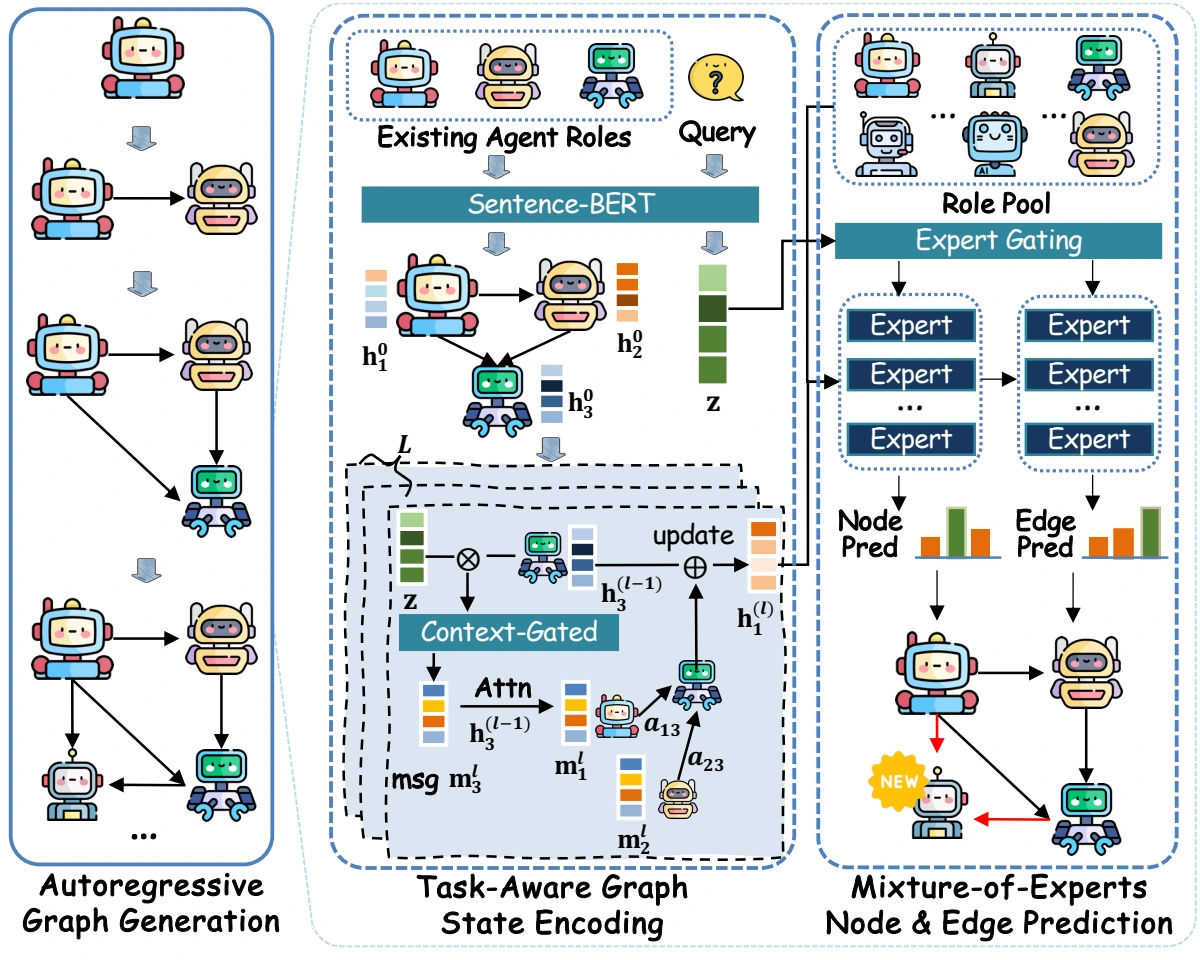
图2,PDF 第4页。输入任务与角色表示;TAGSE 编码部分图;生成模块预测新节点角色和与已有节点的连接。
模型学习的目标可以写成:
是当前题目, 是前面已经生成的部分图。第 步先预测新节点 的角色,再预测从已有节点指向它的边 。
对单独一道题,过程就是:
题目 → 编码任务
     → 编码当前部分图
     → 选择下一角色或 END
     → 添加节点并预测它的入边
     → 更新部分图,继续生成
     → 结束后让智能体按图解题
这里的“逐步”指一道题内部的节点生成步骤,不是按题库顺序一边做题、一边扩充同一张长期存在的图。下一道题会重新生成自己的协作图。
链式、星式或分层结构来自节点与边的组合,推理时不必先输出一个拓扑名称。教学示例:已有 ,加入 时,若只连接 ,就延伸成链;若只连接 ,则形成从 向外分支的结构;若两条都连接,则得到另一种 DAG。
训练数据包含典型拓扑,不代表推理过程只是从“链式、星式、分层”几个名称中选择一个。生成器实际作出的决策是节点角色与具体连接;训练样本分布仍然会影响它偏好的结构。
4. TAGSE:根据题目重新表示当前团队
TAGSE 的全称是 Task-Aware Graph State Encoder,即任务感知图状态编码器。它回答的是:结合当前题目,已有团队中的哪些特征、哪些信息关系应该在表示中更突出?
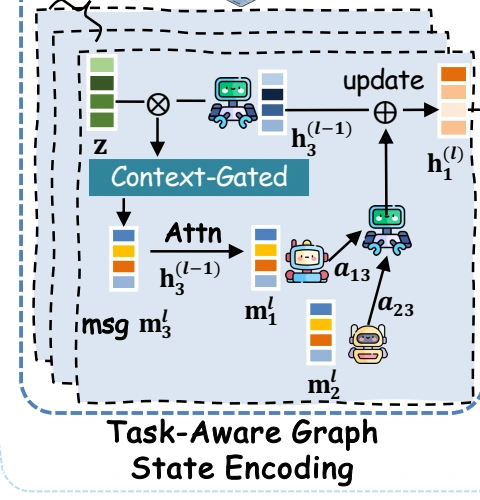
图2局部,PDF 第4页。任务信息调节节点消息,再通过图上的注意力聚合得到新的节点表示。
4.1 输入的是向量和连接,不是已完成的智能体对话
角色描述与题目通过 Sentence-BERT 编码。附录采用 all-MiniLM-L6-v2,输出 384 维向量;任务再投影成 128 维表示 ,角色节点投影到 256 维隐藏空间。TAGSE 默认堆叠 4 层。
在核对的生成代码中,已有节点首先保存的是角色嵌入。每次新增节点后,模型根据更新后的邻接矩阵重新编码这些角色嵌入,并没有先执行全部智能体的自然语言推理再编码回答。
4.2 第一个操作:任务条件下的通道门控
论文式(5)为每个节点计算消息:
可以把它拆成两部分:先把节点表示变换为候选消息,再根据“节点表示+题目表示”算出一组 0 到 1 之间的门控值,逐通道相乘。
一个节点的 256 个通道可以理解为 256 个可调节的信息位置。门控较小,对应位置的信息贡献减弱;门控较大,对应位置保留得更多。不能未经分析就把某个具体维度命名为“数学能力”或“编程能力”。
对应的官方代码很直接:
raw_message = F.relu(self.W_m(h))
gate = torch.sigmoid(self.W_g(torch.cat([h, z], dim=1)))
gated_message = gate * raw_message
代码还对门控值加入平均 L1 惩罚,鼓励表示层面的选择性。它没有在这里删除角色节点,也没有修改邻接矩阵。
4.3 第二个操作:按注意力聚合邻居消息
论文式(6)根据节点表示与接收端的任务门控消息计算注意力分数,再在式(7)中归一化,得到邻居消息的加权和:
直观上,它决定“在编码当前节点时,各个邻居提供的向量信息占多大比重”。这与实际传递多少字的回答是两回事:这里处理的是图生成器内部的数值表示。
最后,论文式(8)把聚合结果与原有表示取平均:
括号内两部分都乘以二分之一。经过多层更新,输出仍然是一组节点表示,节点数量没有因 TAGSE 自动减少。
4.4 公开实现的注意力边界
对应实现位于 MAGNetLayer,第26–65行。关键语句是:
zero_vec = -9e15 * torch.ones_like(e)
attention = torch.where(adj > 0, e, zero_vec)
attention = F.softmax(attention, dim=1)
agg_message = attention.t() @ gated_message
h_new = (agg_message + h) / 2
这里有一个需要单独理解的实现问题:某一行如果没有有效边,所有位置都会被填成相同的有限负数,Softmax 后得到均匀分布,并非全零。
例如教学用图 ,按该实现的掩码与归一化规则,有:
邻接矩阵                 注意力矩阵
0 1 0                    0   1   0
0 0 1                    0   0   1
0 0 0                   1/3 1/3 1/3
最后一行表示无出边节点 C。结合后续转置乘法,它可能把贡献传到原图没有连接的位置。另外,NetworkX 邻接矩阵按“行源节点、列目标节点”排列,代码沿行归一化再转置聚合,与论文按接收节点邻居集合描述的归一化方式也应分别核对。
因此,解释论文意图时可以说“沿邻居聚合”;复现这个固定提交时,不能直接假定代码严格排除了所有非邻接消息。这里指出的是掩码与矩阵运算的直接性质,不等同于测量了它对最终基准成绩的影响。
5. MoE 怎样预测下一个节点并筛选角色
TAGSE 输出多个节点的新表示后,下一步需要把它们变成对候选角色的判断。
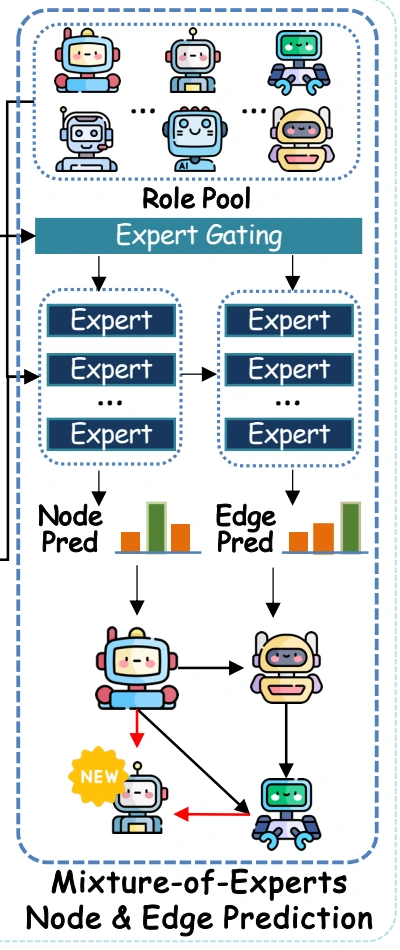
图2局部,PDF 第4页。多个内部专家网络在任务路由权重下参与节点和边生成。
5.1 汇总当前团队
代码对 TAGSE 编码后的节点向量取平均,再经过一个小网络:
g = self.graph_readout(torch.mean(h_encoded, dim=0))
是当前部分图的整体表示。由于节点向量已经受到任务信息影响,这个汇总也间接包含了题目条件。
5.2 按题目计算专家权重
路由网络接收任务向量 :
默认有 8 个专家,因此输出 8 个权重。核对的代码没有使用 Top-k 截断,而是将所有专家的结果加权求和。论文和代码中的这一权重只依赖题目;同一道题的构图循环内,它不随图的扩展重新变化,专家输出则会随输入图表示改变。
5.3 生成“下一位成员需求”的向量
实际代码的角色预测路径是:每个专家接收 并输出一个 384 维向量,再按路由权重混合:
为了便于理解,可以把 比喻成“下一位成员需要具备什么特征”。例如,已有成员负责分析和实现,接下来可能更需要检查。这只是教学解释,模型实际输出的是数值向量,并不会先生成这句自然语言。
5.4 给整个候选池打分,再选择一个候选项
候选池中的每个角色都有描述嵌入 。代码计算点积作为分数:
对应代码为:
q_t = self.moe_query_net(g_t_minus_1.unsqueeze(0), moe_weights)
node_logits = q_t @ candidate_embeddings.t()
node_probs = F.softmax(node_logits, dim=1)
sampled_candidate_idx = torch.multinomial(node_probs, 1).item()
候选项包括全部角色与 END。sample() 按概率抽取一个候选项,因此概率最高的角色更容易被选中,但并非每次必选。若选到普通角色,就创建一个节点;若选到 END,就停止。
“从 19 个角色中筛选几个”,正是通过这一轮轮选择实现的:每轮选一个,更新图后再选,直到停止或达到规模上限。代码不会先独立筛出一个小角色池,再从中生成图;也没有执行候选角色来逐个验证。
论文式(10)在描述上将角色分布写作专家预测的混合;这个固定实现则先混合专家输出的查询向量,再与候选角色嵌入点积,最后统一 Softmax。这两种表达不能未经说明就当作同一个逐项计算过程。对应实现见 MoELayer 与角色生成入口。
6. 选好角色后,怎样决定与谁连接
假设本轮选中了新角色 ,已有节点为 。边预测网络分别接收每个旧节点的编码、新角色的嵌入和任务表示:
多个边专家的输出按同一组任务权重混合,再经过 Sigmoid,得到旧节点 指向新节点 的概率。代码随后对每条候选边做 Bernoulli 采样:
edge_logits = self.moe_edge_net(edge_net_input, moe_weights_repeated)
edge_probs = torch.sigmoid(edge_logits)
edge_samples = torch.bernoulli(edge_probs)
上面省略了张量维度处理,moe_weights_repeated 表示按已有节点数复制的专家权重,属于便于阅读的代码节选。
所有新边都从已有节点指向新节点,因此按照生成顺序形成 DAG。若本轮没有采到任何边,官方代码会强制连接概率最高的一个旧节点;首个节点没有这项操作。
附录的推理配置是最少 2 个节点、最多 6 个节点。代码在未达到最少节点数时禁止 END,并在上限处终止。sample() 从空图开始;虽然模型定义了 START 嵌入,该入口没有先把 START 加入图中。
例如下面的三步过程只是一种可能的教学结果:
第1步:选编程专家,当前只有一个节点。
第2步:选测试分析师,预测编程专家 → 测试分析师。
第3步:选算法设计师,预测测试分析师 → 算法设计师。
后续:选到 END,完成构图。
这个过程说明,“预测下一个节点”与“筛选角色”基本是同一次决策的两个说法;“预测连接”则是随后的另一项决策。前者决定谁加入,后者决定新成员从谁那里接收信息。
7. 它与剪枝、预测下一个智能体的方法有什么关系
从输出空间看,角色选择与拓扑生成之间并没有不可跨越的界限。
典型剪枝方法从预设候选图出发,删除部分连接或节点;OFA-MAS 从部分图出发,逐步增加角色与连接。这是构造过程与参数化方式的不同。如果候选图足够丰富,剪枝也可能覆盖相同的最终结构。
同样,若已有方法已经能够选择下一个角色、预测连接,并使用停止动作,那么它也可以在角色池中逐步组队。不能仅凭“从角色池选择成员”就断言 OFA-MAS 与所有已有方法在表达能力上有本质差异。
更准确的贡献定位是一个组合:统一角色池、多领域统一设计器、任务感知图状态编码、MoE 生成和三阶段训练。评价创新与效果时,需要比较这套组合及其训练设置,而不是把所有前作都归为固定顺序或简单剪枝。
8. 三阶段训练:先学搭结构,再学匹配题目
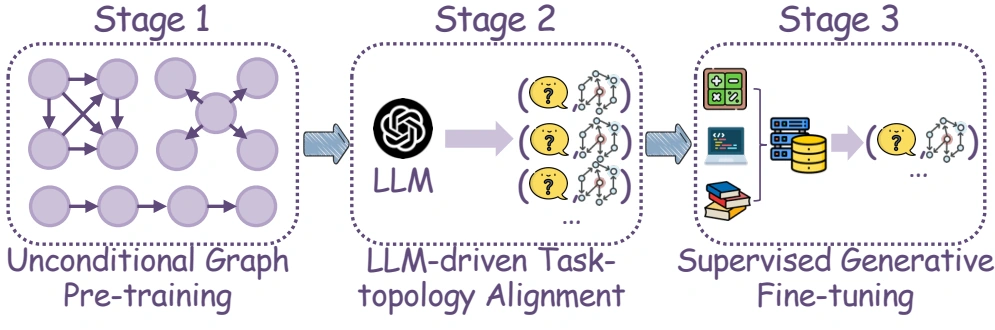
图1b,PDF 第2页。通用结构预训练、LLM 合成数据条件训练、真实任务高表现拓扑微调。
阶段1:学习基本协作图的结构规律
模型先在链式、星式、树式、分层、全连接等典型图上学习如何逐步生成节点与边。附录给出 800 张结构样本,规模覆盖 3~10 个节点。论文把此阶段的任务条件设为零,重点建立图结构先验。
这里的 3~10 是阶段1训练结构的规模,不能与推理默认的 2~6 个节点混为一谈。公开实现的无条件路径将原始任务嵌入置零后再经过带偏置的任务编码器,因此最终 是否严格为零,也与论文的直接表述有所区别。
阶段2:学习任务与角色、拓扑之间的对应
作者让 LLM 生成不同领域的“题目—团队配置”样本,配置包括角色、节点数与连接,再将其转成图数据。附录给出 1,000 个合成配对。
这个阶段提供伪标签,让模型学习“什么任务通常需要哪些角色和连接”。这些合成图不是通过穷举团队并实际解题得到的全局最优图。
阶段3:用真实任务上的高表现配置微调
作者在真实训练题上运行若干典型拓扑,依据执行表现选择配置,形成有经验依据的训练对,再微调生成器。附录表4为每个主要基准列出 40 道训练题。
这些图的含义是“在测试过的候选配置里表现较好的图”,并不等于所有可能角色与 DAG 中的最优解。附录 D.2 同时写出“1,000 个配对”和“每基准 40 题×6”,配对展开的具体计数需要结合数据文件进一步核对,不能把这两种口径直接当成相同样本数。
训练损失与推理时的选择要区分
训练使用 teacher forcing:根据真实前缀图,预测下一节点角色和应当添加的边。主要损失是节点分类交叉熵与边预测二元交叉熵,另外加入专家负载均衡与门控稀疏正则:
附录给出两个系数分别为 0.2 和 0.1。负载均衡用于鼓励训练批次层面的专家利用,门控正则约束 TAGSE 的特征通道。推理时则使用已经训练好的参数为新题生成图,不需要为每道测试题重新训练这套网络。
9. 主实验:一个统一模型能否超过专用模型
实验流程是“给测试题生成图—按图运行智能体—评估最终答案”。MMLU 测综合知识,GSM8K、AQuA、MultiArith、SVAMP 测数学推理,HumanEval 测代码生成。前几类主要报告正确率,HumanEval 报告 Pass@1,即一次生成的程序通过测试的比例。
对照包括单智能体提示、固定图、辩论,以及 AgentPrune、AgentDropout、G-Designer、EIB-LEARNER 等学习型设计器。论文设置为 OFA-MAS 训练一个统一模型,学习型专用基线分别按数据集训练。
附录给出的 OFA-MAS 执行配置为 GPT-4o、temperature 0、一轮协作。一轮协作仍可包含多个节点依照图依赖执行,不等于整个团队只调用一次 LLM。
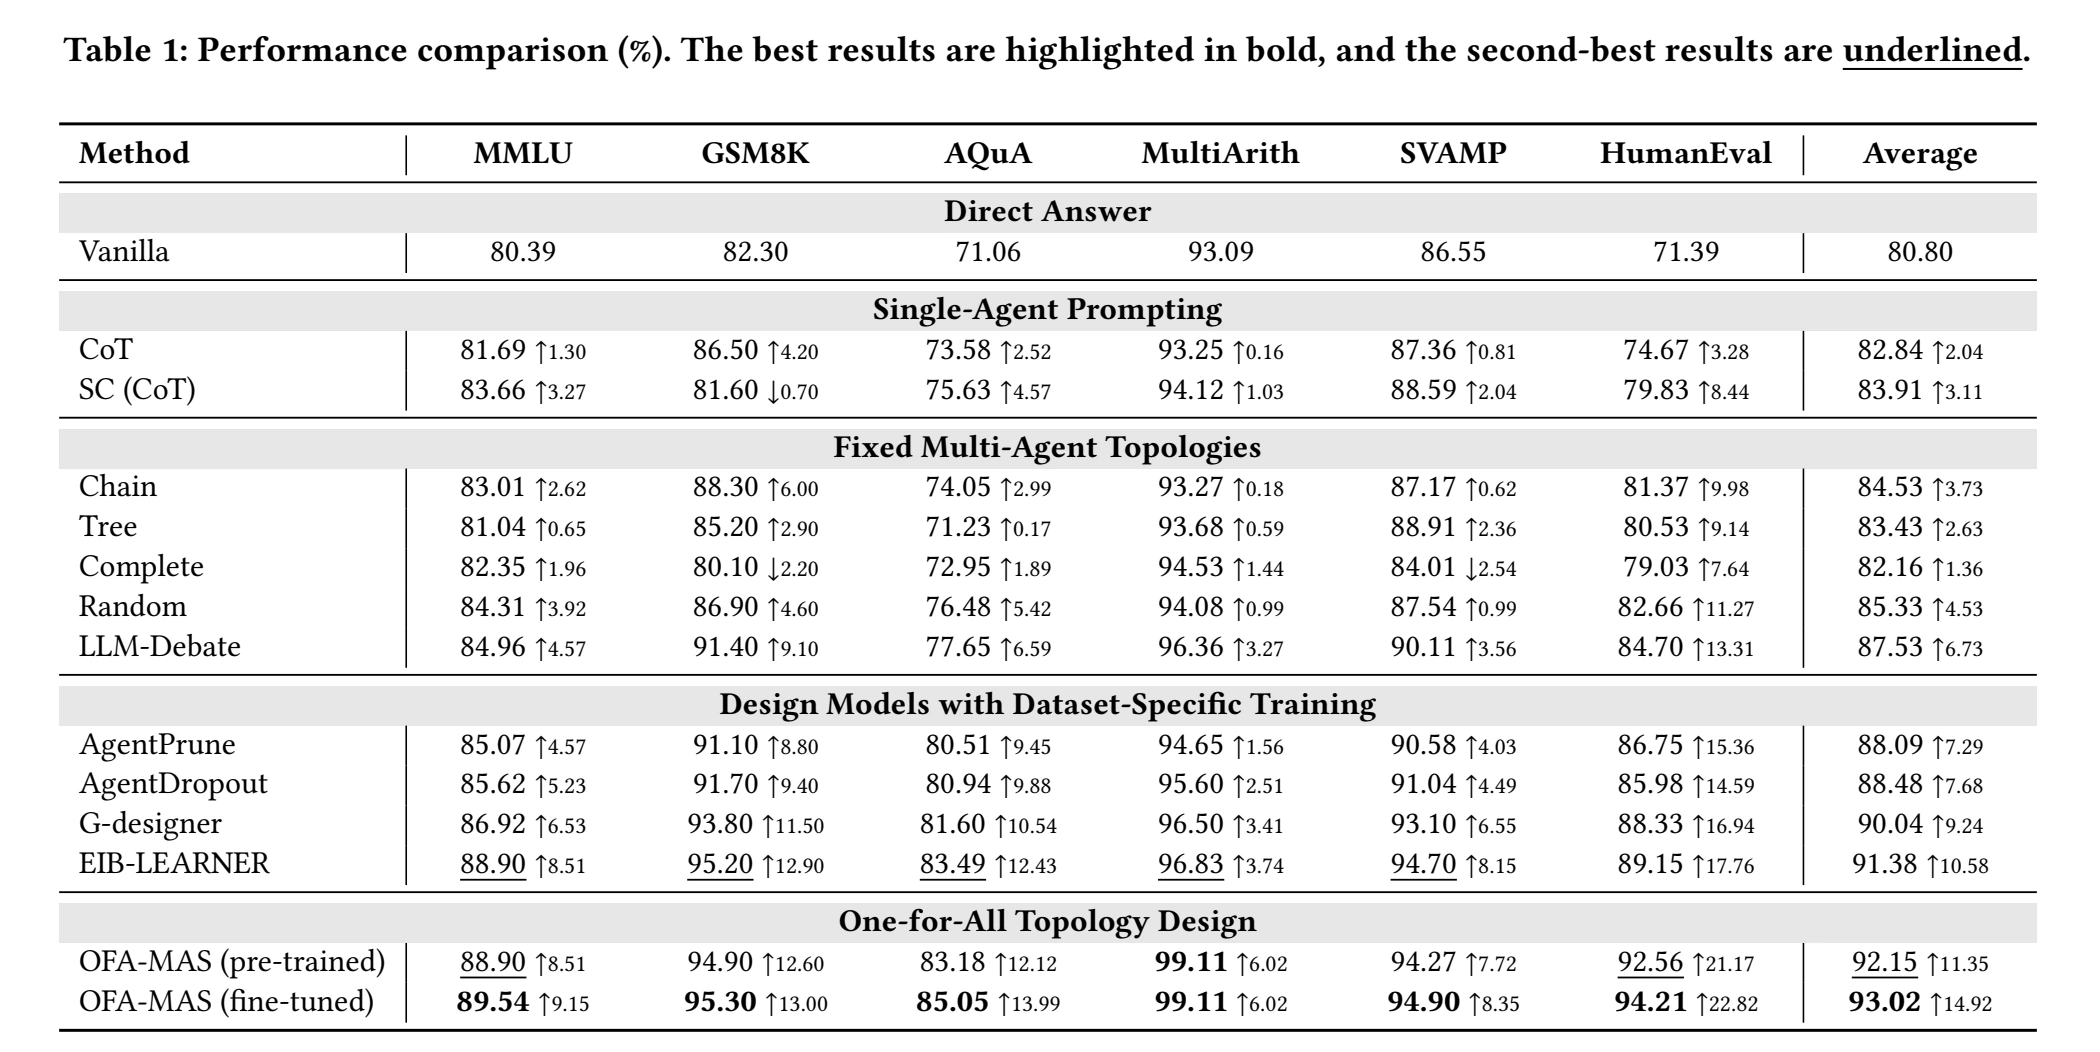
表1,PDF 第6页。各数据集成绩单位为百分比,Average 是六列成绩的算术平均。下方摘录保留原始成绩,增幅按相减计算。
| 方法 | 六数据集平均成绩 |
|---|---|
| 直接回答 | 80.80% |
| 固定链式图 | 84.53% |
| LLM-Debate | 87.53% |
| AgentPrune | 88.09% |
| AgentDropout | 88.48% |
| G-Designer | 90.04% |
| EIB-LEARNER | 91.38% |
| OFA-MAS,仅阶段1和阶段2 | 92.15% |
| OFA-MAS,完整三阶段 | 93.02% |
完整模型比最强基线 EIB-LEARNER 高 1.64 个百分点。阶段1和阶段2的版本也高于该基线,说明在这些报告条件下,合成数据与结构预训练已经能支持较有竞争力的统一设计器。这里预训练、微调的对象是拓扑生成器,而不是重新训练 GPT-4o。
提升并非在每项任务上同样明显。HumanEval 从 EIB-LEARNER 的 89.15% 提高到 94.21%,增加 5.06 个百分点;GSM8K 则从 95.20% 提高到 95.30%,仅增加 0.10 个百分点。代码任务上的优势更明显,部分数学指标上的差距较小。
表1末格把相对直接回答的平均增幅标成了 14.92,但 。平均成绩本身与六列计算一致;解释提升幅度时应使用 12.22 个百分点,不能沿用该箭头标注。
10. 新任务泛化与组件消融
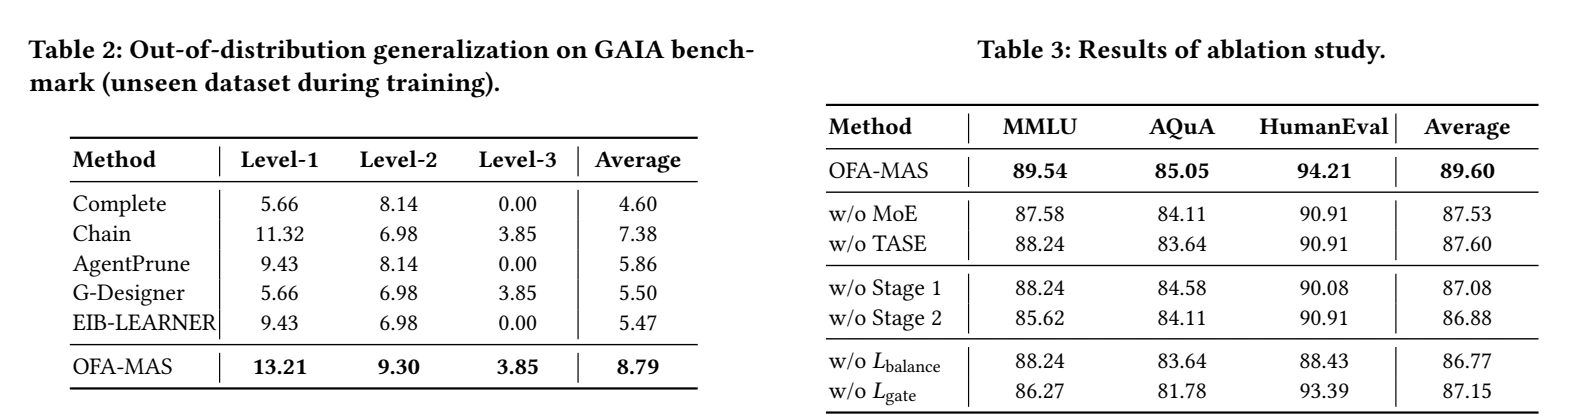
表2、表3,PDF 第7页。左侧为训练时未见的 GAIA,右侧为 MMLU、AQuA、HumanEval 三项消融。两张表使用不同评估集合。
10.1 GAIA:对训练之外的数据集迁移
GAIA 未参与训练,分为三个难度等级。OFA-MAS 直接迁移,专用基线采用在 MMLU 上训练的模型。这既是在比较迁移结果,也包含统一模型多领域训练与专用模型训练范围的差异。
| 方法 | GAIA 三等级平均正确率 |
|---|---|
| 全连接 | 4.60% |
| 链式 | 7.38% |
| AgentPrune | 5.86% |
| G-Designer | 5.50% |
| EIB-LEARNER | 5.47% |
| OFA-MAS | 8.79% |
OFA-MAS 的平均成绩最高,但绝对正确率仍低。该实验使用 GPT-4o-mini,并未启用工具调用等 agentic 能力。因此,它支持“在这个受限设置下具有较好的相对迁移表现”,不能直接与完整联网、工具型 GAIA 系统比较,也不足以证明任意新领域都能有效解决。
10.2 消融:去掉组件后表现怎样
消融只使用 MMLU、AQuA、HumanEval 三项,完整模型平均为 89.60%。它与表1的六数据集平均 93.02% 不是同一口径。
| 配置 | 三项平均成绩 | 对应验证的问题 |
|---|---|---|
| 完整模型 | 89.60% | 参照 |
| 去掉 MoE | 87.53% | 多个内部专家是否有帮助 |
| 去掉任务感知编码,表中写作 TASE | 87.60% | 结合任务理解部分图是否有帮助 |
| 去掉阶段1 | 87.63%(按三列重算) | 结构预训练是否有帮助 |
| 去掉阶段2 | 86.88% | 合成任务与拓扑对齐是否有帮助 |
| 去掉负载均衡损失 | 86.77% | 专家利用约束是否有帮助 |
| 去掉门控稀疏损失 | 87.15% | 特征通道约束是否有帮助 |
去掉每项设计后,报告结果均有所下降,支持它们对该设置有贡献。阶段1的三列为 88.24、84.58、90.08,平均约 87.63,原表平均列写作 87.08;这里明确采用重算值。
这些消融支持组件有效,但不能仅凭此表断言某个专家具有特定语义,或将去掉门控约束直接解释为“增加了无用智能体”。后者仍然是节点表示层面的正则。
11. 鲁棒性、生成案例与专家分工
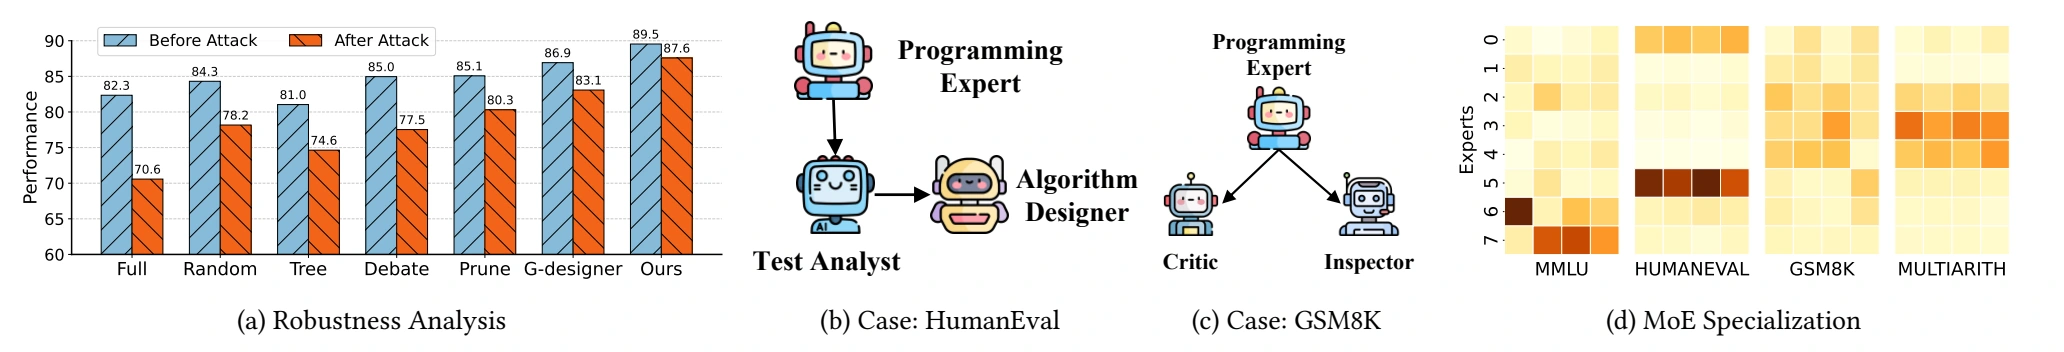
图3,PDF 第8页。依次为模拟智能体被误导的鲁棒性、HumanEval 与 GSM8K 生成图、四个领域的专家路由权重。
11.1 一个关键智能体被误导时
作者用恶意提示替换关键角色提示,使其产生误导信息,再比较攻击前后的表现。OFA-MAS 从 89.54% 降到 87.58%,下降 1.96 个百分点;论文所述约 2.2% 是相对下降比例。图中其他方法在这项攻击设置下下降更多。
该实验展示了一种受控攻击下的相对稳定性,并没有单独证明 TAGSE 或某一种图结构就是抗攻击的原因,也不代表涵盖所有攻击方式。
11.2 同一个生成器可以输出不同结构
HumanEval 案例为“Programming Expert → Test Analyst → Algorithm Designer”,形成链式信息流。GSM8K 案例由 Programming Expert 分别连接 Critic 与 Inspector,形成分支。
这展示了从统一角色池选择角色与预测连接的灵活性,也说明数学题可以使用通常被联想到编程或评论的角色。两个案例是可视化例子,不代表模型在整个数据集上总使用同一结构,或这种角色组合必然最优。
11.3 热力图里是内部专家权重
图3d 每一行是一个内部专家,每个领域下的列是若干任务样例,颜色深浅表示路由权重。相同领域的模式较接近,不同领域的偏好有所不同;例如 HumanEval 对专家5赋予较高权重,MMLU 对另一组专家更偏重。
这种现象支持路由器学出了任务相关偏好,但不等于专家被人为指定为“程序员、数学家、医生”。热力图也不表示已经从 19 个角色中选择了哪些成员,更不能据此推断使用了 Top-k 稀疏路由。
12. 效率:较高准确率是否需要更多 Token
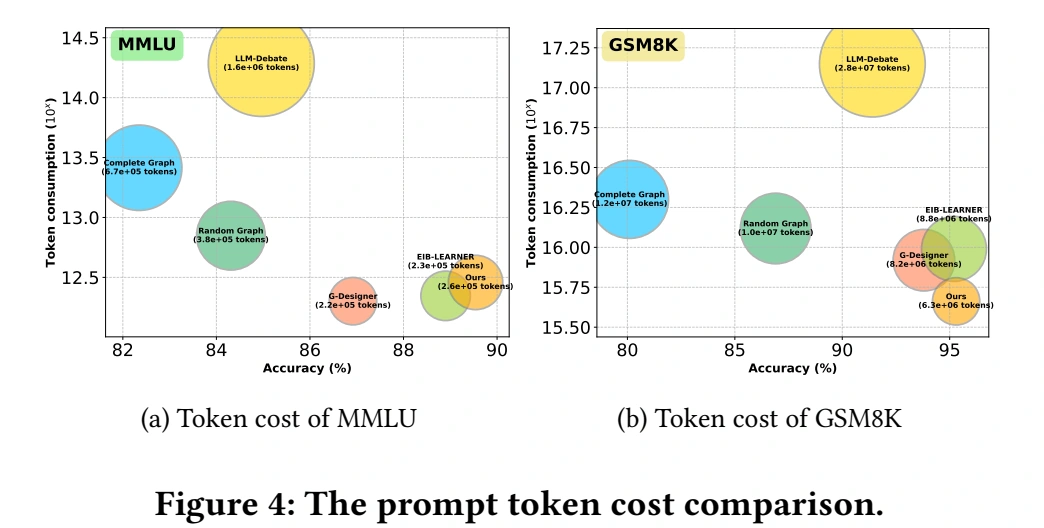
图4,PDF 第8页。横轴为准确率,气泡标注为实际 Token 数;具体成本以下表与气泡内数字为准。
| 数据集 | OFA-MAS | G-Designer | EIB-LEARNER |
|---|---|---|---|
| MMLU | 约 26 万 Token | 约 22 万 Token | 约 23 万 Token |
| GSM8K | 约 630 万 Token | 约 820 万 Token | 约 880 万 Token |
MMLU 上,OFA-MAS 的准确率更高,Token 开销略高于这两个学习型基线,体现的是效果与成本的权衡。GSM8K 上,它在图中所列方法里同时达到更高准确率和更低 Token 成本;按标注值计算,相对 G-Designer 约节省 23%。
因此,论文支持“在所测任务上具有较好的准确率—通信成本权衡”,不能改写成“所有任务都最省 Token”。这张图也没有完整核算训练、数据合成、GPU 推理与端到端延迟等总成本。
13. 局限、实现边界与核心结论
首先,统一模型在多个测试集上取得较好成绩,仍不等于可以处理任意任务。主要测试集中有四个数学数据集;GAIA 的绝对表现较低,测试时还限制了工具能力。泛化结论需要保留具体任务范围。
其次,表1比较的系统不仅在模块上不同,角色池、训练领域和训练数据组织也有差别。组件消融提供了部分证据,但要进一步分离“更多角色”“联合训练”“MoE 架构”各自带来的收益,需要更细的对照。
第三,训练标签来自典型结构、LLM 合成配置和有限候选中的执行结果,没有提供所有可能团队的最优标签。固定的角色池与推理节点上限也界定了可生成系统的范围。
第四,主结果没有报告多次运行的误差范围。尤其是 0.10 个百分点这类小差距,不能单凭一次表格就断言稳定显著领先。注意力空邻居行、归一化方向、无条件任务编码,以及查询向量式角色预测等代码细节,也需要在复现时分别核对;本文未将静态检查当成完整运行验证。
OFA-MAS 的核心思路是:用一个统一的生成器为不同题目逐步组队。TAGSE 根据题目更新已有团队的向量表示,MoE 参与下一角色和连接的预测,END 与规模上限决定何时结束。三个训练阶段把基本结构规律、任务匹配经验与真实任务表现依次引入同一模型。
它的价值应放在这套统一设计与训练方案中理解。角色选择、停止动作和图生成并非各自独立的新能力;论文将它们与任务感知编码、专家混合及课程式训练结合,并通过多任务实验验证了这个组合在所报告条件下的效果。
来源与复现入口
- OFA-MAS 原论文,arXiv v1:方法见第3–6页,实验见第6–8页,数据与配置见第10–12页。
- 固定提交的官方代码:避免将后续修改与本文分析混用。
model_ofa.py:TAGSE 与 MoE 实现。sample():角色采样、停止与边生成。args_ofa.py:维度、层数与专家数配置。
See also
- PCFNet 论文解读:用频域特征与物理约束预测海表温度 2026-10-28
- AutoPrune 论文解读:让 LLM 设计视觉 Token 剪枝规则 2026-10-22
- M³Prune 论文精读:先组内讨论,再跨模态协作,怎样剪掉多余通信 2026-10-19
- RADAR 论文精读:扩散模型如何自动生成多智能体通信图 2026-10-19
- AgentPrune 论文精读:学习谁该听谁,让多智能体通信更省 token 2026-10-18