GenQ 论文精读:用生成式合成数据完成无数据与少数据量化
低位量化能够减少模型权重和激活的表示成本,但量化误差通常需要通过校准或微调来控制。当部署方只有预训练模型、拿不到原始训练数据时,数据本身成为量化的限制因素。
GenQ 借助预训练文本到图像扩散模型生成候选图片,再利用目标模型筛选;如果有少量真实图片,则先学习一个共享提示词嵌入,引导生成更贴近目标数据集的图片。最终,合成数据用于目标分类模型的 PTQ 或 QAT。
本文依据用户提供的 19 页论文正文以及官方两页补充材料。实验数字为作者报告,未独立复现;教学算例、重写公式和代码示意均作明确标注。图片均裁取自原论文,图号和页码保留用于查证。
论文信息与术语
| 项目 | 信息 |
|---|---|
| 题目 | GenQ: Quantization in Low Data Regimes with Generative Synthetic Data |
| 作者 | Yuhang Li、Youngeun Kim、Donghyun Lee、Souvik Kundu、Priyadarshini Panda |
| 发表 | ECCV 2024;arXiv:2312.05272 |
| 单位 | Yale University、Intel Labs |
| 研究对象 | ImageNet 分类模型的低数据量化 |
| 生成模型 | Stable Diffusion v1-5 |
| 来源 | 正式正文、补充材料、预印本 |
| 术语 | 含义 |
|---|---|
| PTQ | Post-Training Quantization,训练后量化;可以包含校准和局部重建优化 |
| QAT | Quantization-Aware Training,量化感知训练;训练时模拟量化并微调 |
| DFQ | Data-Free Quantization,不访问目标任务的原始训练数据 |
| DSQ | Data-Scarce Quantization,可访问少量目标训练数据 |
| W2A4 / W4A4 | 权重分别为 2 / 4 位,激活为 4 位 |
| BN | Batch Normalization,批归一化 |
| OOD | Out-of-Distribution,分布外 |
| STE | Straight-Through Estimator,直通估计器 |
| Token embedding | 提示词中的词元嵌入,是可优化的数值向量 |
这里的“无数据”限定于目标任务训练集。Stable Diffusion 自身已经在外部数据上预训练,方法仍依赖这个生成先验。
1. 目的与动机:为什么量化需要合成数据
模型量化把高精度数值映射到有限的离散刻度。位宽越低,可用编码通常越少;误差可能经过网络逐层传播,导致准确率下降。PTQ 用少量输入观察激活、校准量化参数或优化局部输出;QAT 则需要更多数据进行端到端微调。
原始训练集可能因隐私、知识产权或版权限制而不可访问。既有无数据方法通过目标模型的输出及内部统计反演图片,或训练 GAN 生成图片,但有限的分类信息和特征约束不唯一决定自然图片,复杂物体的恢复也可能成本较高。依赖 BN 统计的反演方法还难以直接迁移到没有 BN 的 ViT。
GenQ 的问题设定因此是:能否借用成熟生成模型提供的图像先验,同时通过目标模型的响应选择适合量化的数据?
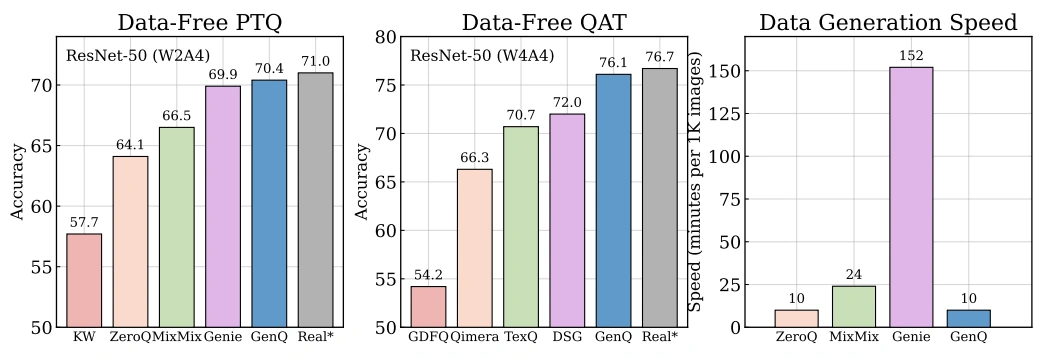
原文图 1,正文第 2 页。左为 ResNet-50 W2A4 PTQ,中为 W4A4 QAT,右为每生成 1000 张图片的耗时。Real 是使用真实数据的量化对照,不是全精度模型。*
图 1 报告 GenQ 的 PTQ 准确率为 70.4%,真实数据对照为 71.0%;QAT 分别为 76.1% 和 76.7%。这些数字支持该设置下接近真实数据的量化效果。图中的耗时与后文表 1 不一致,不能据此直接确定统一的加速倍数,详见实验与边界部分。
2. 无数据生成:类别名称如何变成图片
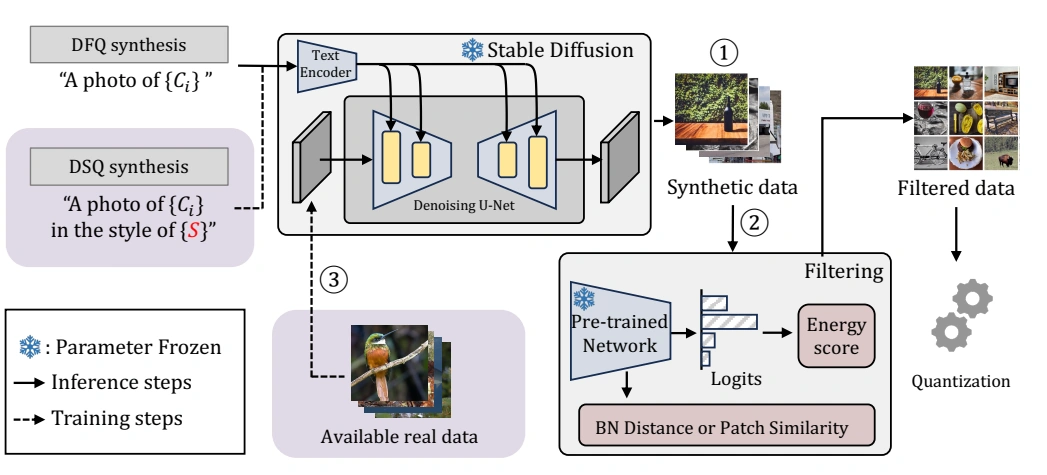
原文图 2,正文第 6 页。①是类别条件生成,②是模型相关筛选,③是少量真实图片驱动的提示词嵌入学习。雪花表示参数冻结,实线和虚线分别表示推理与训练路径。
2.1 构造提示词
DFQ 假设类别名称和预训练全精度分类模型可用。正文公式(4)给出模板:
A photo of a {D} {C}
其中 C 是类别,D 是描述词,例如 small、dark、nice。以 hamster 为例,得到“A photo of a small hamster”。补充材料列出的实际模板更丰富,包括照片、裁切、特写、明暗以及 rendering / rendition 等表达;正文模板是概括,不能理解为全部提示词仅有一个形式。
生成阶段依靠类别和 Stable Diffusion,不需要目标分类模型参与逐步图像优化。目标模型在后续筛选阶段发挥作用。
2.2 文本编码、潜空间去噪与解码
令提示词为 P,文本编码器得到条件向量 。从高斯分布采样潜噪声 后,去噪 U-Net 根据当前潜变量、时间步和文本条件预测噪声:
采样过程反复利用预测结果更新潜变量,得到较干净的 ,随后图像解码器输出图片 。这是对原文 §3.2 的统一记号重述。
同一类别可以通过不同的噪声起点和提示词条件生成不同图片。无数据场景下不重新训练扩散模型。论文使用 Stable Diffusion v1-5,guidance scale 为 3.5,但未明确给出生成分辨率、采样器、采样步数和生成 batch size。
2.3 去噪 U-Net 与分割 U-Net 的区别
两者共享下采样、上采样和跳跃连接的 U 形结构,但目标不同。
| 对比 | 经典医学分割 U-Net | 此处 Stable Diffusion 的去噪 U-Net |
|---|---|---|
| 输入 | 待分割图像 | 带噪声的图像潜变量 |
| 条件 | 经典版本主要为图像输入 | 时间步、文本嵌入 |
| 输出 | 空间位置的类别分数 | 噪声预测 |
| 监督 | 分割掩膜 | 人为加入的已知噪声 |
| 推理 | 通常一次前向得到分割 | 多次调用后再经图像解码器输出图片 |
交叉注意力使文本进入去噪过程。去噪 U-Net 的一次输出不是最终图片。现代分割变体也可能使用注意力和残差块,因此上述比较针对经典分割结构及本文具体生成模型。可参见 U-Net 原论文和潜扩散模型原论文。
3. 模型相关筛选:真实感不等于量化适用性
合成图片可能具有正确类别,却在背景、构图、纹理等方面偏离目标模型的训练分布。量化使用的是网络响应,因此仅凭视觉观感不能保证数据有效。GenQ 将选择候选数据视为 OOD 检测问题,先做能量筛选,再按模型结构进行第二阶段筛选。
3.1 能量筛选
将候选图片输入目标全精度模型,从分类 logits 计算能量分数。作者报告保留低于设定阈值的样本,排除能量较高的样本。这个分数是分布相关指标,不能保证所有保留样本都属于原始训练分布。
需要注意,正文公式(5)及 arXiv HTML 中的能量表达式,与其引用的标准分类能量定义在形式上不同。本文保留作者描述的筛选方向,不将该式擅自改写为标准表达,也不据此提供声称等同作者实现的代码;复现时应核对具体实现及分数约定。标准定义可查原始能量 OOD 论文。
3.2 CNN:BN 距离与 BN 敏感度
利用模型保存的训练期 BN 统计,将合成输入的层内均值和方差与参考统计比较。按原文公式(6):
这里沿用作者的 sigma 记号表示文中所称的方差统计。该指标检查特征分布,不是逐像素比较真实与生成图片。
作者指出,单张图片的 BN 距离没有充分考虑批次组合。于是对一批图片 B 中的样本 ,定义:
如果去掉一张图片后距离明显减小,则它的敏感度较大,意味着它可能破坏该批数据与目标统计的匹配。筛选优先排除这类样本。该判断依赖批次,不是图片自身固定不变的质量标签。
3.3 ViT:patch 相似度分布
没有 BN 时,GenQ 对 patch 特征两两计算余弦相似度:
之后用核密度估计得到相似度值的概率密度,通过微分熵衡量其分布多样性,并选择较高多样性的图片。这里希望相似关系多样,不是要求所有 patch 都互不相似;该指标也不能直接替代图像质量评价。
4. 少数据生成:从图片学习一个共享文本条件
如果每个类别可访问一张真实图片,ImageNet 的 1-shot 设定约有 1000 张真实图片。GenQ 构造:
A photo of a {C[i]} in the style of {S}
C[i] 提供物体类别,S 是跨类别共享的可学习提示词嵌入。它不必对应一句可读的自然语言描述;作者希望它表达整个数据集的共同特征,而不是某一具体物体。
学习过程将真实图片编码成潜变量,随机加噪,再让冻结的 U-Net 在类别与 S 的条件下预测噪声。通过噪声预测误差更新 S。采用统一潜空间记号的教学重述为:
这一步不是每次完整生成图片后做像素差比较。补充材料明确冻结图像编码器、解码器、文本编码器和去噪 U-Net,只更新提示词嵌入。训练配置为 Adam、恒定学习率 、batch size 32、50,000 步;正文说明嵌入用 ImageNet 初始化。
学习完后,用类别和固定的 S 生成图片,再执行相同筛选。少量真实数据提供生成引导,并不消除全部分布偏差。
5. 从数值量化到 PTQ 与 QAT
5.1 步长、零点、舍入与截断
正文公式(1)和(2)描述均匀量化:
s 是步长,z 是零点偏移,n、p 是允许的整数边界。整数编码 q 与其表示的实际数值 不同。b 位编码最多有 个状态;无符号编码可用 0 到 。这是编码计数说明,公式的实际边界还取决于量化方案。
教学算例:设 4 位无符号编码,s=0.1、z=8,编码 0 到 15 对应数值 −0.8 到 0.7。w=0.26 得到 q=11,表示 0.3;w=0.92 则因截断得到 q=15,表示 0.7。前者是舍入误差,后者还包含范围截断误差。
步长较小通常提高范围内的分辨率,但可覆盖的范围变窄;步长较大扩大范围,却增加刻度间距。权重和激活都可能量化,激活分布需要通过输入数据观察。
5.2 PTQ:优化网络响应而非孤立权重
对于 ,仅考虑权重量化时有 。权重误差的实际影响取决于输入,也可能互相抵消或叠加。
教学算例:两个权重均为 0.26,两个输入均为 1,原始输出为 0.52。全部舍入到 0.3 得到 0.6;一个舍入到 0.2、一个到 0.3,输出为 0.5,反而更接近参考值。
GenQ 用合成图片驱动全精度与量化网络,采用 BRECQ、Genie-M 等算法优化局部输出重建及舍入选择。这里重建的是网络块响应,不是重新生成图片。示意重建目标为:
该式是教学示意,不是 GenQ 新增的损失定义。以全精度响应为监督的重建本身不需要人工类别标注。
5.3 QAT:在 PTQ 基础上学习修正变量
正文公式(12)将 PTQ 结果写为:
作者用 sgn(v) 表示已经学习的舍入选择。为便于解释,以下将它简写为 r;r 不是论文新增的变量,也不意味着直接调用 PyTorch 的 sign 就是作者实现。
GenQ 冻结先前可学习变量,包括 w 和 v,新增零初始化的修正向量 u。公式(13)为:
u=0 时修正编码为 0,模型从原 PTQ 结果开始。之后 u 可以改变最终量化编码,即使原来的 w 和舍入变量保持冻结。这里相加的是基础编码与修正编码,不是把 PTQ、QAT 两种损失相加联合训练。
取整的真实导数无法提供有效梯度,作者采用 STE 更新 u:前向执行取整,反向采用近似梯度。固定步长且未截断时, 对 u 的 STE 梯度约为 1。
5.4 PyTorch 实现概念:Parameter 不等于可训练的离散值
从公式出发,u 可以用与权重同形状的 nn.Parameter 保存;连续舍入变量 v 也可以是 Parameter,但 r 通常是它经过变换后产生的舍入项。离散操作需要软化或梯度近似,Parameter 本身不会解决梯度问题。
以下仅为 u 与 STE 的教学片段,不是作者源码,也不包含完整量化器、激活处理或优化损失:
import torch
from torch import nn

def round_ste(x):
    return x + (torch.round(x) - x).detach()

# 下列示意固定 scale 和 PTQ 基础项,变量与权重同形状。
u = nn.Parameter(torch.zeros_like(weight))
base = (torch.floor(weight / scale) + r_hard + zero_point).detach()
correction = round_ste(u / scale)
q = torch.clamp(base + correction, qmin, qmax)
weight_q = scale * (q - zero_point)
u 还必须参与损失计算并交给优化器,才能更新。部署导出时可合并为最终整数编码,不必保留训练时的全部浮点辅助变量。作者公开代码链接在本文核验时返回 404,未能验证其具体参数命名、舍入函数或 QAT 损失实现。
6. 实验:合成数据到底改善了什么
以下均为 ImageNet Top-1 准确率,百分比之间的差值用百分点表示。真实数据行是对应量化算法的对照,不是全精度模型。
6.1 图片质量与内部统计
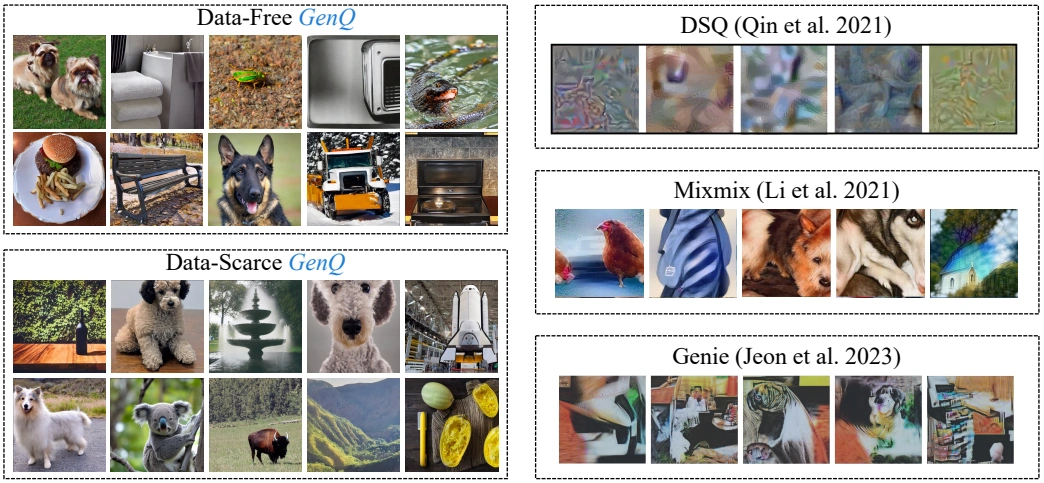
原文图 3,正文第 10 页。GenQ 展示的是筛选后的 DFQ / DSQ 图片,右侧为已有方法。
示例显示 GenQ 可以生成具有可辨识物体与背景的图片,但可视化不代表全部样本质量,也不能单独证明量化有效性。表 1 的 BN 距离在 ResNet-50 上为 Genie 0.014、GenQ 0.024;MobileNetV2 上则为 1.03 和 0.78。GenQ 并非所有统计指标都优于对照。
6.2 CNN 的无数据 PTQ
固定 Genie-M、W2A4、1024 张最终输入,表 2 报告:
| 数据来源 | ResNet-50 | MobileNetV2 |
|---|---|---|
| 真实数据 | 70.96% | 56.42% |
| Genie-D | 69.89% | 51.47% |
| GenQ | 70.35% | 54.82% |
GenQ 在 ResNet-50 上比 Genie-D 高 0.46 个百分点,距离真实数据对照 0.61 个百分点;MobileNetV2 上分别为提升 3.35、差距 1.60 个百分点。这支持对应设置下的合成数据有效性,并显示部分轻量模型的收益更明显。
6.3 ViT 的无数据 PTQ
固定 RepQ-ViT、W4A4、32 张最终校准图片,表 4 报告:
| 数据来源 | ViT-B | DeiT-B | Swin-B |
|---|---|---|---|
| 真实数据 | 67.93% | 75.99% | 72.80% |
| PSAQ-ViT | 60.18% | 74.69% | 54.21% |
| GenQ | 67.50% | 76.10% | 70.08% |
相对 PSAQ-ViT,ViT-B 和 Swin-B 分别提高 7.32 和 15.87 个百分点。它验证了非 BN 路线的适用性,但 Swin-B 仍落后于真实数据对照;DeiT-B 的小幅超过也只是具体设置下的结果。
6.4 无数据 QAT 与更低位宽
表 3 的 ResNet-50 结果为:
| 方法 | W4A4 | W3A3 |
|---|---|---|
| LSQ,120 万真实图片 | 76.70% | 75.80% |
| TexQ,合成数据 | 70.72% | 25.27% |
| GenQ,120 万合成图片 | 76.10% | 73.99% |
4 位时 GenQ 距离真实数据 LSQ 0.60 个百分点;3 位时距离为 1.81 个百分点,相对 TexQ 提高 48.72 个百分点。这是生成、筛选与量化设计共同组成的方法结果,表格不能将全部差异单独归因于扩散模型或 u。
6.5 少量真实数据的价值
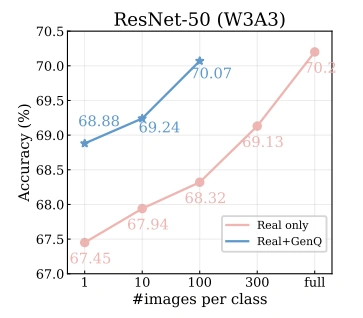
原文图 4,正文第 12 页。横轴为每类真实图片数量,红线只用真实数据,蓝线为加入 GenQ 的设置。
| 每类真实图片数 | 只用真实数据 | 加入 GenQ |
|---|---|---|
| 1 | 67.45% | 68.88% |
| 10 | 67.94% | 69.24% |
| 100 | 68.32% | 70.07% |
每类一张时提高 1.43 个百分点。作者将 68.88% 与每类 300 张真实图片的 69.13% 比较,称其接近需要 300 倍真实数据的效果。这是减少真实样本需求,不代表减少同等比例的总数据或算力,也不是完全等效。
正文的少数据实验先用约 1000 张真实图片执行 Genie-M 初始化,再比较不同真实数据量。因此,不能把方法段“PTQ / QAT 只用合成数据”的陈述直接套用于全部少数据实验流程。
6.6 跨模型复用
表 5 固定目标模型为 MobileNetV2、W2A4,GenQ 使用 MobileNetV2 来源数据时为 54.82%,改用 ViT-B 来源时为 54.24%,下降 0.58 个百分点。对照方法的对应结果从 51.47% 降到 17.96%。
这支持所测模型之间较稳定的数据迁移。GenQ 的生成不依赖目标分类模型,但筛选仍然依赖模型;复用实验检验的正是这种依赖是否造成明显性能损失,而不是证明任意模型都可无损共用数据。
7. 消融:数据数量与筛选强度
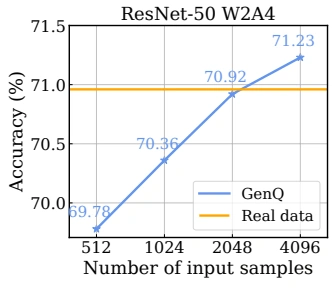
原文图 5,正文第 13 页。ResNet-50 W2A4,采用 Genie-M。橙线为约 1024 张真实图片的对照。
合成图片数量为 512、1024、2048、4096 时,准确率分别为 69.78%、70.36%、70.92%、71.23%。在这个范围内增加数据有效。4096 张合成数据超过固定真实数据对照,不是等量比较,也不能推出合成图片单张质量高于真实图片。
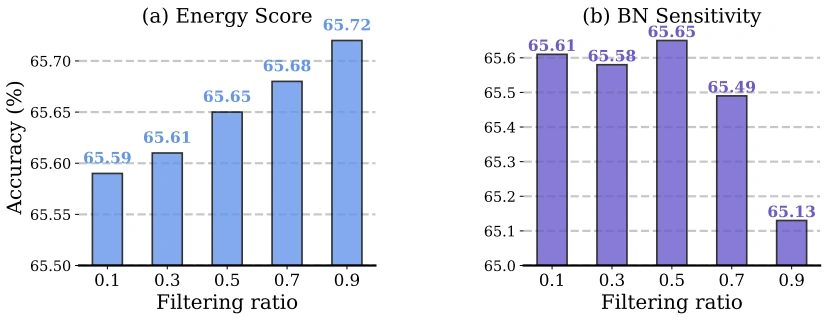
原文图 6,正文第 14 页。ResNet-18 W2A4,Genie-M。横轴为丢弃比例,最终使用的数据量固定。
能量筛选丢弃比例从 10% 增到 90% 时,准确率由 65.59% 到 65.72%,仅改善 0.13 个百分点。纵轴范围较窄,视觉高度差异不能当作大幅性能改善。为保留固定 N 张图片,丢弃比例为 rho 时需要生成 张候选图片,严格筛选会增加成本。
BN 敏感度筛选在丢弃 50% 时最好,为 65.65%;丢弃 90% 时降到 65.13%。作者推测过度筛选损害多样性,该解释没有被单独实验完全证实。现有消融主要检查数量与筛选比例,没有完整分离各模块的独立贡献。
8. 实验配置与硬件报告
| 阶段 | 可确认的设置 |
|---|---|
| 生成 | Stable Diffusion v1-5;guidance scale 3.5 |
| 提示词嵌入学习 | Adam;恒定学习率 0.0005;batch size 32;50,000 步;冻结其余扩散模型参数 |
| CNN PTQ | BRECQ / Genie-M;W4A4、W2A4;1024 张筛选后图片 |
| ViT PTQ | PTQ4ViT / RepQ-ViT;W4A4;32 张筛选后图片 |
| PTQ 候选生成 | 生成最终数量的 2 倍,筛除 50% |
| 无数据 QAT 数据 | 160 万候选图片,筛除 40 万,使用 120 万 |
| 无数据 QAT 优化 | SGD;初始学习率 0.001;余弦退火;50 epochs |
| 少数据 QAT | ResNet-50 W3A3;真实数据量为约 1k、10k、100k、300k、1.2M |
提示词训练 batch size 32 不能当作 QAT batch size。正文及官方补充材料未报告 GPU 型号、数量或显存,也未明确给出 CPU、内存、CUDA / PyTorch 版本、QAT batch size、momentum 和 weight decay。生成分辨率、推理采样步数、采样器及精度也无法从这些材料完整确认。
表 1 给出每 1000 张图片的耗时:Genie 152 分钟、TexQ 10 分钟、GenQ 24 分钟;图 1 则标注 GenQ 10 分钟。没有明确口径解释时,应保留两处报告的差异。表 1 支持 GenQ 比所测图像反演方法更快,但不能支持它比 GAN 对照更快。缺少硬件与批量配置,也不宜直接推算复现总时间。
9. 局限与结论边界
GenQ 的证据集中在 ImageNet 分类模型的低位量化,不能直接外推为医学影像、视频生成模型或语言模型上的收益。外部生成模型的预训练数据、目标类别知识以及数据集的视觉范围都会影响适用性。
生成质量展示、BN 统计与最终量化准确率是不同层次的证据。筛选指标是代理量,并不证明恢复了原始训练分布。QAT 结果还包含量化训练设计,当前消融不足以精确分配每个模块的贡献。
复现还需核对能量公式与实现约定、舍入函数、训练损失、硬件环境及完整超参数。作者仓库链接在 2026-10-12 核验时不可访问;本文的教学变量 r 和代码不能替代官方实现。
在论文报告的设置中,GenQ 表明预训练扩散模型可以提供有效的量化数据来源,模型相关筛选与少量真实数据引导可以提高实用性;其价值在于将生成先验转化为目标模型的校准和微调输入,而不是证明生成图片普遍优于真实图片。
参考来源
- Li et al. GenQ 正式论文,ECCV 2024。方法见 §3–4,实验见 §5。
- GenQ 官方补充材料:Appendix A 为提示词学习细节,Appendix B 为提示词模板。
- GenQ arXiv 页面。
- Ronneberger et al. U-Net,2015。
- Rombach et al. High-Resolution Image Synthesis with Latent Diffusion Models,CVPR 2022。
- Liu et al. Energy-based Out-of-distribution Detection,NeurIPS 2020。
原文图 1–6 的作者与来源为 GenQ 论文;图片仅用于对应方法和实验的解释。
See also
- PCFNet 论文解读:用频域特征与物理约束预测海表温度 2026-10-28
- AutoPrune 论文解读:让 LLM 设计视觉 Token 剪枝规则 2026-10-22
- OFA-MAS 论文精读:一个通用模型,怎样为不同任务选择智能体并生成协作图 2026-10-20
- M³Prune 论文精读:先组内讨论,再跨模态协作,怎样剪掉多余通信 2026-10-19
- RADAR 论文精读:扩散模型如何自动生成多智能体通信图 2026-10-19