SCGATN 论文解读:用 Chebyshev 图卷积与图注意力预测海表盐度
海表盐度(SSS)预测的难点不只是“时间上会变”,还在于“空间上谁影响谁”会随季节、径流和环流改变。Liu 等人提出的 SCGATN 把 SSS 场看成图上的时空序列:每个 25 km 网格点是节点,节点之间用距离阈值连边;在每个时空块里,先用 Chebyshev 图卷积提取局部空间结构,再用图注意力动态分配节点权重,最后再用一次 Chebyshev 图卷积把特征拉回局部。模型一次输出未来 12 天,而不是递归地一步一步预测。
本文按“动机—方法—实验—边界”展开。图片取自原论文(CC BY 4.0),图注标明来源;实验数字来自作者报告,未经独立复现。
论文信息与关键术语
| 项目 | 信息 |
|---|---|
| 论文题目 | A spatiotemporal chebyshev graph attention network model for sea surface salinity prediction |
| 作者 | Yingbing Liu、Cong Xiao、Guangwen Peng、Wenying Du、Dong Chen、Wang Chao、Changjiang Xiao |
| 发表信息 | Geo-spatial Information Science,2026 年 |
| 正式来源 | DOI:10.1080/10095020.2026.2694239 |
| 数据 | ESA CCI Sea Surface Salinity v03.21,日尺度,25 km |
| 研究区域 | 南海(SCS)与东海(ECS) |
| 任务 | 用 12 天历史 SSS,直接预测未来 12 天 |
| 对比模型 | LSTM、GCN、GAT、Mamba、SCGATN |
| 缩写 | 含义 | 在本文中的作用 |
|---|---|---|
| SSS | Sea Surface Salinity,海表盐度 | 输入和预测的变量 |
| SCS / ECS | South China Sea / East China Sea | 两个实验海区 |
| GNN | Graph Neural Network,图神经网络 | 把网格点当节点建模 |
| GCN | Graph Convolutional Network | 固定邻接矩阵的图卷积基线 |
| GAT | Graph Attention Network | 动态节点权重的图注意力基线 |
| ChebConv | Chebyshev Graph Convolution | 用 Chebyshev 多项式近似的谱图卷积 |
| STB | Spatiotemporal Block | 本文的基本块:ChebConv–GAT–ChebConv |
| RMSE / MAE / MAPE | 均方根误差 / 平均绝对误差 / 平均绝对百分比误差 | 预测误差指标 |
| R² | 决定系数 | 拟合优度指标 |
研究动机:空间关系没有被学对
SSS 是海洋环流、海气相互作用、季风气候、海洋生态和渔业的重要变量。它不是一个平滑的温度场:河口冲淡水、洋流和季风会让相邻网格的盐度差很大,而且“哪个节点更重要”会随季节和天气变化。
论文把现有方法分成几类:
- 统计/经验模型(EOF、线性回归):建模快,但依赖线性假设,难以刻画非线性海气耦合,长期预测误差会累积。
- 海洋数值模式:物理约束强,但需要高分辨率网格和复杂参数化,计算贵、对初值敏感,区域尺度难以高效预测。
- LSTM/ConvLSTM/CNN:时间建模强,但 CNN 的全局聚合会弱化节点间关系;LSTM 的递归多步会逐级放大误差。
- GCN:有显式空间图,但邻接矩阵通常是静态的,难以刻画随时间变化的动态关联。
- GAT:能动态分配节点权重,但对 SSS 的局部空间相关建模不够准,用于 SSS 时空预测的工作也很少。
最关键的缺口是:空间异质性、动态关联、局部节点关系三者没有被同时建模。作者的切入点来自交通预测:Chebyshev 多项式可以用较低复杂度近似图谱卷积,只聚合 K 阶局部邻域;再叠加 GAT 的动态注意力,就形成了 SCGATN 的基本思路。
需要先说明:ChebConv 和 GAT 都不是作者提出的。 ChebConv 来自 Defferrard 等人的 ChebNet(2016),GAT 来自 Veličković 等人(2018);论文自己也引用了 Defferrard 等人,并提到 Guo 等人(2019)已经把 attention 和 Chebyshev 多项式结合用于交通网络。这篇论文的贡献主要是“组合 + 应用”,不是新算子。
方法总览:图1的一条主链
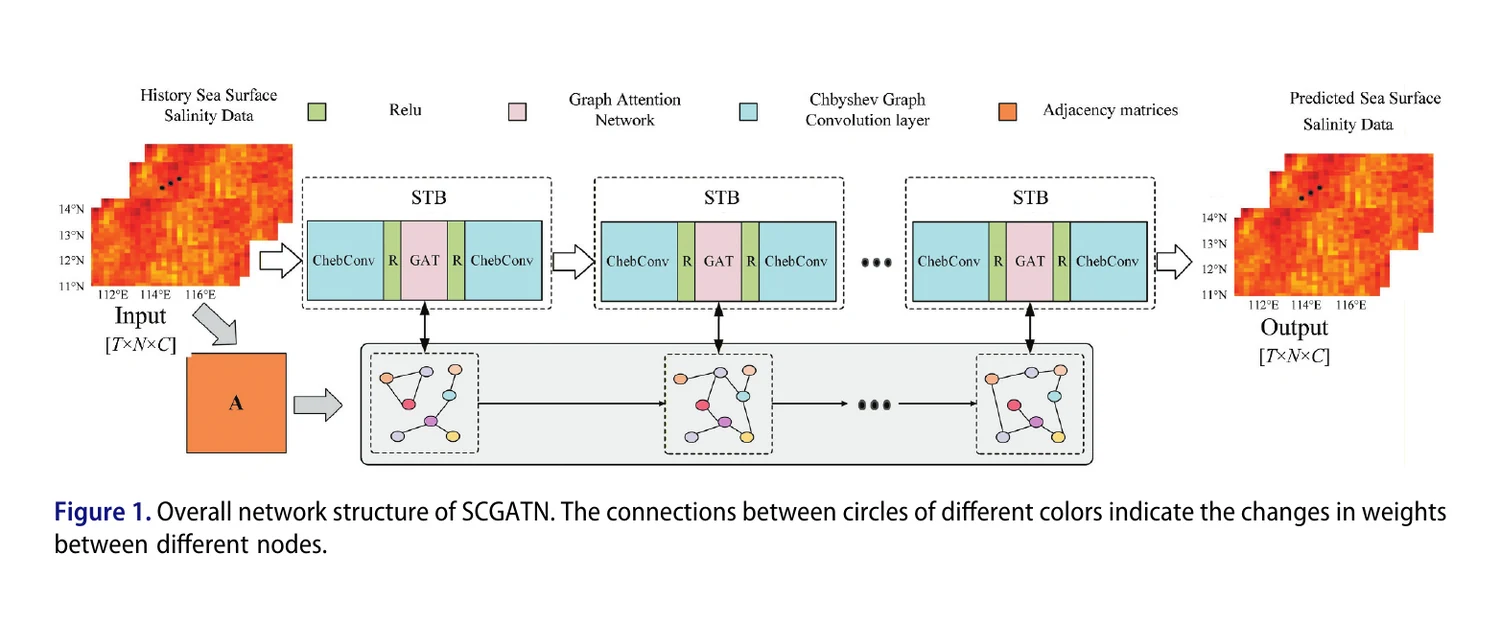
图1|SCGATN 总体结构。左侧是 12 天历史 SSS,橙色 A 是邻接矩阵,中间是多个 STB 堆叠,右侧是未来 12 天预测。图片取自原论文(CC BY 4.0)。
主链可以写成:
[T×N×C] → STB × L → [T×N×C]
- T = 12:输入 12 天历史,输出未来 12 天;
- N = 600:每个海区 600 个网格节点(20×30 网格);
- C = 1:单变量 SSS;
- A:600×600 的邻接矩阵;
- STB:每个块 = ChebConv → ReLU → GAT → ReLU → ChebConv;
- L:图中画了 3 个 STB,正文说 “multiple”,具体层数没有给。
图1下面那排“A → 节点图 → … → 节点图”不是另一个 STB,也不是独立的预测分支。它是“邻接矩阵 + 注意力权重”随 STB 变化的示意:A 是固定的底图,GAT 在每个 STB 内重新计算权重,节点颜色和连线变化表示权重变化。真正的计算模块是上面那排 STB。
图构建:固定距离图
每个网格点是一个节点。节点 i 和 j 的地理距离是:
邻接矩阵按距离阈值构造:
论文取 。距离越近,权重越大;超过阈值就断开。然后计算度矩阵 、拉普拉斯矩阵 ,并归一化得到 。
直觉上,这是一张局部、稀疏、对称的图:它把“海洋是空间连续场”这个先验注入模型,但不负责“动态”。动态由后面的 GAT 负责。
这里有几个论文没有写清的细节: 是按经纬度度数还是按网格索引;式 (5) 对 没有定义(),实现时要设 或加自环; 的具体归一化/缩放方式也没有写。复现时要先确认这些。
ChebConv:用多项式近似谱卷积
ChebConv 的目标是近似标准的谱图卷积:
其中 是拉普拉斯矩阵的特征向量矩阵, 是特征值矩阵。直接做特征分解很贵,而且 是稠密的。Chebyshev 的思路是不求 ,而是用多项式近似谱域滤波器:
利用 ,变回节点域:
其中 是第 k 阶的可学习通道变换,,。
Chebyshev 多项式用三项递推计算:
实现时不需要显式写出高阶矩阵,只需要:
- 先算 ;
- 再算 ;
- 之后每一步用 ;
- 把每个 过一个线性层 ,再求和。
为什么是局部的? 做一次邻居聚合,等价于 1-hop; 等价于 2-hop;K 阶多项式组合了 0 到 K−1 跳的邻居。所以 K 阶 Chebyshev = K-hop 局部感受野。K 越大,看得越远;论文没有给 K 的具体值。
为什么便宜? 不需要特征分解,只用稀疏矩阵乘法;参数量是 量级。
论文式 (6) 把 写在最左边,按矩阵维度应理解为 ,也就是“先图聚合,再做通道变换”。这是记号问题,不影响结构。Chebyshev 递推要求 的谱在 ;论文只说“归一化拉普拉斯”,没写具体缩放,复现时要确认。
GAT:这篇论文的 GAT 是 dense attention
标准 GAT 对节点 i 的做法是:
关键点是:只在邻居 上做 softmax,所以标准 GAT 是局部的;权重由特征决定,所以是动态的。
这篇论文的 GAT 公式是:
- :第一个 ChebConv 之后的节点特征,形状 ;
- :可学习的权重矩阵;
- :注意力分数矩阵;
- : 的注意力矩阵;
- :加权后的节点特征。
它的直观含义是:对每个节点 i,模型会学一行权重 ,然后把这 N 个节点的特征加权混合。权重由当前输入决定,所以不同时间、不同海况下,“哪些节点重要”会变。
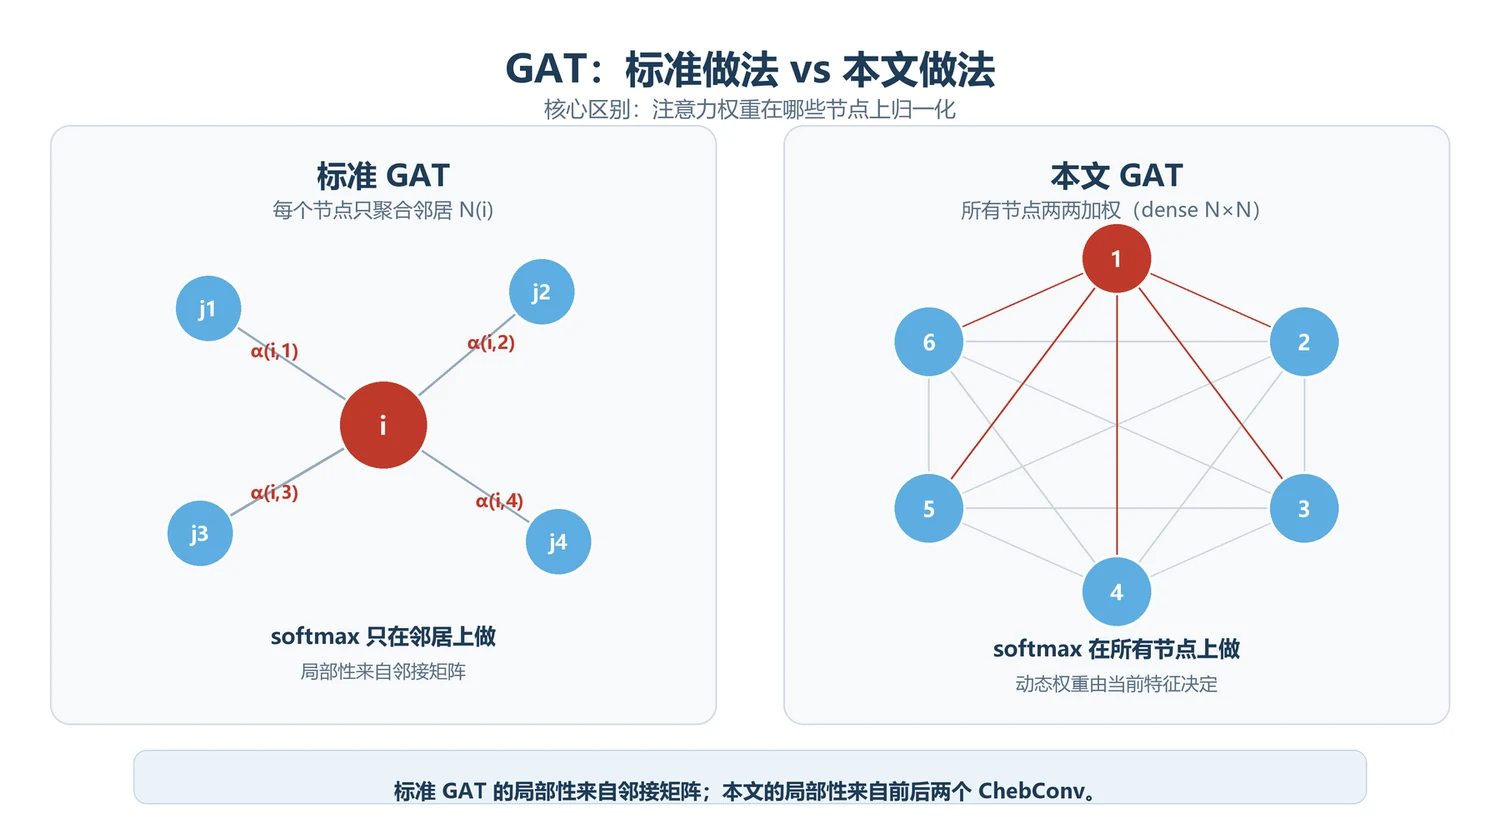
图2|标准 GAT 与本文 GAT 的区别。左:标准 GAT 只在邻居上做 softmax;右:本文 GAT 在所有节点上做 dense 注意力。此图为本站整理。
它和标准 GAT 的关键区别:
| 标准 GAT | 本文 GAT | |
|---|---|---|
| 注意力范围 | 只在邻居 上 | 所有节点(dense ) |
| 分数 | ||
| c-2.7,0,-7.17,-2.7,-13.5,-8c-5.8,-5.3,-9.5,-10,-9.5,-14 | ||
| c0,-2,0.3,-3.3,1,-4c1.3,-2.7,23.83,-20.7,67.5,-54 | ||
| c44.2,-33.3,65.8,-50.3,66.5,-51c1.3,-1.3,3,-2,5,-2c4.7,0,8.7,3.3,12,10 | ||
| s173,378,173,378c0.7,0,35.3,-71,104,-213c68.7,-142,137.5,-285,206.5,-429 | ||
| c69,-144,104.5,-217.7,106.5,-221 | ||
| l0 -0 | ||
| c5.3,-9.3,12,-14,20,-14 | ||
| H400000v40H845.2724 | ||
| s-225.272,467,-225.272,467s-235,486,-235,486c-2.7,4.7,-9,7,-19,7 | ||
| c-6,0,-10,-1,-12,-3s-194,-422,-194,-422s-65,47,-65,47z | ||
| M834 80h400000v40h-400000z"/> | ||
| softmax | 只在邻居上 | 在所有节点上 |
| 聚合 | ||
| 多头 | 通常有 | 论文没有提 |
| 局部性来自 | 邻接矩阵 | 前后的 ChebConv |
| 作用 | 邻居加权聚合 | 全局动态重加权 |
所以准确地说:它不是标准 GAT 的“邻居注意力”,而是稠密的、全局的节点混合层。 局部空间约束不是它提供的,而是它前后的两个 ChebConv 提供的。
论文里两个 也很容易混:式 (5) 的 是邻接矩阵,式 (8) 的 是注意力矩阵。上面把后者写成 ,就是为了区分。
这里还有几个未写清的点: 的维度、softmax 的方向、是否多头。如果 是 ,单层就是 万参数,和论文总参数 1.02M 的量级是吻合的;但这只是推测,不是论文明确说的。dense 注意力的复杂度是 ,对 600 个节点还可以,但对更大规模的图要谨慎。
一个 STB 的完整过程
一个 STB 的流程是:
H^(l-1)  [N × C_(l-1)]
   ↓ ChebConv1
Z1       [N × d]
   ↓ ReLU
Z1_tilde [N × d]
   ↓ GAT
Z1'      [N × d]
   ↓ ReLU
Z1_tilde'[N × d]
   ↓ ChebConv2
H^(l)    [N × C_l]
可以理解成三步:
- 先局部看细节:第一个 ChebConv 提取 K-hop 邻域特征;
- 再全局决定谁重要:GAT 按当前输入给节点重新加权;
- 最后回到局部整合:第二个 ChebConv 把动态权重下的特征重新放回图结构,并映射到输出。
如果只有 ChebConv,空间关系是固定的,难以适应随时间变化的关联;如果只有 GAT,注意力是全局稠密的,缺少局部空间约束。两个 ChebConv 夹一个 GAT,正好把“局部结构”和“动态重要性”结合起来。
多个 STB 堆叠,就是在重复这个过程;单个 ChebConv 只看 K-hop,堆叠后等效感受野变大。图1画了 3 个 STB,正文说 “multiple”,具体层数没有给。
实验设置:南海与东海
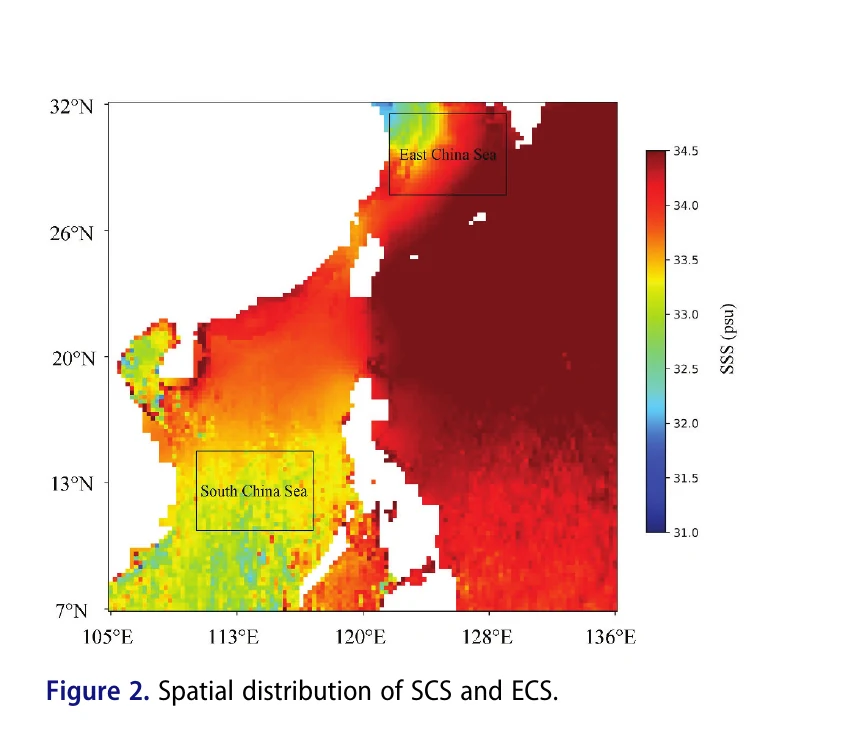
图3|SCS 与 ECS 的 SSS 空间分布。南海是低纬开阔海区,SSS 相对均匀;东海靠近长江口,西部有明显的低盐羽流。图片取自原论文(CC BY 4.0)。
实验数据是 ESA CCI SSS v03.21,日尺度,25 km,时间范围 2010-01-10 到 2020-09-29。每个海区 600 个节点,3916 个样本;按时间 70%/10%/20% 划分训练、验证、测试。
| 项目 | 设置 |
|---|---|
| 区域 | 南海:110.4–117.6°E,10.4–14.2°N;东海:122.6–130.1°E,27.0–31.2°N |
| 节点 | 每区 600 个(20×30 网格) |
| 输入/输出 | 12 天历史 → 未来 12 天 |
| 训练 | 归一化 [0,1],Adam,lr=0.001,batch=64,200 epochs |
| 模型规模 | 1.02M 参数;SCS 单 epoch 约 52 s;总训练/测试约 2.9 h |
| 指标 | RMSE、MAE、R²、MAPE |
选这两个海区的目的很明确:南海相对均匀,东海有强梯度和低盐羽流。如果模型只在南海好,可能只是学到了“平滑”;只有在东海也能压准,才能说明它真的学到了局部空间结构。
定量结果:1 步看 LSTM,12 步看 SCGATN
先看关键数字(RMSE,psu):
| 区域 | 步长 | LSTM | GCN | GAT | Mamba | SCGATN |
|---|---|---|---|---|---|---|
| 南海 | 1-step | 0.0469 | 0.0735 | 0.0830 | 0.0498 | 0.0490 |
| 南海 | 12-step | 0.2823 | 0.2447 | 0.2047 | 0.2175 | 0.1917 |
| 东海 | 1-step | 0.0267 | 0.3077 | 0.0755 | 0.0611 | 0.0393 |
| 东海 | 12-step | 0.8670 | 0.3176 | 0.3147 | 0.3175 | 0.3107 |
最重要的信息不是“SCGATN 全赢了”,而是:
- 1 步预测,LSTM 仍然最好(南海 0.0469 vs 0.0490;东海 0.0267 vs 0.0393);
- 从 2 步开始,SCGATN 逐渐反超;
- 到 12 步,SCGATN 在两个海区都是 RMSE 最低。
原因在于多步策略:LSTM 用递归多步,先预测 1 步,再把预测值喂回去预测下一步,误差会逐步累积;SCGATN 用直接多步,一次输出 12 天,用整个序列的误差做一次反向传播。所以它牺牲一点 1 步精度,换 12 步的稳定性。
论文里的典型例子:
- 东海 2 步:SCGATN 0.0310,LSTM 0.0549,GAT 0.0701,Mamba 0.1070,GCN 0.3006;
- 东海 4 步:SCGATN 0.0611,LSTM 0.1339,Mamba 0.1621,GAT 0.1768,GCN 0.2902;
- 南海 6 步:SCGATN 0.0692,GAT 0.0777,Mamba 0.1025,LSTM 0.1927,GCN 0.2139。
所以在 2–6 步,SCGATN 的优势最明显;到 12 步,东海对 GCN/GAT 的优势其实已经很小了。
摘要里的降幅范围要这样读:
- 21.66%–83.16%(vs GCN)和 6.35%–56.69%(vs GAT)是跨 1–12 步的范围,不是 12 步单点;
- 到 12 步,东海相对 GCN/GAT 只有 2.17% / 1.27% 的提升;
- 12 步的真正优势是相对 LSTM:东海 0.3107 vs 0.8670,约低 64%。
另外,原论文 Table 2 里南海 12 步 Mamba 的 R² 是 0.7250,高于 SCGATN 的 0.6878,而正文说 SCGATN 的 R² 高于 Mamba。按 RMSE/MAE 看 SCGATN 仍更好,但 R² 这句话要小心。
空间结果:误差在哪里
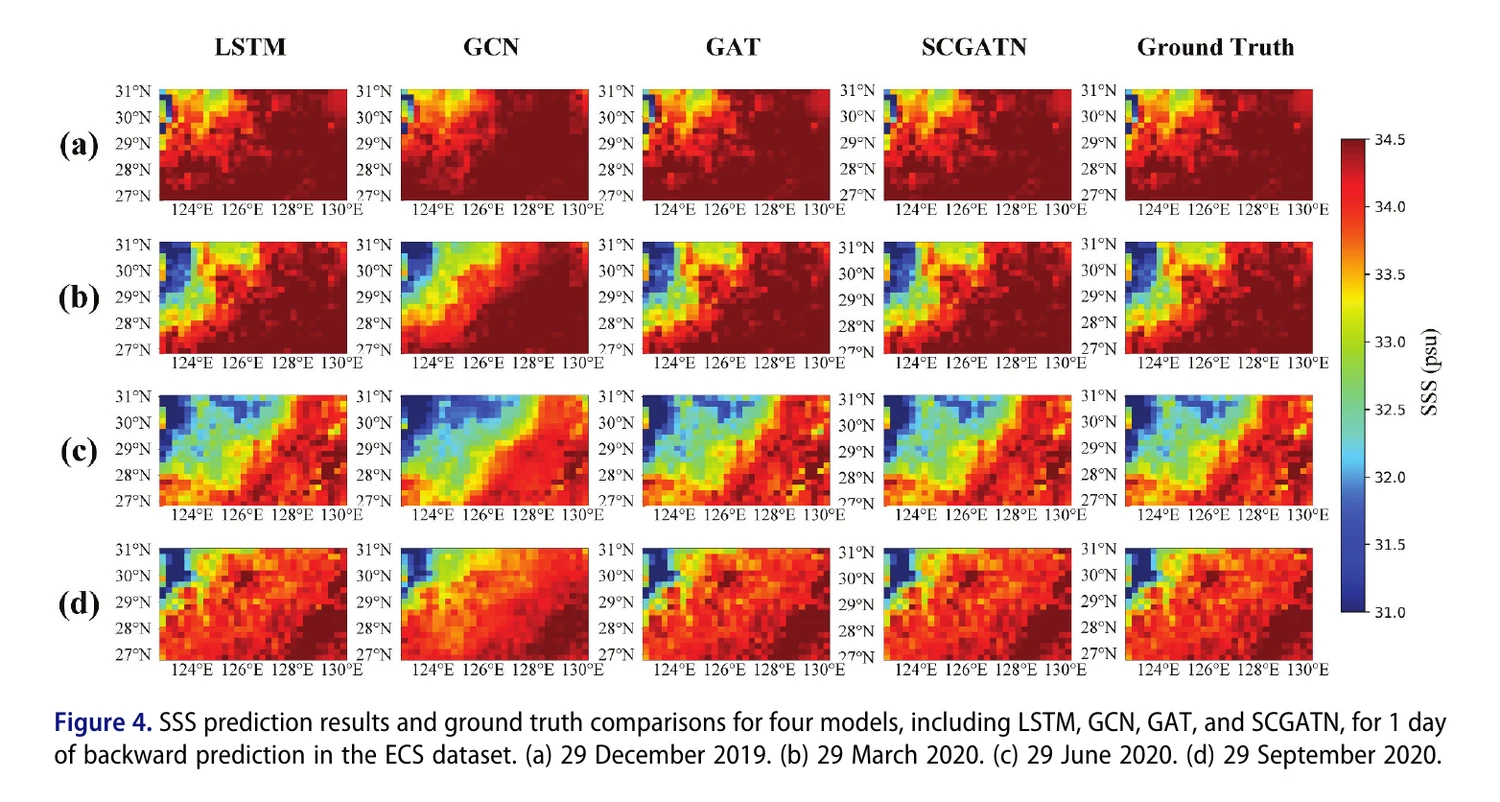
图4|东海 1 天预测对比:四行是四季,五列是 LSTM、GCN、GAT、SCGATN、真值。图片取自原论文(CC BY 4.0)。
看东海西侧的低盐羽流:
- LSTM 整体偏平滑,梯度被抹开;
- GCN 块状感明显,近岸低盐区偏差大;
- GAT 比 GCN 好,但梯度位置和强度仍有偏移;
- SCGATN 的低盐舌位置、色带宽度和最陡梯度最接近 Ground Truth。
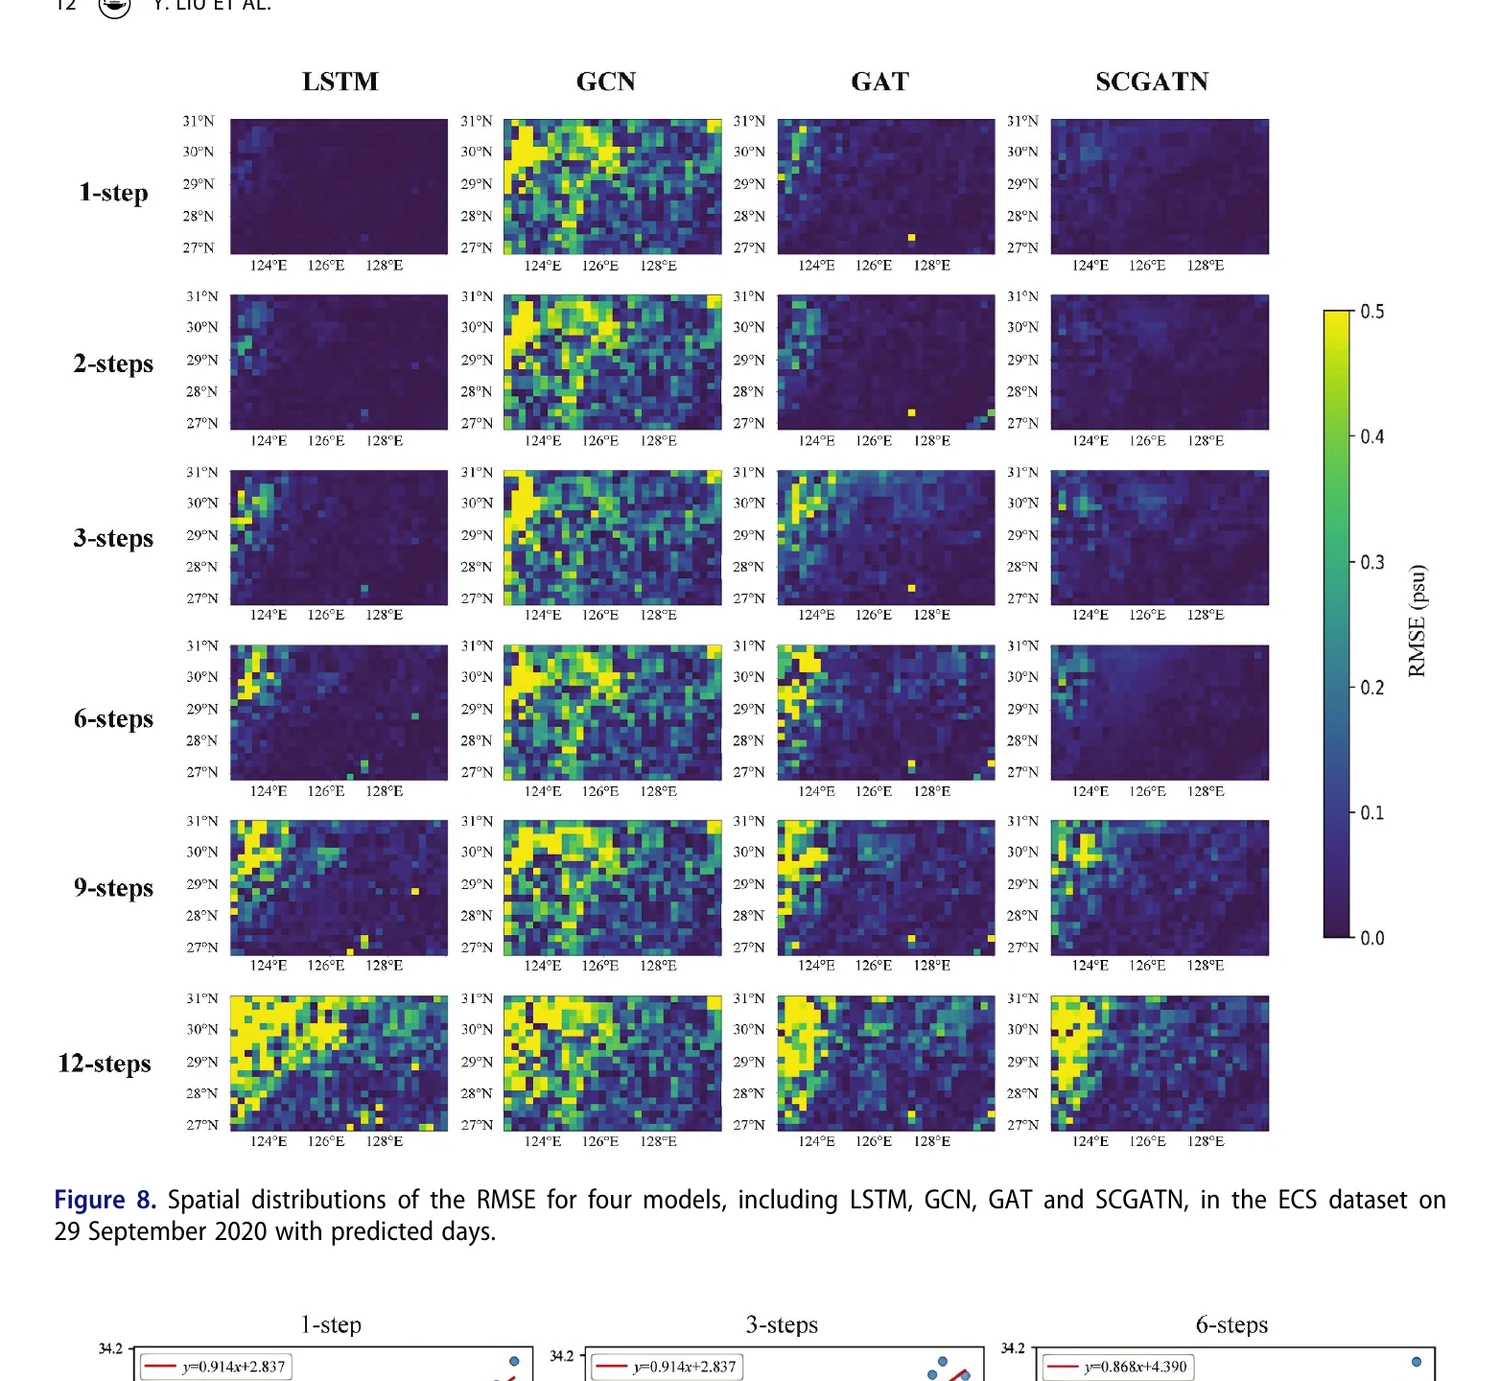
图5|东海 RMSE 空间分布:行是 1/2/3/6/9/12 步,列是四个模型;颜色越亮误差越大。图片取自原论文(CC BY 4.0)。
看 12 步那一行:
- GCN 几乎整片亮,说明它在这一天的强梯度海区误差很大;
- LSTM / GAT 的误差沿西侧边界和强梯度带聚集;
- SCGATN 整体最暗,残余亮点仍集中在强梯度/边界附近,但没有扩散到全图。
但这里有一个很重要的读图提醒:图5(原论文 Fig. 8)是 2020-09-29 这一天的单日样本,不是测试集平均。原论文 Table 3 的测试集平均里,东海 12 步 GCN 是 0.3176、GAT 是 0.3147、SCGATN 是 0.3107,差距只有 2.17%/1.27%。所以图5 的视觉差距不能直接当成总体差距;它说明的是“在强梯度节点上,SCGATN 更稳”,而不是“平均下来碾压 GCN/GAT”。
南海的对应图是原论文 Fig. 3(1 天预测)和 Fig. 7(RMSE 分布),趋势类似,但南海的空间异质性弱一些。
消融实验:两个模块都不是摆设
原论文 Table 4 的设计是:
- Experiment 1:只有 GNN,无 attention、无 Chebyshev;
- Experiment 2:GNN + attention,但去掉 Chebyshev;
- SCGATN:GNN + attention + Chebyshev。
结果(RMSE):
| 区域 | GNN only | + attention(无 Cheb) | 完整 SCGATN |
|---|---|---|---|
| 南海 | 0.1009 | 0.0737 | 0.0490 |
| 东海 | 0.2982 | 0.0611 | 0.0393 |
可以读出两件事:
- attention 的贡献很大,尤其东海:0.2982 → 0.0611,降了约 80%;
- Chebyshev 也不是可有可无:在 attention 基础上再加 Cheb,南海 0.0737 → 0.0490,东海 0.0611 → 0.0393,都还有约 34%–36% 的下降。
所以两个模块是互补的:attention 负责“动态选节点”,Chebyshev 负责“局部空间结构”。
极端天气与效率
论文还检查了 2018-09-14 台风 Mangkhut 期间的表现:
- 1 步:RMSE 0.0496,R² 0.9199;
- 3 步:RMSE 0.0479,R² 0.9362;
- 6 步:RMSE 0.0717,R² 0.8334。
在极端天气下,SCGATN 的误差没有爆炸,6 步仍能保持可用精度。这个实验主要是为了说明“不是只在平均海况下好看”。
效率方面:1.02M 参数,SCS 600 节点单 epoch 约 52 s,总训练/测试约 2.9 h(RTX 4090)。论文没有报告推理时延,也没有做大图的可扩展性实验。
创新与边界:哪些是新的,哪些不是
这部分很重要,因为论文的标题和摘要容易让人以为 ChebConv 或 GAT 是作者提出的。实际上:
| 组件 | 来源 | 本文是否新提出 |
|---|---|---|
| ChebConv / Chebyshev 图卷积 | Defferrard et al. 2016(ChebNet) | 否 |
| Chebyshev 多项式 | 经典数值分析 | 否 |
| GAT / 图注意力 | Veličković et al. 2018 | 否 |
| Cheb + attention 的组合 | Guo et al. 2019 等,已用于交通预测 | 否,已有 |
| 距离阈值图 | 常见图构建方式 | 否 |
| 直接多步输出 | 常见多步预测策略 | 否 |
| STB 的具体排列 | 本文的 ChebConv–GAT–ChebConv | 部分是,属于工程组合 |
| SSS 应用 + 双海区验证 | 本文 | 是,应用层贡献 |
本文真正的贡献,主要是:
- STB 的具体排列:把 ChebConv、ReLU、GAT、ReLU、ChebConv 串成一个块,用于 SSS 预测。
- SSS 专用的图构建:600 个网格节点、距离阈值 、反距离权重。
- 直接 12 步输出:12 天输入,一次输出未来 12 天。
- 双海区、多步、消融、台风验证:南海/东海、四季、1–12 步、极端天气。
- 实证结论:中期稳定性更好,误差在强梯度区的空间分布更合理。
这些主要是应用层和工程层的贡献,不是方法学上的新算子。
论文有几处措辞需要打折看:
- “adaptive spatial correlation matrix” 有点过。摘要说 GNN 构造自适应空间相关矩阵,但式 (5) 的 A 是距离阈值固定的,不是端到端学习的;真正随输入变的是 GAT 的注意力权重。准确说法是:固定距离图 + 动态注意力。
- “spatiotemporal” 也比较宽。网络里没有显式的 RNN/TCN 或时间卷积;时间维是靠 12 天序列输入、12 天序列输出和线性层混合来处理的。它更像一个“图上的直接多步回归器”,而不是一个新的时空算子。
- “显著优于”要按步长看。1 步 LSTM 仍更好;12 步东海相对 GCN/GAT 只有 2.17%/1.27% 的提升。摘要里的 89.69%/65.44% 是跨步长的最好情况,不是 12 步。
如果按方法论文的标准,审稿人可能会问:
- 为什么没有纯 ChebNet baseline?你用 ChebConv,但对比模型是 GCN,不是纯 ChebNet;Chebyshev 的增益没有被单独隔离。
- 为什么没有 Cheb + attention 的 baseline?Guo et al. (2019) 已经做过类似组合,应该直接对比,才能说明 STB 的排列本身有价值。
- STB 的排列有没有消融?比如 ChebConv-only、GAT-only、先 GAT 后 Cheb、单 ChebConv 等;现在的消融只去了 Chebyshev 或 attention,没有拆 STB 的顺序。
- A 到底是固定的还是可学习的?如果是固定的,就不应该叫 adaptive graph;如果是可学习的,要把学习机制写清楚。
- 时间维到底怎么混合?12 天输入怎么影响 12 天输出?建议加“打乱时间顺序”或“只用单帧”的对照。
- 注意力能不能扩展?现在 N=600,dense 还可以;论文提到“large-scale SSS”,但没有做大图的 scalability 实验。
- 损失函数、K、隐层维度、STB 数量、 形状都没给清楚,复现困难。
结论
SCGATN 不是一个新的图卷积或注意力算子,而是把已有的 ChebConv、GAT 和距离图组合成一个面向 SSS 的 STB,并用双海区、多步、消融和台风实验证明这个组合在中期预测上有优势。
如果把它当应用/系统论文看,它是有价值的:SSS 专用的图构建、12→12 的直接多步、两个异质海区的验证、比较完整的实验矩阵。
如果把它当方法论文看,它的新意有限:组件都是现成的,组合在交通预测里也有先例;论文对“自适应图”和“时空”的表述偏宽,且缺少同架构的 ChebNet / Cheb+attention baseline。
最值得记住的实验结论是:SCGATN 不是 1 步最强,而是 2–12 步更稳、在东海强梯度区的误差分布更合理;消融说明 Chebyshev 和 attention 都必要。 引用时建议按步长和区域具体看,不要只用摘要里的最大降幅。
参考来源
- Liu, Y., Xiao, C., Peng, G., Du, W., Chen, D., Chao, W., & Xiao, C. (2026). A spatiotemporal chebyshev graph attention network model for sea surface salinity prediction. Geo-spatial Information Science. DOI: 10.1080/10095020.2026.2694239
- Defferrard, M., Bresson, X., & Vandergheynst, P. (2016). Convolutional neural networks on graphs with fast localized spectral filtering. NeurIPS 2016.
- Veličković, P., Cucurull, G., Casanova, A., Romero, A., Liò, P., & Bengio, Y. (2018). Graph attention networks. ICLR 2018.
- Guo, S., Lin, Y., Feng, N., Song, C., & Wan, H. (2019). Attention based spatial-temporal graph convolutional networks for traffic flow forecasting. AAAI 2019.
- ESA Climate Change Initiative. Sea Surface Salinity dataset, v03.21. https://climate.esa.int/en/projects/sea-surface-salinity
图片说明:图1(原论文 Fig. 1)、图3(原论文 Fig. 2)、图4(原论文 Fig. 4)、图5(原论文 Fig. 8)取自原论文,按 CC BY 4.0 使用;图2(GAT 对比)为本站整理。
See also
- 双路径循环框架论文解读:用光流引导预测海表温度 2026-11-01
- PCFNet 论文解读:用频域特征与物理约束预测海表温度 2026-10-28
- AutoPrune 论文解读:让 LLM 设计视觉 Token 剪枝规则 2026-10-22
- OFA-MAS 论文精读:一个通用模型,怎样为不同任务选择智能体并生成协作图 2026-10-20
- M³Prune 论文精读:先组内讨论,再跨模态协作,怎样剪掉多余通信 2026-10-19