RegCache 精读:视觉编码器激活量化,为什么要预置 Register
CLIP、DINOv2 这类大规模视觉编码器是多模态系统的视觉底座,但它们的激活量化比语言模型更棘手:异常值往往在中间层才慢慢长出来,而且不像语言模型那样集中在 ⟨BOS⟩、⟨SEP⟩ 这种固定 token 上。结果是 8-bit 尚可,4-bit 往往直接崩掉。
RegCache 的思路是:与其事后给异常值做特殊量化器,不如先把「愿意吸异常」的 register token 预置进模型。它从参考图里策展出高范数 token,缓存它们的 KV 并在中间层前缀插入,再在推理时删掉模型内部刚冒头的 sink token。本文沿图 1 的动机、图 2 的对比、三个观察、图 5 的三步流程和实验表展开。文中的教学算例用于解释机制,实验数字均来自原论文报告,未经独立复现。
论文信息与关键术语
| 项目 | 信息 |
|---|---|
| 题目 | Activation Quantization of Vision Encoders Needs Prefixing Registers |
| 作者 | Seunghyeon Kim、Taesun Yeom、Jinho Kim、Wonpyo Park、Kyuyeun Kim、Jaeho Lee |
| 单位 | POSTECH、NYU Langone Health、Google |
| 本文依据 | 本地 PDF 共 19 页,Springer LNCS 风格排版;代码见 RegCache |
| 主要实验模型 | CLIP-B/16、OpenCLIP-B/16、SigLIP-B/16、SigLIP2-B/16、DINOv2-B/14;VLM 为 Qwen3-VL-2B/8B |
| 任务 | ImageNet-1k 零样本分类、MS-COCO 图文检索、GQA/VQAv2、Video-MME/MLVU |
| 原文 | GitHub |
| 术语 | 含义 |
|---|---|
| PTQ | Post-Training Quantization,训练后量化,不重新训练原模型 |
| W8A8 / W4A4 | 权重与激活分别用 8 或 4 bit 表示 |
| Activation outlier | 少数通道或 token 上极大的激活值,会撑大量化动态范围 |
| Attention sink | 语义很弱、却吸引大量注意力的 token,语言模型里常见于特殊符号 |
| Register | 额外的、语义中立的 token;可吸收 attention sink |
| FC2 | MLP 第二个全连接层,论文把它的输入当作观测异常值的主要位置 |
| ℓ∞-norm | 每个 token 上绝对值最大的那个分量 |
1. 目标与动机:视觉编码器量化为何更难
视觉编码器常被单独部署到端侧,也可能作为 VLM 的视觉塔。在视频管线里,视觉编码器甚至能占到约 45% 的端到端延迟。PTQ 可以不训练就降低存储与算力,但 ViT 低比特激活量化仍频繁掉点。
根因是 outlier:少数通道的激活远大于其他值。量化要把连续数值映射到有限档位;若动态范围被几个极大值撑开,多数正常 token 的分辨率会被压扁。
| 场景 | 最大绝对值 | 对称 8-bit 量化步长 | 正常激活约为 1 时的相对误差 |
|---|---|---|---|
| 无异常值,范围约 ±2 | 2 | ≈ 0.0157 | 约 1.6% |
| 出现一个 50 的异常值 | 50 | ≈ 0.392 | 约 39% |
上表是教学算例,用来说明范围被撑开后的代价:异常值本身可能只占极少 token,却让整层激活一起变粗糙。若给不同 token 或通道单独设定精度/范围,又会引入不小的运行时开销,难以落到静态激活量化上。
语言模型里有一条「前缀 sink」的路:把 ⟨BOS⟩ 之类 token 的 KV 缓存起来,前缀插进注意力层,让它们吸收异常。问题在于:视觉编码器里谁来当 sink token?
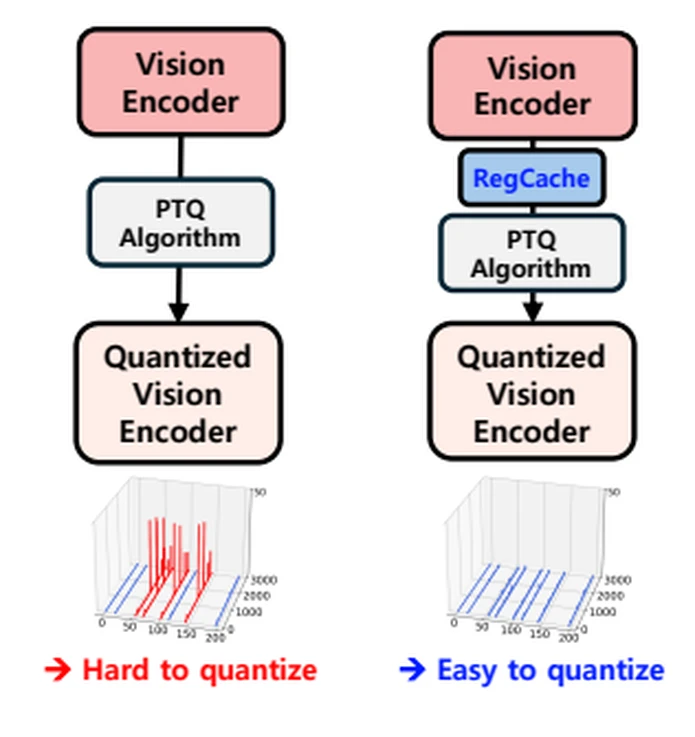
原论文图 1,PDF 第 2 页。左侧直接对视觉编码器做 PTQ 偏难;右侧先用 RegCache 预处理,再交给 PTQ,量化更易。
图 1 把 RegCache 定位成 on-top 插件:它不替换 PTQ 算法,而是先把模型改造成「好量化」的形态。这和后续实验里「多种 PTQ 底座都能叠加」的设定一致。
2. 图 2:LLM 有现成 sink token,视觉没有
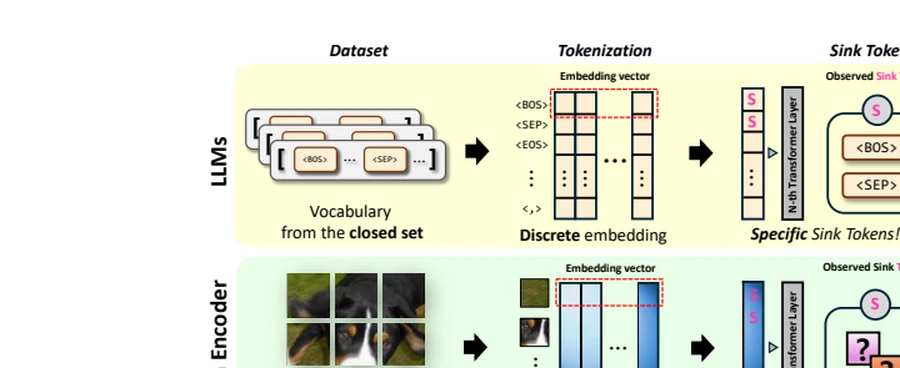
原论文图 2,PDF 第 3 页。上半:LLM 词表封闭,⟨BOS⟩、⟨SEP⟩ 从输入起就是语义中立 sink。下半:视觉编码器吃的是连续 patch 嵌入,sink 是谁并不显式。
两边的差别可以拆成三层:
- 词表是否封闭。 LLM 词表固定,特殊 token 从第 0 步就存在。视觉编码器的 token 是图像 patch 连续映射出来的嵌入。
- 异常出现位置。 LLM 的大规模激活常在早期层、固定位置/类型上出现;视觉编码器的异常 token 更像随机背景 patch。
- 能否复用。 前缀缓存要求这些 token 在任意测试输入上都稳定诱导异常。视觉 patch 换一张图就换一组,直接抄 LLM 的做法并不成立。
Darcet 等人提出训练时加入 register 来吸收 attention sink,但预训练视觉编码器通常没有这些 token。论文的经验观察是:
Sink tokens emerge gradually from the middle layers of vision encoders… These tokens are highly similar across images, enabling their use as reusable registers.
也就是说:视觉编码器会在中间层「自己长出」sink,而且这些 sink 跨图很像——于是可以把它们事先缓存下来,当作外部 register。
3. 三个观察:中间层、无意义 token、可复用
3.1 敏感层在中间,和异常值同时出现
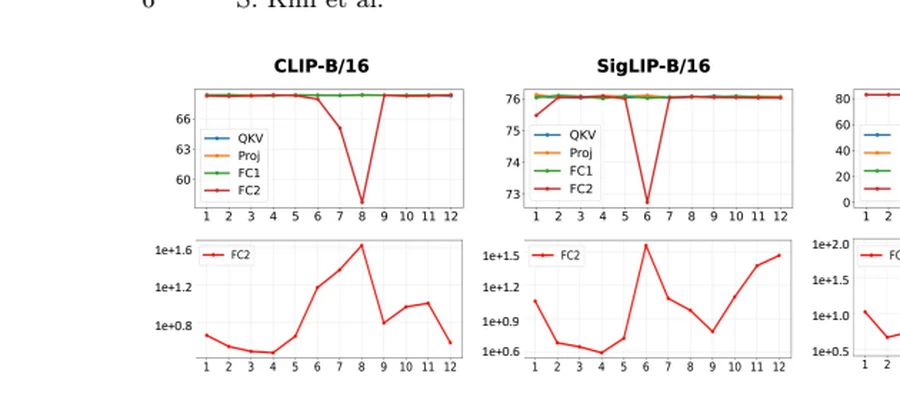
原论文图 3,PDF 第 6 页。上排:单独把某层量化到 W8A8 时的 ImageNet 零样本精度;下排:各层 FC2 输入 token 的最大 ℓ∞ 范数(对数刻度)。
作者逐层做 W8A8 单层量化,用精度跌幅定位 quantization-sensitive layer。敏感层主要落在一两个中间块的 MLP 投影上;DINOv2 的掉点更广。下排曲线显示,这些位置恰好是 FC2 输入范数开始抬升的区域。结论有两层:
- 异常值是视觉编码器低比特掉点的主因。
- 前缀不必覆盖整网络,早期层可以不动,只需处理中间到后段。
3.2 为什么是中间层?语义「无意义」需要先被识别
LLM 的 ⟨BOS⟩ 从输入起就无意义;图像 patch 要先经过若干层,模型才能分出「没信息的背景块」。作者用 ImageNet-9 做对照:
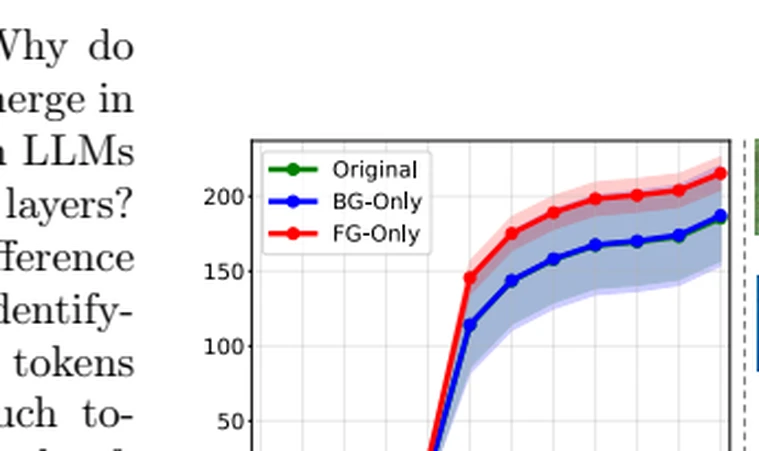
原论文图 4,PDF 第 7 页,SigLIP-B/16。Original 与 BG-Only 曲线几乎重合;FG-Only 更早、更大。
前景-only 图把背景像素置零,「无意义 patch」更易识别。结果异常更早、更强;只留背景则与原图几乎重合。这支持一个假设:视觉编码器的 sink 出现得晚,是因为「谁是垃圾 token」本身需要中间层计算。 附录还提到,带 register 训练的模型更像 LLM,异常会在早期层出现。
3.3 中间层 sink 跨图高度相似
| Token 类型 | 平均余弦相似度(64 张 ImageNet 验证图两两比较) |
|---|---|
| 正常 token | 0.26(±0.10) |
| 异常 token | 0.89(±0.07) |
数据来自原论文表 1,PDF 第 7 页,SigLIP-B/16。
异常 token 跨图几乎长成同一套特征,正常 token 则差得多。这正是「可复用 register」的证据:从一张参考图搜到的高范数 token,可以拿去服务另一张测试图。
4. 图 5:Curating、Caching、Deleting
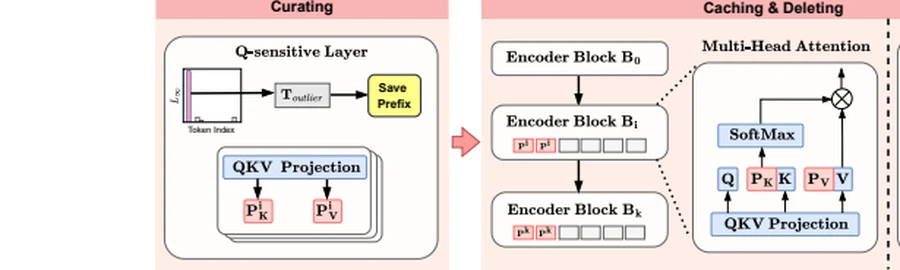
原论文图 5,PDF 第 8 页。左:从参考池策展 register;中右:在中间层插入缓存 KV,并在敏感层删除 top-k 异常 token。
结合上面的观察,方法可以写成一句话:
用参考图中间层的 sink token 当外部 register,替掉测试时模型内部自己长出的 sink,并删掉还没吸收干净的异常 token。
4.1 Curating:锁定敏感层,收集高范数 token
- 找敏感层
l_q。 逐层量化(默认 round-to-nearest;若已定 PTQ 底座则用该底座),看 ImageNet-1k 训练集上哪层掉点最多。附录还给了无标签的重建误差版。 - 取 top-k。 在
l_q输入处,按 ℓ∞ 范数取最大的 k 个 token:
实验设置:从 ImageNet-1k 训练集采 50,000 张参考图,k = 100。因为 sink 往往在敏感层前几个块就出现,作者对最多 3 个前置块 同样搜一遍,为每层单独建候选集。
4.2 Caching:平均 KV,搜索插入份数 τ
对候选 token 在未量化编码器上算 KV,再平均成一份 register,插入量化后的模型。插入份数
在参考任务(仍是 ImageNet-1k 训练集分类)上挑精度最高的 τ*。CLIP/SigLIP 从搜到的层一直插到最后一层;DINOv2 只插在搜到的那一层效果更好。
注意:这里的 cache 是 离线算好的 KV 前缀,推理时不做逐图 token 检索。搜索总开销在 RTX 4090 上用朴素 RTN 伪量化约 1 小时。
4.3 Deleting:测试时删掉残余 sink
前缀插好后,模型内部仍可能冒出异常 token。推理时在敏感层输入上再删 top-k̃ 个 ℓ∞ 最大 token:
k̃ 同样用参考任务调。删的是 当前测试图自己的 异常 patch;insert 的是 跨图共享的 register。两者互补。
4.4 一个更直观的分工
| 步骤 | 作用对象 | 发生时间 | 解决的问题 |
|---|---|---|---|
| Curating | 参考池里的高范数 token | 准备阶段 | 视觉没有现成 sink 词表 |
| Caching | 这些 token 的平均 KV | 准备阶段 + 推理插入 | 用外部 register 吸走注意力异常 |
| Deleting | 当前测试图的 top-k̃ token | 推理阶段 | 清掉仍未被吸收的 outlier |
把激活想成一张表:行是 patch token,列是通道。一个 50 的尖峰会把整列量化步长拉粗;前缀让尖峰集中到 register 上,删除再把剩下的尖峰行拿掉,剩下的表就好量化了。
5. 主实验:分类、检索、VLM
5.1 ImageNet-1k 零样本分类
底座覆盖缩放因子优化(PTQ4ViT、RepQ-ViT、FIMA-Q)、取整函数优化(ERQ、FIMA-Q)、权重修正(ERQ)、激活分布整形(NoisyQuant),以及朴素 RTN。
| 模型 | 位宽 | BestΔ | AverageΔ | FP32 参考 |
|---|---|---|---|---|
| CLIP-B/16 | W4A4 | +44.51 | +15.67 | 68.32 |
| CLIP-B/16 | W6A6 | +27.15 | +11.19 | 68.32 |
| CLIP-B/16 | W8A8 | +2.62 | +0.77 | 68.32 |
| OpenCLIP-B/16 | W4A4 | +11.61 | +6.90 | 70.22 |
| SigLIP-B/16 | W4A4 | +12.40 | +4.70 | 76.05 |
| SigLIP2-B/16 | W4A4 | +18.42 | +6.11 | 78.47 |
| DINOv2-B/14 | W4A4 | +2.62 | +1.11 | 83.26 |
| DINOv2-B/14 | W8A8 | −0.05 | −0.47 | 83.26 |
数据摘自原论文表 2,PDF 第 11 页。BestΔ / AverageΔ 为「各 PTQ 底座 + RegCache」相对该底座的最大/平均提升。
读数要点:
- 比特越低,收益越大。 W4A4 / W6A6 上 CLIP 的 BestΔ 达到 +44.51 / +27.15;W8A8 时头寸变小。
- softmax 基模型收益更明显(CLIP 系大于 SigLIP 系),与「softmax 是 outlier 重要来源」的共识一致。
- DINOv2 是例外。 自监督模型行为不同,W8A8 上甚至有 −0.05 的 BestΔ;作者也改成只在搜到的层插前缀。
以 CLIP-B/16 + ERQ 为例:W4A4 从 1.56 提到 46.07;W8A8 从 67.99 提到 68.09。再看 FIMA-Q 这类已经很强的底座,W8A8 上增益几乎消失——RegCache 是补异常值短板,不是无条件刷分。
5.2 图文检索(MS-COCO R@1)
| 设置 | 位宽 | BestΔ(图→文) | BestΔ(文→图) |
|---|---|---|---|
| CLIP-B/16 | W4A4 | +13.46 | +5.72 |
| CLIP-B/16 | W6A6 | +17.26 | +4.26 |
| CLIP-B/16 | W8A8 | +1.06 | +0.67 |
| SigLIP-B/16 | W4A4 | +9.78 | +5.41 |
| SigLIP-B/16 | W6A6 | +23.56 | +17.22 |
| SigLIP-B/16 | W8A8 | +0.86 | +0.88 |
数据摘自原论文表 3,PDF 第 11 页。
检索任务上所有设定均获益,方向与分类一致:低比特更需要压 outlier。
5.3 VLM:图像与视频
在 Qwen3-VL 上把视觉塔压到 4-bit,叠在 RepQ-ViT 上:
| 模型 | 任务 | 底座 RepQ-ViT | + RegCache | Δ |
|---|---|---|---|---|
| 2B | GQA | 38.77 | 42.11 | +3.34 |
| 2B | VQAv2 | 32.03 | 42.72 | +10.69 |
| 2B | Video-MME | 44.56 | 49.22 | +4.66 |
| 2B | MLVU | 41.17 | 43.47 | +2.30 |
| 8B | GQA | 37.84 | 44.00 | +6.16 |
| 8B | VQAv2 | 46.29 | 50.44 | +4.15 |
| 8B | Video-MME | 50.44 | 52.89 | +2.45 |
| 8B | MLVU | 44.89 | 45.40 | +0.51 |
数据摘自原论文表 4,PDF 第 12 页。完整精度约为 GQA 58.59/59.04、VQAv2 77.05/77.86、Video-MME 73.44/78.78、MLVU 68.34/78.19(2B/8B)。
4-bit 视觉塔离全精度还有距离,但 RegCache 在图像与视频基准上都稳定抬升,说明前缀不是只对封闭分类有效。
5.4 跨数据集泛化
前缀是在 ImageNet-1k 训练集上搜的。在 Stanford Cars、Flowers-102、Food-101、CIFAR-100、Caltech101、Oxford-IIIT Pet、DTD 上做零样本,Naïve → RegCache 的提升仍然很大(例如 CLIP 在 Food-101 上 +41.38,SigLIP2 在 Food-101 上 +55.92)。这支持 register 可迁移,而非过拟合到 ImageNet 类别。
6. 异常值下降与消融
6.1 最大 token 范数被压下去
| 模型 | Vanilla 最大 token 范数 | + RegCache | 降幅 |
|---|---|---|---|
| CLIP | 41.38 | 11.45 | 约 72% |
| OpenCLIP | 92.78 | 9.64 | 约 90% |
| SigLIP | 35.82 | 3.64 | 约 90% |
| SigLIP2 | 148.20 | 15.16 | 约 90% |
数据来自原论文表 6,PDF 第 13 页;W8A8,500 张图平均。
范围收窄直接对应量化分辨率提高,是方法起效的机理证据。
6.2 只做一半更糟
| 方法 | SigLIP-B/16 | SigLIP2-B/16 |
|---|---|---|
| Baseline(无 RegCache) | 69.71 | 26.04 |
| 仅 Prefix Caching(PC) | 74.37 | 23.82 |
| 仅 Token Deleting(TD) | 42.41 | 69.06 |
| PC + TD | 74.38 | 72.35 |
数据来自原论文表 7,PDF 第 13 页。
消融很清楚:
- SigLIP:单靠 PC 已接近完整版;单靠 TD 反而从 69.71 掉到 42.41。
- SigLIP2:单靠 PC 不够(23.82,低于 baseline 的 26.04);单靠 TD 很强(69.06),但两者合用最高(72.35)。
也就是说 insert 与 delete 是配套的。外部 register 吸走大部分注意力异常,删除清掉残余;只做一半甚至会破坏原有 token 布局。
6.3 延迟几乎不动
| 设置 | 方法 | 延迟 | 加速 |
|---|---|---|---|
| CLIP-B/16,bs=64 | FP32 | 132.13 ms | — |
| CLIP-B/16 | INT8 | 60.64 ms | 2.18× |
| CLIP-B/16 | INT8 + RegCache | 61.27 ms(+1.04%) | 2.16× |
| SigLIP-B/16 | INT8 + RegCache | 63.25 ms(+1.54%) | 2.03× |
| Qwen3-VL-2B 图像 | INT8 + RegCache | 相对 INT8 约 +0.8% | 2.08×(TTFT) |
| Qwen3-VL-2B 视频 | INT8 + RegCache | 相对 INT8 约 +0.01% | 2.79×(TTFT) |
数据来自原论文表 8,PDF 第 14 页;A6000 + TensorRT。
额外 token 操作被标成可忽略(≤1.54%)。视频输入上视觉塔更成为瓶颈,量化视觉塔的 TTFT 收益超过 2×。
7. 结论边界与阅读注意
三个观察 + 三步流程,支撑了「RegCache 能在多种 PTQ 上稳定改善低比特视觉编码器」这一主张,尤其在 W4A4。机理上,最大 token 范数显著下降;设计上,PC 与 TD 缺一不可。
阅读和复现时建议保留这些边界:
- 并非零成本训练无关。 方法 training-free,但仍要选敏感层、扫 τ、调 k / k̃,总搜索约 1 小时(RTX 4090 + RTN)。论文也把超参需按模型与底座分别调列为 limitation。
- 参考任务不是完全无标签真空。 默认敏感层与 τ 在 ImageNet-1k 训练集 上验证;附录才有无标签重建损失版本。
- 不是所有模型都吃同一套配方。 DINOv2 的插入位置、增益幅度都不同;W8A8 上有时近乎持平或微降。
- 删除 token 会改序列。 若下游严格依赖全部 patch(稠密预测、分割),需要单独验证;论文主实验是分类、检索与 VLM 问答/视频理解。
- 异常值机制仍未关完。 作者自己也指出,视觉与 LLM 的 outlier 行为差异值得继续研究;register 最优形态也未解决。
- 数字来自作者报告配置。 ImageNet / COCO / Qwen3-VL、特定 PTQ 底座与硬件;不自动推广到任意分辨率、任意 ViT 尺寸或端侧 NPU。
对照相关工作时还可以记一句:Jiang 等人的 test-time register 会把通道最大激活「搬到」额外 token;RegCache 则是 预计算 + 前缀 KV + 删除,专为量化动态范围设计,推理时不做重活。DINOv3 训练时就带 register,是少有的「一开始就具备 sink」的视觉编码器例外。
原始来源
- RegCache GitHub
- 本文依据本地 PDF:
44.RegCache.pdf,19 页(正文 15 页 + 参考文献) - 图 1—图 5 分别位于 PDF 第 2、3、6、7、8 页
- 表 1(余弦相似度)第 7 页;表 2—4(主实验)第 11—12 页;表 5(跨数据集)第 13 页;表 6—7(范数与消融)第 13 页;表 8(延迟)第 14 页
- 方法公式(候选集、删除集合)见 PDF 第 9—10 页 §4.1—4.3
文中图 1—图 5 均裁自上述 PDF,并在图注中标明图号与页码。量化步长对照表与「insert / delete 分工」表由本文整理,用于解释机制,不是论文实验结果。
See also
- DVD-Quant 论文解读:无需校准数据的视频 DiT 低比特量化 2026-10-05
- P4Q 论文解读:用提示学习和低位宽适配器修复 CLIP 的图文对齐 2026-10-05
- D4C 论文解读:没有真实图片,如何把 CLIP 量化到低位宽 2026-10-03
- 一次完整的 WSL2 安装排障:从 BIOS、TPM 判断到 Windows 11 修复安装 2026-07-07
- 把一个 SPA 博客补成可预渲染、可同步、可持续部署 2026-05-29