P4Q 论文解读:用提示学习和低位宽适配器修复 CLIP 的图文对齐
把 CLIP 的浮点权重压成低位宽整数之后,模型仍然能输出图像向量和文本向量,但两种向量之间的相似度排序可能已经改变。原本匹配的图片与描述,经过量化后未必还能匹配。对依靠图文相似度分类的 CLIP 来说,这会直接影响预测。
P4Q 的做法是在训练后量化的基础上增加少量可学习参数:文本端学习一组连续提示,图像端增加一个低位宽适配器 QAdapter,并用全精度 CLIP 的预测指导训练。量化后的两个编码器保持冻结,新增参数负责调整最终表征之间的关系。
这是一种使用真实下游数据的量化与轻量适配方法。论文主实验训练 50 个 epoch,不能把它理解为不需要训练的 PTQ,也不能把结果当成没有见过目标数据的零样本分类。本文结合原论文五幅图解释机制,所有实验数字来自作者报告,未经独立复现。
论文信息
| 项目 | 信息 |
|---|---|
| 题目 | P4Q: Learning to Prompt for Quantization in Visual-language Models |
| 作者 | Huixin Sun、Runqi Wang、Yanjing Li、Xianbin Cao、Xiaolong Jiang、Yao Hu、Baochang Zhang |
| 单位 | 北京航空航天大学、小红书、中关村实验室 |
| 本文依据 | arXiv:2409.17634v1,2024 年 9 月 26 日提交,PDF 共 12 页 |
| 版本状态 | 本文读取的 PDF 标注 Preprint / Under review;不据此推断后续录用情况 |
| 原文 | PDF · HTML |
| 主要实验 | CLIP ViT-B/32,CIFAR100、ImageNet-1k,以及四个 ImageNet 分布偏移测试集 |
后文使用以下术语。
| 术语 | 含义 | 在 P4Q 中的作用 |
|---|---|---|
| PTQ | Post-Training Quantization,训练后量化 | 先把预训练编码器量化,构造低位宽基础模型 |
| QAT | Quantization-Aware Training,量化感知训练 | 论文对照的另一类量化范式,通常需要较多参数参与优化 |
| Prompt | 可学习的连续文本提示向量 | 调整量化文本编码器的输出 |
| QAdapter | 量化适配器 | 调整量化图像编码器的输出 |
| W-A-Attention | 权重、一般激活、注意力相关激活的位宽 | 例如 4-4-8,并非全模型统一 4 位 |
| Top-1 | 最高得分类别与真实标签一致的比例 | 本文主要比较的分类准确率 |
1. 为什么单独量化两个编码器会破坏分类
CLIP 用图像编码器 得到图像特征 ,用文本编码器 得到类别描述的特征 。例如,把类别写成 a photo of a dog、a photo of a cat,再比较图片与每个描述的余弦相似度。分类概率可以写为:
这里的 表示余弦相似度, 是类别数, 是温度参数。决定类别的不只是某个编码器的输出是否接近原值,还有图片与所有文本之间的相对关系。
均匀量化将浮点数映射到有限的整数刻度,一般包含缩放、舍入和截断。两个编码器的结构和激活分布不同,分别校准它们的数值范围,并不自动保证最终相似度矩阵得到保留。一处较小的表征误差,就可能让两个接近的类别交换排名。
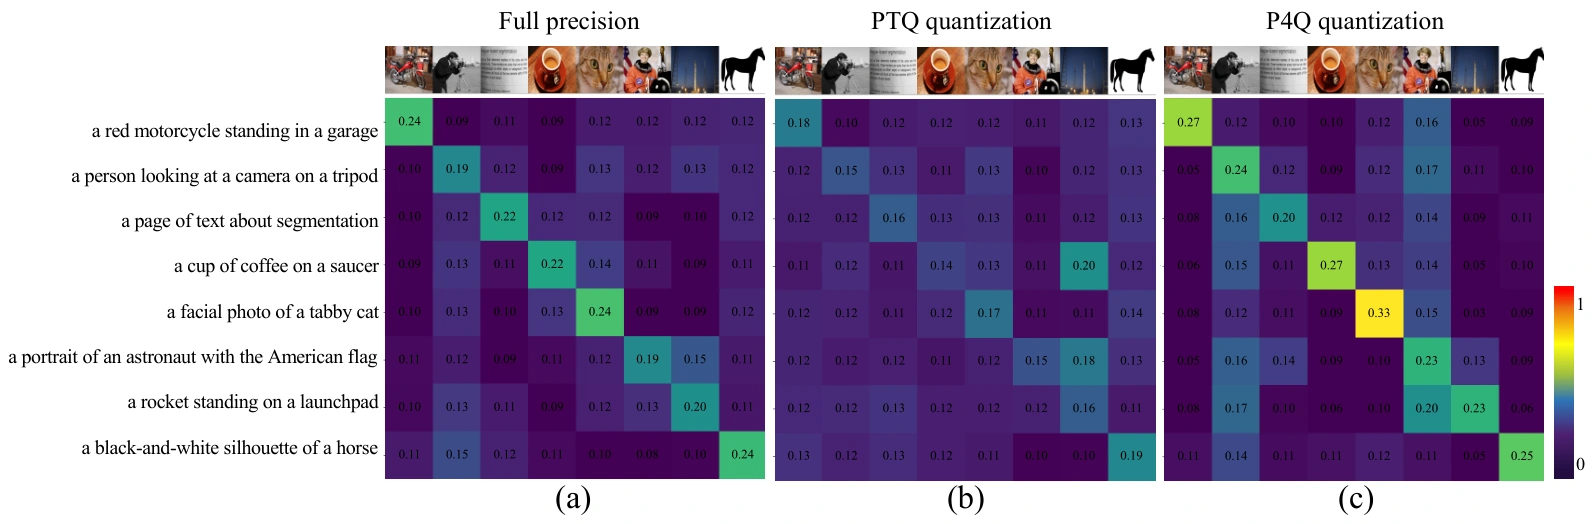
原论文图 1,PDF 第 2 页。横轴为八张图片,纵轴为对应描述;颜色越亮,余弦相似度越高。三幅矩阵依次来自全精度 CLIP、PTQ 和 P4Q。
读图时先看对角线:图片与自己的描述应当形成较亮的匹配位置。全精度模型的对应关系较清楚,直接 PTQ 后出现了错位;论文举出的例子是火箭图片与咖啡描述发生错误匹配。P4Q 使正确匹配的位置重新变亮。
图 1 直观展示了要修复的关系,但仅包含八个例子。它不能替代测试集准确率,也不能证明所有语义关系都恢复到了全精度模型的水平。
这一问题在 CIFAR100 上十分明显:论文表 1 中,全精度零样本 CLIP 的 Top-1 是 65.34%,4-4-8 的 OMSE PTQ 基线只有 46.05%,下降 19.29 个百分点。P4Q 试图用有限的可学习参数弥补这种损失。原文第 1 节、表 1
2. 整体框架:两个冻结编码器,两个可学习入口
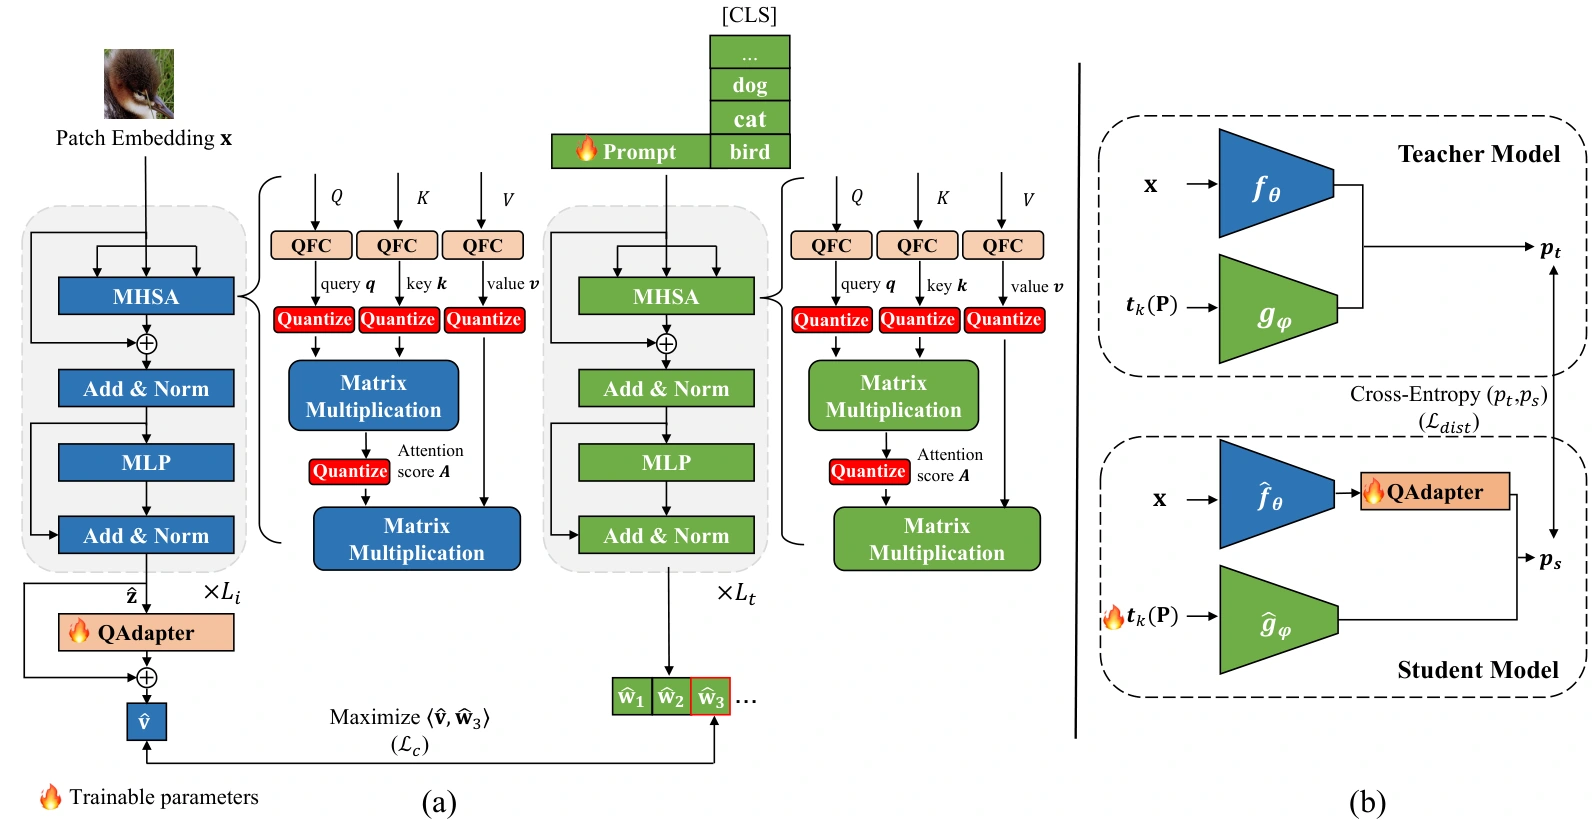
原论文图 2,PDF 第 4 页。蓝色是图像分支,绿色是文本分支;火焰标出可学习参数。左侧展示量化后的编码与对齐过程,右侧展示全精度教师和低位宽学生之间的预测蒸馏。QFC 表示量化全连接层。
图 2 可以沿两条数据路径阅读。
图像进入量化后的图像编码器,得到低位宽特征 ,再经过 QAdapter 得到调整后的 。文本端则把可学习提示与类别名称拼接,输入量化后的文本编码器,得到 。最后使用 与各个 的相似度分类。
两个编码器都由预训练 CLIP 初始化,再进行 PTQ,其权重在 P4Q 的适配阶段保持冻结。真正被优化的是文本提示和 QAdapter。这样就把训练范围集中到输入端的文本上下文及输出端的图像特征变换,保留预训练骨干的大部分结构。
全精度教师在训练阶段提供参考预测。推理时使用低位宽学生,不需要同时运行教师。这里减少的是需要更新的参数范围;训练期间仍然需要图像编码、文本编码和教师前向计算,冻结权重也不代表训练成本为零。
3. 文本提示:在量化后的模型里重新组织类别描述
手工模板使用固定的词,例如 a photo of a [CLASS]。P4Q 把类别名称前面的上下文替换成可学习向量:
表示第 类名称的嵌入, 是连续提示向量;这组提示在各类别之间共享。默认长度 。它们并不要求对应某些可直接阅读的自然语言词汇。
提示的作用可以从梯度路径理解:文本编码器的权重虽然不更新,提示仍可以通过它接受分类和蒸馏目标的监督。改变输入上下文,就能改变输出文本特征在量化模型中的位置。
这与普通全精度提示学习存在一个关键区别:P4Q 优化时面对的是已经量化的文本编码器以及量化图像特征。提示需要同时适应任务类别和量化引入的误差。直接把全精度模型上学到的提示搬过来,未必能得到相同的对齐关系;本文的实验并未把两种做法视为等价。
不过,提示只控制文本分支。图像编码器保持冻结时,同一图片的 不会因提示改变而改变。论文因此在图像端增加 QAdapter,让两端都能调整。
4. QAdapter:保留原特征,再加入小幅修正
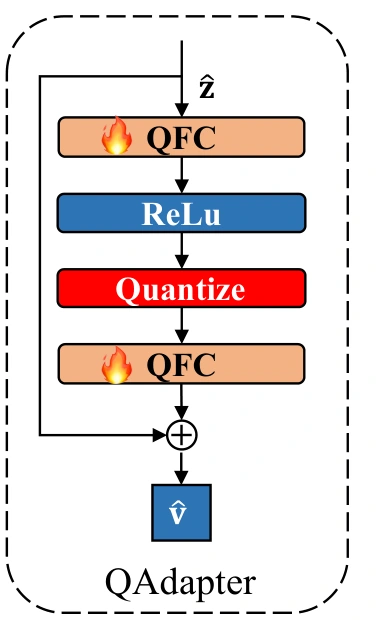
原论文图 4,PDF 第 6 页。主路径经过 QFC、ReLU、量化和第二个 QFC;旁路保留输入特征,最终融合得到图像端输出。
QAdapter 是一个带旁路的瓶颈模块,由两个低位宽全连接层构成。用论文式(11)的简化记法,可以写为:
原式为简洁省略了 ReLU,图 4 给出了实际结构。 控制适配分支的比例:较小的值保留更多原始 CLIP 特征,较大的值允许适配器承担更强的变换。主实验固定 ,而 QAdapter 本身固定为 8 位。
因此,4-4-8 或 2-2-8 的 P4Q 并不是连新增模块都统一使用 4 位或 2 位。比较模型体积、部署算子和运行速度时,需要把这个混合精度结构一起考虑。
QAdapter 的输入是图像特征,没有把所有类别文本作为额外输入直接送进适配器。它与文本端的联系来自共同的相似度和损失函数:图像端往一个方向移动时,文本端也接受监督,二者共同形成更适合当前低位宽模型的匹配关系。
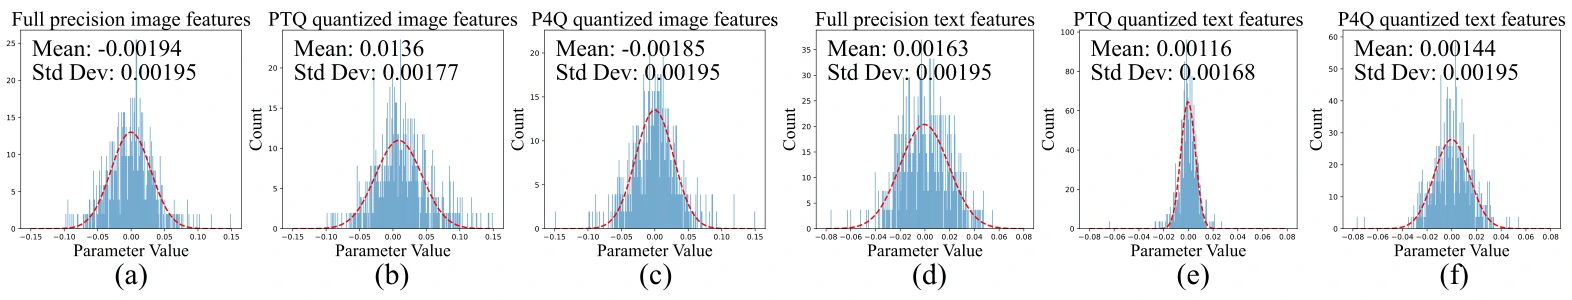
原论文图 3,PDF 第 5 页。前三幅为图像特征,后三幅为文本特征;每组分别对应全精度、PTQ 和 P4Q。横轴是特征元素数值,纵轴是元素数量。
图 3 显示,PTQ 后特征元素的分布发生变化,P4Q 后部分统计形态更接近全精度结果。但直方图把所有元素汇总在一起,丢失了向量方向和类别间关系;均值、标准差接近,并不自动等于语义对齐。它应当与图 1 的相似度、表 1 的准确率共同阅读。
5. 训练目标:真实标签与教师预测共同提供监督
调整后的学生预测为:
论文的分类目标对真实类别取负对数概率:
原文将其与 CLIP 的对比监督联系起来。按式(13)的写法,这里的分母是任务类别的文本描述,目标是正确类别的分类交叉熵;不能直接替换成原始 CLIP 预训练中的双向批内图文对比损失。
教师通过全精度图像、文本编码器得到相似度预测 ,学生再通过预测层面的蒸馏接受监督。整体目标为:
标签告诉模型哪一个类别是正确的;教师的软预测则提供类别之间相对相似性的参考。P4Q 采用最终预测监督,不要求逐个匹配所有中间 block 的特征。原文第 3.3 节
**复现时有一处需要单独核对:**原文式(14)印出的蒸馏项是学生概率乘教师概率的对数,即 的方向,与常见的 写法不同,而且没有明确展开对所有类别的求和。仅凭该式无法确认作者实际实现。本解读保留“基于相似度预测的蒸馏”这一方法描述,不擅自将它改写成一个已经核实的标准 KL 实现。
实验采用怎样的数据与训练设置
| 设置 | 论文报告 |
|---|---|
| 骨干 | ViT-B/32 图像编码器与文本 Transformer,各 12 个 block |
| 权重量化 | 有符号、按通道量化 |
| 激活量化 | 无符号、按层量化;基线采用 OMSE |
| 校准数据 | 从训练图片随机采样 10 个迭代批次;校准 batch size 为 128 |
| Prompt 优化 | SGD,学习率 ,weight decay 为 0, |
| QAdapter 优化 | AdamW,初始学习率 ,8 位, |
| 主实验训练 | 每个数据集 50 个 epoch;训练和验证 batch size 为 128 |
| 损失权重 | |
| 实验硬件 | 4 张 NVIDIA RTX 3090 Ti,各 24 GB 显存 |
“不需要 CLIP 原始预训练数据”和“不需要真实下游数据”是两件不同的事。P4Q 使用真实训练图片进行校准与带标签的适配;跨数据集实验也明确使用全部 ImageNet 训练样本。本文没有把主实验标成 few-shot,也没有据此声称一张消费级显卡即可复现所有设置。
6. 分类结果:要看位宽,也要看比较对象
CIFAR100:4 位修复明显,更低位宽仍有损失
下面摘录原文表 1 的 Top-1 准确率,单位为 %。位宽按 W-A-Attention 标注;所有结果均为作者报告。
| 方法 | 32-32-32 | 8-8-8 | 4-4-8 | 3-3-8 | 2-2-8 |
|---|---|---|---|---|---|
| 零样本 CLIP | 65.34 | — | — | — | — |
| 全精度 Prompt | 76.51 | — | — | — | — |
| 全精度 Linear Probe | 80.50 | — | — | — | — |
| OMSE PTQ 基线 | — | 64.48 | 46.05 | 16.79 | 5.89 |
| 量化 Linear Probe | — | 79.03 | 66.11 | 30.53 | 9.20 |
| P4Q | — | 79.42 | 69.20 | 47.83 | 31.09 |
在 4-4-8 下,P4Q 相比同位宽 OMSE 基线提高 23.15 个百分点。但基线只做 PTQ,P4Q 还使用标签进行了适配,这个差值包含任务学习和量化误差修复的共同作用。与同样进行监督适配的量化 Linear Probe 比较,提高为 3.09 个百分点,更能帮助判断适配结构带来的收益。
8 位 P4Q 的 79.42% 高于全精度 Prompt 的 76.51%,但仍低于全精度 Linear Probe 的 80.50%。4 位 P4Q 的 69.20% 高于全精度零样本 CLIP,却低于全精度 Prompt。因此,“超过全精度”必须写明超过哪一种全精度设置;量化与任务适配共同进行,也不等于量化本身提高了精度。
位宽进一步下降后,P4Q 虽然大幅改善 PTQ 基线,3 位和 2 位的结果仍明显低于全精度零样本 CLIP。这表明新增参数只能补偿一部分信息损失。原文表 1
ImageNet:8 位有竞争力,不能概括为全面超过全精度
下面摘录原文表 2 中数值可直接辨认的结果,Top-1 单位为 %。
| 方法 | 位宽 | Top-1 | 模型大小(MB) |
|---|---|---|---|
| 零样本 CLIP | 32-32-32 | 63.36 | 577.08 |
| 全精度 Prompt | 32-32-32 | 64.70 | 577.08 |
| 全精度 Linear Probe | 32-32-32 | 76.10 | 577.08 |
| MinMax PTQ | 8-8-8 | 63.14 | 146.95 |
| 量化 Linear Probe | 8-8-8 | 66.90 | 147.45 |
| P4Q | 8-8-8 | 66.94 | 147.08 |
| MinMax PTQ | 4-4-8 | 56.85 | 94.76 |
| 量化 Linear Probe | 4-4-8 | 58.80 | 94.78 |
| P4Q | 4-4-8 | 61.97 | 94.89 |
| P4Q | 3-3-8 | 53.62 | 82.09 |
| P4Q | 2-2-8 | 25.19 | 68.80 |
8 位 P4Q 比全精度 Prompt 高 2.24 个百分点,与量化 Linear Probe 只相差 0.04 个百分点。论文没有为这组差值提供重复实验的置信区间,因而不宜把 0.04 个百分点解读为稳定优势。它也仍低于全精度 Linear Probe 的 76.10%。4 位 P4Q 则比同位宽量化 Linear Probe 高 3.17 个百分点。
原文数字存在一致性问题。 表 2 的 OMSE Baseline 在 8 位与 4 位分别列为 64.48%、46.05%;表 3 的 4 位 Baseline 却是 56.96%。第 4.3 节给出的若干增益和下降幅度也不能全部与表 2 对上。因此,此处没有挑选一个数值当作“修正后的基线”,也没有用有冲突的 OMSE 行计算宣传性增益。上表主要保留 P4Q、MinMax 与量化 Linear Probe 的明确记录;正式复现仍需核对实验输出。原文表 2、表 3及第 4.3 节
模型变小,不等于设备运行时间按比例缩短
按作者表中的大小,8 位 P4Q 从 577.08 MB 缩到 147.08 MB,约为 3.92 倍压缩;4 位 P4Q 为 94.89 MB,约为 6.08 倍压缩。它们接近论文使用的“约 4 倍”和“约 6.1 倍”表述。4 位基线与 P4Q 的差额为 0.13 MB,对应新增适配器的小体积开销。
论文把约 53.188 G 与 13.271 G 的计算成本差异表述为理论加速,但没有给出目标端侧设备上的延迟、吞吐、能耗或低位宽 kernel 测试。低位宽计算的成本口径,也不能直接等同于常规浮点算术操作数减少四倍。
实际运行收益依赖整数算子支持、量化与反量化开销、内存访问、batch size,以及注意力和适配器的精度设置。文章可以据此说明压缩潜力,不能直接承诺“推理快四倍”。
7. 消融:提示与适配器互补,但更多适配并非总是更好
原文第 4.5 节在 CIFAR100 上拆分两个可学习组件。4-4-8 设置下,Top-1 为:
| 配置 | Top-1(%) |
|---|---|
| PTQ 基线 | 46.05 |
| 仅 Prompt | 63.89 |
| 仅 QAdapter | 66.28 |
| Prompt + QAdapter | 69.20 |
两个组件单独加入都有效,合用后又进一步提高准确率。这支持它们在本文设置下具有互补性:只调整文本端或只调整图像端,都没有达到联合适配的结果。增益并不是两个单独增益的简单相加。
损失消融使用 20 个 epoch,与主实验的 50 个 epoch 分开比较:仅蒸馏为 64.50%,仅分类目标为 66.34%,两者联合且 时为 68.12%。联合目标比仅分类目标提高 1.78 个百分点;不要把 68.12% 与主实验 69.20% 的差异归因于某个模块,因为训练时长也不同。
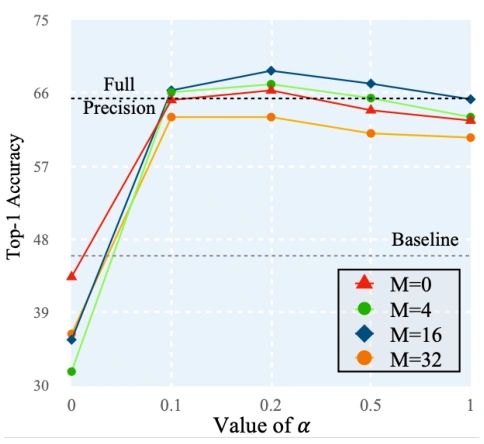
原论文图 5,PDF 第 10 页。在 4 位、20 个 epoch 的实验中,横轴是适配比例 ,不同颜色表示提示长度 。
图 5 展示了一个实际取舍:增加适配比例可以先提升准确率,但把原图像特征全部交给适配分支,并没有带来最佳结果;提示也不是越长越好。作者在测试的组合中选择 、,达到 68.12%。这支持保留原始特征与适配修正之间需要平衡,但不是适用于所有数据集和模型的通用最优参数。原文第 4.5 节
8. 跨数据集结果:源域更准,目标域未必同步改善
论文把 4 位 P4Q 在全部 ImageNet 训练样本上适配,再直接测试 ImageNet-A、ImageNet-R、ImageNet-V2 和 ImageNet-Sketch。目标数据集不参与这次适配,测试的是分布偏移后的迁移表现;这与完全不使用源域标签的训练设置不同。
下面按原文表 3记录 Top-1,单位为 %。基线数值只用于解释该表内部的结果,不与前述存在冲突的表 2 合并。
| 方法 | ImageNet | ImageNet-A | ImageNet-R | ImageNet-V2 | ImageNet-Sketch |
|---|---|---|---|---|---|
| 全精度零样本 CLIP | 63.36 | 31.54 | 69.36 | 56.72 | 41.30 |
| 4 位 PTQ 基线 | 56.96 | 22.64 | 66.48 | 50.45 | 33.04 |
| P4Q,10 epoch | 59.63 | 22.62 | 66.56 | 51.92 | 34.25 |
| P4Q,20 epoch | 61.21 | 22.65 | 66.52 | 52.07 | 33.40 |
| P4Q,50 epoch | 61.97 | 22.62 | 66.56 | 50.65 | 32.92 |
随着训练从 10 个 epoch 延长到 50 个,ImageNet 上的准确率持续提高,但目标域表现没有同步提高。ImageNet-V2 在 20 个 epoch 时达到 52.07%,到 50 个 epoch 降至 50.65%;Sketch 从 10 个 epoch 的 34.25% 降至 50 个 epoch 的 32.92%,后者略低于 PTQ 基线的 33.04%。ImageNet-A 基本没有改善。
因此,更准确的结论是:P4Q 在部分目标域和较短训练设置下保留或改善了 PTQ 模型的迁移表现,同时存在适配与泛化之间的取舍。 表 3 不支持所有目标域都提高,也不支持低位宽模型普遍恢复了全精度 CLIP 的分布外能力。选择训练时长应结合预期使用场景,而不只是追求 ImageNet 上的最高分。
9. 与 D4C 对照:一个学习适配参数,一个改进校准样本
TechLoop 之前的 D4C 论文解读也讨论 CLIP 量化,但它处理的是另一种数据条件。
| 对照项 | P4Q | D4C |
|---|---|---|
| 主要问题 | PTQ 后图文对齐受损,同时需要适配下游任务 | 没有真实校准图片时,合成样本缺少语义和内部结构 |
| 量化阶段的数据 | 真实下游训练图片,并使用标签进行适配 | 从噪声优化合成图片,结合预训练 CLIP 和概念提示 |
| 关键机制 | Learnable Prompt、QAdapter、相似度预测蒸馏 | PGSI、SCG、PAE 改善合成校准数据 |
| 本文涉及的主要评估 | 带监督的任务适配及跨数据集迁移 | 数据无关量化后的零样本分类 |
P4Q 表明,冻结量化骨干后,可以通过少量参数调整跨模态关系;D4C 则强调,缺少真实图片时,校准输入本身需要有语义和结构。两篇论文的数据、训练和量化条件不同,不能把它们的准确率直接放进同一张表排名。
把合成校准与轻量适配结合起来可以作为后续研究问题,但需要重新验证合成数据质量、标签来源、蒸馏实现和泛化效果;这不是任一论文已经证明的结果。
局限与结论
P4Q 的证据主要来自 CLIP ViT-B/32 在 CIFAR100 和 ImageNet 分类上的实验。它说明了文本提示与图像适配器联合学习在这些设置中的价值,但尚不能直接外推到更大视觉语言模型、生成任务、检测或医学应用。
阅读和复现时尤其需要保留四个边界:主结果包含真实下游数据上的监督训练;低位宽配置包含 8 位注意力和 QAdapter;模型大小与理论计算成本不代表实测延迟;ImageNet 基线记录及蒸馏公式还需要核对。更长训练也可能牺牲部分跨域表现。
这篇论文最有启发性的地方,是把低位宽 CLIP 的修复目标放在图像与文本之间的匹配关系上,并为两个分支分别提供小规模调整入口。实验支持这种联合适配可以明显改善直接 PTQ 的分类表现,同时也显示:信息损失、监督数据条件和泛化取舍仍然决定它的适用范围。
来源与图表说明
- P4Q 原论文与版本记录。本文逐页读取其 12 页 PDF,方法依据第 3 节,结果依据表 1—3,消融依据第 4.5 节及图 5。
- P4Q PDF。本文五幅配图均从该版本原图提取,保留图中结构和数值,并在相应段落给出中文图注;封面使用图 2 的模型框架,加白色留边以完整展示。
- D4C 原论文。仅用于方法条件对照,未进行两者共同设置下的实验比较。
数值均为原论文报告;本文计算的差值使用“百分点”,压缩比由表内模型大小相除得到。图表的可视化趋势与作者方法解释在正文中讨论,不作为未经验证的因果证明。
See also
- DVD-Quant 论文解读:无需校准数据的视频 DiT 低比特量化 2026-10-05
- D4C 论文解读:没有真实图片,如何把 CLIP 量化到低位宽 2026-10-03
- 一次完整的 WSL2 安装排障:从 BIOS、TPM 判断到 Windows 11 修复安装 2026-07-07
- 把一个 SPA 博客补成可预渲染、可同步、可持续部署 2026-05-29
- 把宿舍 Windows 主机改成可远程训练的 WSL 工作站 2026-05-27