D4C 论文解读:没有真实图片,如何把 CLIP 量化到低位宽
量化一个已经训练好的模型,通常需要少量真实样本:让模型跑一遍,观察中间激活,再决定低位宽整数应该怎样表示这些数值。如果原始数据无法访问,这一步就成了难题。
D4C 研究的是这一问题在 CLIP 视觉语言模型上的表现。它从高斯噪声出发,利用预训练 CLIP 内部已有的知识,优化出一小批合成图片,再用这些图片完成量化。关键在于:图片不仅要能触发模型,还需要携带可区分的语义,以及同一张图内部的空间差异。
本文按“问题在哪里 → 三个模块怎样解决 → 实验能支持什么”的顺序展开。原文图放在对应解释附近,实验数字均取自论文,未经本文独立复现。
论文信息
| 项目 | 信息 |
|---|---|
| 题目 | D4C: Data-Free Quantization for Contrastive Language-Image Pre-training Models |
| 作者 | Wenlun Zhang、Yunshan Zhong、Zihao Ding、Xinyu Li、Kentaro Yoshioka |
| 单位 | 庆应义塾大学、海南大学 |
| 本文依据 | arXiv:2511.15411v2,更新于 2026 年 4 月 1 日;全文 10 页 |
| 发表信息 | arXiv 页面标注 Accepted to CVPRF 2026 |
| 原文 | PDF · HTML |
| 官方实现 | Keio-CSG/D4C |
先统一几个术语,后文沿用原论文的缩写。
| 缩写 | 含义 | 在本文中的作用 |
|---|---|---|
| PTQ | Post-Training Quantization,训练后量化 | 在预训练模型上校准、重构量化参数 |
| DFQ | Data-Free Quantization,数据无关量化 | 不使用真实图片进行量化校准 |
| PGSI | Prompt-Guided Semantic Injection,提示引导的语义注入 | 让合成图像与文本概念对齐 |
| SCG | Structural Contrastive Generation,结构对比生成 | 让前景与背景形成不同的表征 |
| PAE | Perturbation-Aware Enhancement,扰动感知增强 | 在生成过程中增加前景变化 |
| W4A8 | 权重 4 位、激活 8 位 | 位宽设置,具体层仍有例外 |
1. CLIP 为什么需要特别的校准图片
CLIP 有两个编码器。图像编码器把图片变成向量,文本编码器把文字变成向量。零样本分类时,可以把各个类别写成文本提示,例如 A photo of a banana,再比较图片与这些提示的向量相似度,将相似度最高的类别作为预测。
这种分类能力依赖图像与文本之间的对齐。量化只要改变了某些中间计算,就可能改变最终相似度的排序:原本更接近“香蕉”的图片,在量化后可能更接近另一个概念。
量化可以用下面两个式子理解。对一个浮点数 ,先得到整数表示,再还原为近似的浮点值:
这里 是缩放因子, 是零点, 是位宽。位宽越低,可用的整数刻度越少,舍入和截断的影响通常越明显。
权重本身可以直接读取,但激活取决于输入。校准图片若只触发了很狭窄的一类响应,得到的量化参数就可能无法覆盖真实图片的响应。D4C 进一步指出,对 CLIP 而言,校准数据还应当支持跨模态语义对齐,不能只追求某种内部统计量相似。
“数据无关”的范围是量化阶段不使用真实图片。 方法仍使用预训练模型、人工整理的概念提示;评估仍需要 CIFAR 和 ImageNet 等真实测试集。它也不意味着 CLIP 的预训练没有使用数据。
2. 传统 DFQ 方法在 CLIP 上缺了什么
论文比较了两类常见的合成约束。对 CNN,BNS 利用模型保存的 Batch Normalization 统计量引导图片生成;对 ViT,PSE 利用 patch 相似度熵构造生成目标。这些约束可以指导单模态模型的校准,但在本文的 CLIP 实验里,精度仍明显低于真实数据校准。
例如,CIFAR-10、W4A8、零样本分类 Top-1 的结果是:RN50 用 BNS 得到 48.9%,真实图片校准为 71.7%;ViT-B/32 用 PSE 得到 53.7%,真实图片校准为 89.6%。论文将这一差距与以下两种样本缺陷联系起来。原文第 3.2 节及表 1
第一种缺陷:图片没有形成明确的语义
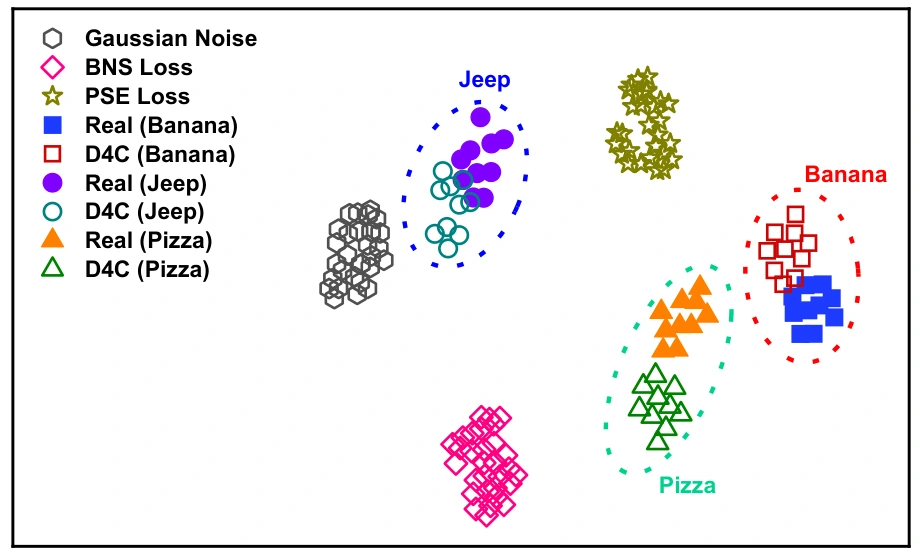
原论文图 1,PDF 第 2 页。实心符号表示真实类别图片,空心彩色符号表示 D4C 合成图片;高斯噪声、BNS 和 PSE 样本分别形成其他簇。
作者选取香蕉、吉普车和披萨三个类别,用 CLIP 的 ViT-B/32 编码器提取特征,再用 UMAP 投影到二维。
读图时先看真实图片:三类形成了不同的语义簇。再看传统合成样本:它们各自聚集,却远离这三个真实类别簇。D4C 的合成样本则更接近对应的真实类别。
这支持了论文的解释:传统约束可以生成“模型会响应”的图片,却未必生成“CLIP 能赋予明确类别含义”的图片。不过,UMAP 是局部样本的二维可视化,不能单独证明整个高维分布已经匹配,也不能替代量化后的精度实验。
第二种缺陷:同一张图内部太相似
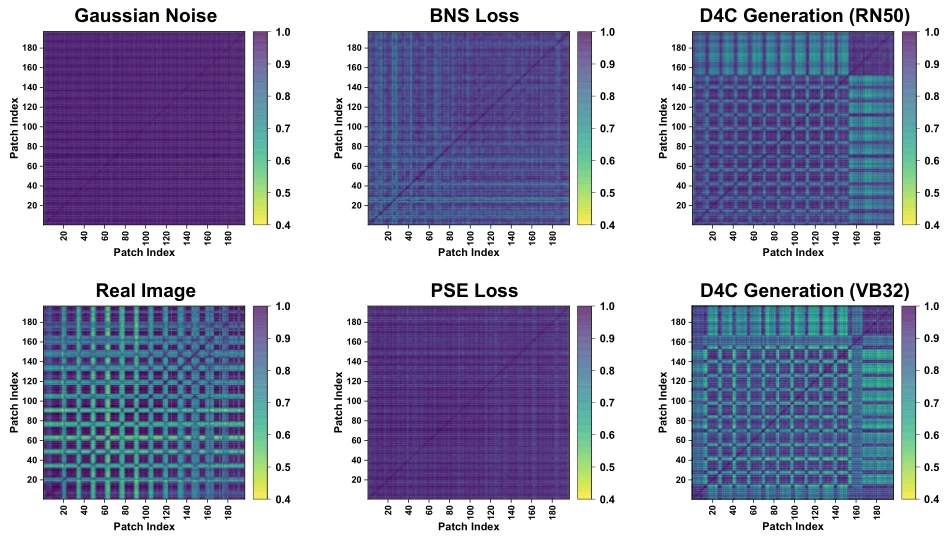
原论文图 2,PDF 第 2 页。横纵轴均为 patch 索引,每个位置表示两个局部区域的特征相似度;这些图是相似度矩阵,不是注意力图。
自然图片中,物体、天空、道路等区域的内容不同;同一物体内部的局部区域又往往存在联系。作者把图片划分为局部 patch,将各 patch 放大到 ,用一个预训练 ResNet-18 提取特征,再计算两两余弦相似度。
真实图片的矩阵出现交错的相似与不相似区域。噪声和传统合成图片的矩阵则比较均一,或缺少相应的结构。D4C 的矩阵更接近真实图片的交错模式。
这里区分的是两种多样性:不同图片要有不同语义,同一张图片内部也要有不同内容。 后者意味着校准样本不能只是某种纹理铺满整张图。
3. D4C 的整体流程:先造图片,再量化模型
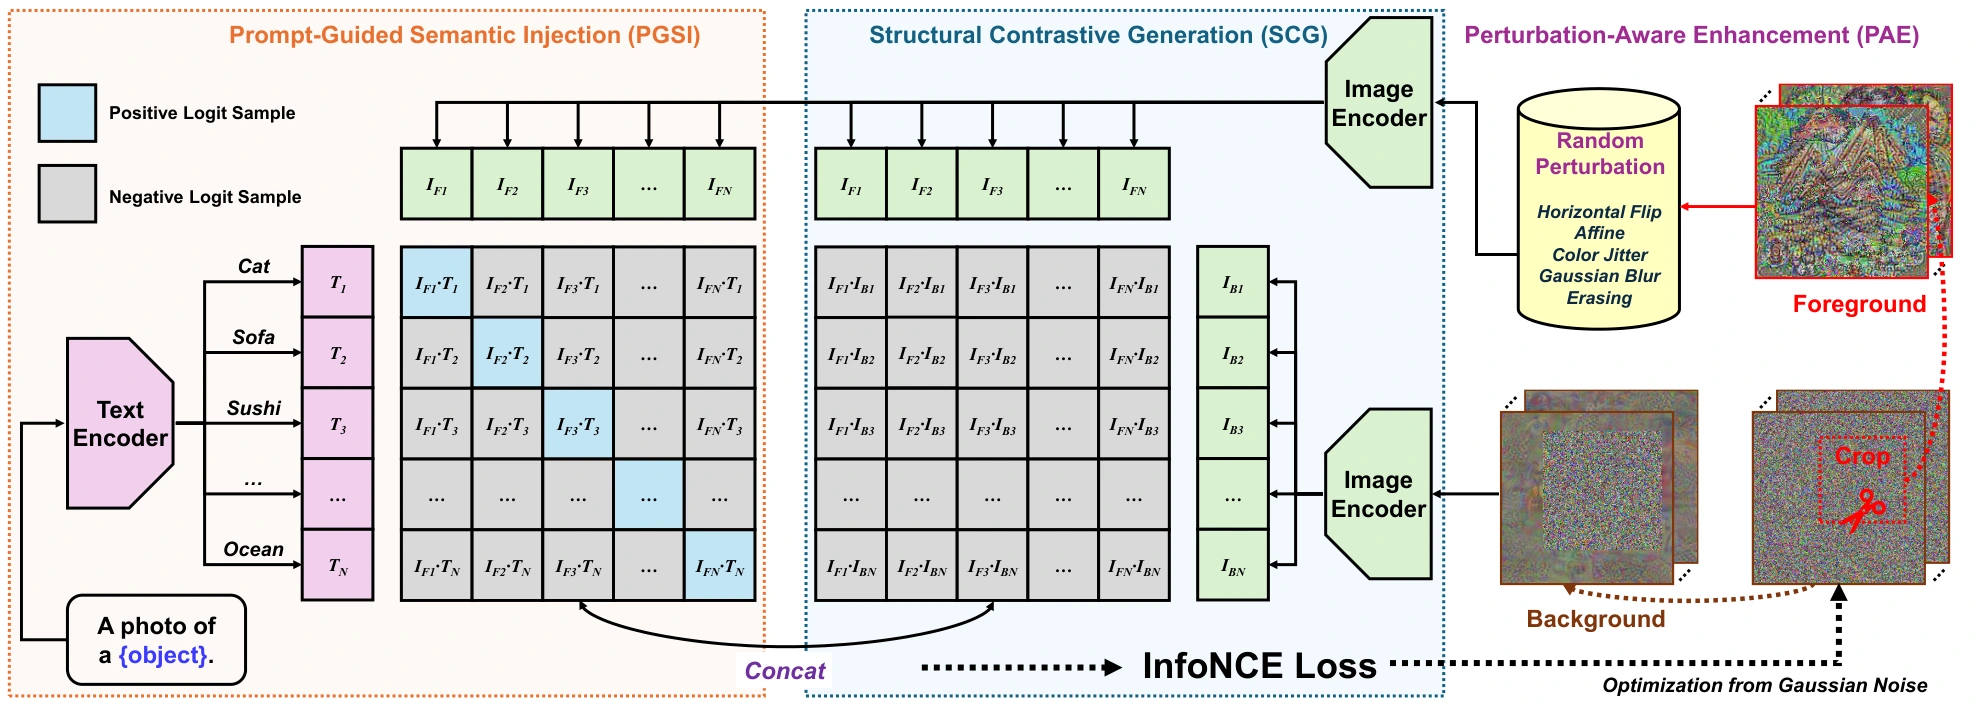
原论文图 3,PDF 第 4 页。左侧把文本概念引入生成过程,中间把前景与背景的相似度加入对比目标,右侧在前景送入编码器前施加扰动。图中的编码器调用来自已有预训练模型。
整个算法分成两个阶段:
- **合成阶段:**固定预训练 CLIP,把高斯噪声图片作为优化变量。用文本、前景与背景之间的关系计算损失,反向传播更新图片像素。
- **量化阶段:**用生成的图片校准图像编码器,用生成阶段使用的文本提示校准文本编码器;通过分块或分层重构调整量化参数。
因此,D4C 的核心贡献在校准数据的生成目标。它并未训练一个扩散模型,也没有依靠生成模型采样图片。生成阶段更新的是输入图片,而不是重新训练 CLIP。
三个模块分别对应三个要求:PGSI 给图片明确的概念,SCG 给图片内部的区域差异,PAE 减少对特定像素模式的依赖。
4. PGSI:用文字给噪声指定语义
假设一批图片从高斯噪声开始,分别指定“香蕉”“吉普车”“披萨”等概念。文本编码器得到对应的提示向量 ,图像编码器得到合成图片向量 。
PGSI 使用 InfoNCE 损失,让第 张图片更接近自己的提示,而不是其他提示:
是批大小, 是温度。分子对应匹配的图片与文字,分母把批内所有文字都纳入比较。
以“香蕉”为例,优化不仅需要提高图片与“香蕉”的相似度,还需要让它在其他概念面前具有可区分性。梯度沿图像编码器传回输入图片,逐步把随机像素变成更能表达这个概念的模式。
这并不保证生成一张适合人类观看的照片。它优化的是 CLIP 表征中的语义关系;校准是否有效,最终仍要看量化后的任务表现。论文使用 180 个整理好的代表性提示,覆盖动物、物体、食物和场景。原文第 3.3.1 节
5. SCG:让前景与背景表达不同内容
只要求整图像“香蕉”,一种可能的结果是整张图都充满香蕉相关纹理。这样的图片具有类别信号,却缺少自然图像中的空间组成。
SCG 用随机框把合成图片分成两个视图:
- **前景视图:**裁出框内区域并缩放,送入图像编码器,得到 。
- **背景视图:**将原图框内区域用高斯噪声遮蔽,再编码得到 。
这里的“前景”是生成过程中指定的区域,未使用真实物体检测框或分割标注。
然后,SCG 同时比较前景与文字、前景与背景。匹配的前景与文字是正样本;不匹配的文字和批内所有背景都是负样本。把原文式 5 的拼接操作展开,可以写成:
“香蕉”区域需要与香蕉文字对齐,也需要区别于背景。与单纯的文字引导相比,这个目标显式鼓励图像内部出现不同的表征,从而改善图 2 中局部区域关系过于均一的问题。
PGSI 的语义约束被整合进了 SCG 的联合对比目标。 最终训练不是将三个独立模块的损失随意相加;PAE 是输入扰动操作,PGSI 和 SCG 的关系通过上述同一个对比损失实现。原文第 3.3.2 节及算法 1
6. PAE:生成时就让前景经历变化
如果每次都把同一块像素直接送入编码器,合成图片可能学到一些只在特定位置、颜色或细节下成立的模式。PAE 在前景输入模型之前加入随机变化:水平翻转、仿射变换、颜色抖动、高斯模糊和随机擦除。
这些扰动发生在图片优化过程中。优化需要让经过不同扰动的前景仍与指定文字对齐,而不只是给最终生成的图片做一次后处理。
可以把这一过程理解为:前景挪动、变色或局部被擦掉之后,仍应保留足够的概念信号。论文据此解释 PAE 对多样性和鲁棒性的作用;其实际贡献由后面的消融实验检验。
完整的图片生成目标还加入总变分正则项:
总变分约束用于稳定像素优化,抑制过强的局部振荡。它没有把合成图片变成真实照片的保证。
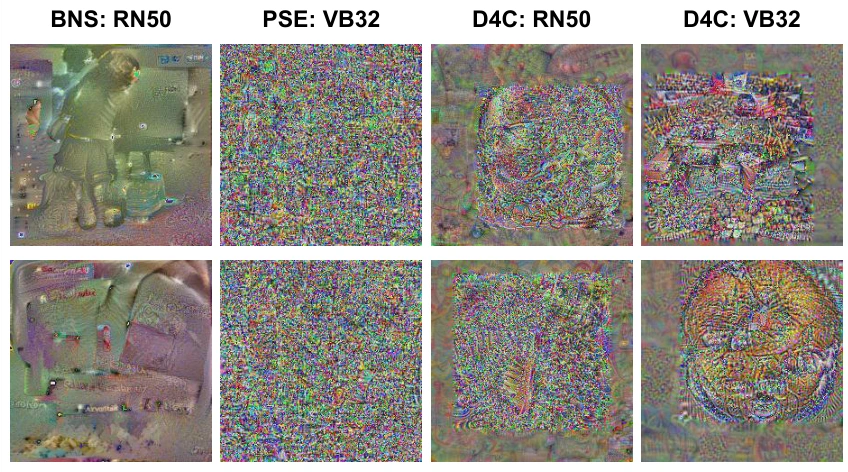
原论文图 4,PDF 第 8 页。D4C 合成图像出现更明显的局部区域和空间组成,但仍含大量噪声,不宜将其描述成逼真的自然照片。
这幅图也提醒读者:校准图片的用途是激活模型中的相关表征。视觉观感只能提供定性线索,不能直接说明校准质量。
7. 图片生成后,两个编码器怎样量化
图片合成完成后,D4C 使用优化式 PTQ,让量化模型各块或各层的输出尽量接近原始浮点模型:
和 分别表示浮点模型与量化模型第 个块或层的输出。CNN 采用分块重构,图像和文本 Transformer 采用分层重构。
图像编码器用合成图片,文本编码器复用 PGSI 的提示。两条分支都需要校准,因为最终分类依赖两者的向量关系。
论文第 4.1 节的主要实验设置如下:
| 环节 | 报告的设置 |
|---|---|
| 图像编码器 | RN50、RN50x16、ViT-B/32(VB32)、ViT-B/16(VB16) |
| 图片生成 | 批大小 16,学习率 0.01,优化 3,000 次 |
| 对比损失温度 | |
| 重构输入 | 随机采样 128 个图像输入、512 个文本输入 |
| 重构优化 | 20,000 次;图像学习率 ,文本为 |
| 参数初始化 | OMSE |
| 量化粒度 | 一般采用权重逐通道、激活逐张量的非对称量化;特定投影层另有设置 |
位宽标签有两个重要例外。第一,文本编码器的 MLP 是性能瓶颈,作者将这些层保持为 8 位并采用逐通道量化。第二,CNN 和 ViT 图像编码器的首层卷积不量化。Transformer 的 QKV 和 Linear-1 投影层也采用特别的激活量化粒度。
因此,阅读 W4A8 或 W6A6 结果时,应连同这些规则一起理解,不能将它们当作全模型所有层严格统一位宽的结果。原文第 4.1 节
8. 主实验:提升明显,但没有消除精度损失
评估任务是 CIFAR-10、CIFAR-100 和 ImageNet-1K 的零样本分类,指标为 Top-1 准确率。表 1 的 BNS&PSE 行,对 CNN 使用 BNS,对 ViT 使用 PSE;Real 行是使用真实图片校准的参考条件。
下面摘出 W4A8 设置。所有精度单位均为百分比,提升列为相对 BNS/PSE 的百分点差值。
| 模型 | 数据集 | 浮点模型 | 真实图片校准 | BNS / PSE | D4C | 提升(百分点) |
|---|---|---|---|---|---|---|
| RN50 | CIFAR-10 | 71.5 | 71.7 | 48.9 | 61.3 | +12.4 |
| RN50 | CIFAR-100 | 40.3 | 38.9 | 20.1 | 26.9 | +6.8 |
| RN50 | ImageNet-1K | 59.8 | 44.9 | 42.9 | 44.3 | +1.4 |
| VB32 | CIFAR-10 | 89.8 | 89.6 | 53.7 | 72.6 | +18.9 |
| VB32 | CIFAR-100 | 64.2 | 59.8 | 22.1 | 41.8 | +19.7 |
| VB32 | ImageNet-1K | 63.3 | 47.6 | 40.4 | 46.1 | +5.7 |
来源:原文表 1,PDF 第 6 页;按论文保留文本 MLP 的 8 位设置和首层卷积例外。
三个结论需要分开看。
第一,D4C 明显改善了本文所比较的 DFQ 基线。 例如 VB32 在 CIFAR-100 从 22.1% 提升到 41.8%,增加 19.7 个百分点。这是低位宽校准可用性的实质改善。
第二,相对真实校准的差距仍可能很大。 VB32 的 CIFAR-10 结果与真实图片校准相比仍差 17.0 个百分点,CIFAR-100 差 18.0 个百分点。不能把“比原有 DFQ 更好”写成“已经恢复浮点精度”。
第三,接近真实校准也不代表接近浮点模型。 VB32 在 ImageNet-1K 上,D4C 的 46.1% 接近 Real 的 47.6%,但两者都明显低于浮点模型的 63.3%。这一结果同时说明合成数据差距变小,以及量化策略本身仍有损失。
更低的激活位宽也并非总能平稳工作:VB16 在 CIFAR-10 的 W6A6 设置下,D4C 为 48.3%,高于 PSE 的 15.4%,但仍远低于真实图片校准的 85.9%。文本 MLP 保留 8 位这一例外,也进一步表明不同层的敏感性需要单独处理。原文表 1
9. 消融实验:三个模块各贡献了什么
下面摘出表 2 中 CIFAR-10、W6A6 的结果。除模块开关外,沿用论文的量化配置。
| 图片生成条件 | RN50 Top-1(%) | VB32 Top-1(%) |
|---|---|---|
| 高斯噪声,无三个模块 | 58.9 | 19.1 |
| 仅 PGSI | 61.0 | 42.1 |
| PGSI + SCG | 67.2 | 63.2 |
| PGSI + PAE | 71.0 | 71.7 |
| PGSI + SCG + PAE | 73.4 | 75.5 |
来源:原文表 2,PDF 第 7 页。
在 VB32 上,仅加入语义引导就提升 23.0 个百分点;在 PGSI 上加入 SCG,再提升 21.1 个百分点。这支持了“语义有帮助,图内结构也有帮助”的设计依据。
PGSI + PAE 的 71.7% 还高于 PGSI + SCG 的 63.2%,说明在这个条件下,扰动带来的收益很大。三者共同使用取得表中最好结果,但收益不是简单线性相加,也不能据此推断 SCG 在所有条件下都比 PAE 更重要。
论文表 3 进一步比较 PAE 的五种扰动。CIFAR-10、VB32、W6A6 下,未勾选五项扰动的基线行为 71.7%;仅勾选仿射变换为 75.1%,全部五种扰动为 75.5%。这里有一个需要保留的口径疑问:表 3 的基线 71.7% 与表 2 中 PGSI + SCG 的 63.2% 不同,正文未明确解释这一差别。因此,本文只比较表 3 内部的数值,不将它直接等同于表 2 的无 PAE 条件,也不合并两表计算增益。原文消融实验
10. 成本:离线生成开销与部署收益要分开看
合成图片需要反复经过预训练模型前向和反向计算。论文在 RTX A6000、48 GB 显存上合成 128 张图片,报告以下时间:
| 方法 | RN50 | RN50x16 | VB32 | VB16 |
|---|---|---|---|---|
| BNS / PSE | 1,280 秒 | 9,515 秒 | 3,488 秒 | 44,398 秒 |
| D4C | 1,623 秒 | 12,491 秒 | 1,434 秒 | 5,346 秒 |
来源:原文表 4,PDF 第 8 页。除 VB16 的 PSE 因显存限制使用批大小 8 外,其他设置使用批大小 16。
这张表衡量的是离线合成校准图片的时间,没有涵盖全部量化重构时间,更不是模型部署后的推理延迟。D4C 在 CNN 上比 BNS 更慢,在这两个 ViT 上比 PSE 更快;VB16 的比较还应注意批大小不同。
论文另报告 W4A8 模型相对 FP32 的存储缩减:RN50x16 为 5.63 倍,VB16 为 5.45 倍。对应的 4.16 倍、4.03 倍“加速”基于计算量估算,不能直接作为真实硬件上的端到端延迟承诺。实际收益还取决于整数算子支持、混合精度层、数据搬运和运行时实现。原文第 4.5 节
11. 从官方代码开始复现
官方仓库提供了合成与重构入口。下面是其 ViT-B/32、CIFAR-10、W6A6 示例,适用于 Linux、WSL 或其他支持反斜杠续行的 shell;先按仓库说明安装 PyTorch、仓库中的 CLIP 和 CLIP_benchmark,再安装所需依赖。
python d4c/solver/test_quant.py \
  --dataset cifar10 \
  --dataset_root ./your/dataset/root \
  --model ViT-B/32 \
  --q_config ./exp/config66.yaml \
  --recon \
  --dfq \
  --gen_img
--gen_img 启用伪图像生成,--dfq 指定 DFQ 模式,--recon 启用重构式 PTQ。--dataset_root 是评估数据的位置,不能因为 DFQ 就省去真实测试数据。官方 README
复现时需要记录代码版本、量化配置、提示集合、生成样本数和随机种子,并核对文本 MLP 与首层卷积的处理。若目标是某款设备上的部署,还需要另行测量模型文件大小、峰值内存、吞吐和实际延迟;本文未运行以上实验。
12. 局限与适用边界
仍有精度缺口。 论文自身将合成数据与真实数据之间的差距列为局限。部分组合接近真实校准,其他组合仍有明显损失;更低位宽条件并未全面解决。
验证任务集中于零样本分类。 四种图像编码器和三个数据集提供了不同架构的证据,但不能直接推导到检索、分割、视频理解或生成式视觉语言模型。医学场景是研究动机之一,本文没有给出医学数据上的验证。
“第一种”需要限定范围。 作者称其为首个面向 CLIP 的 DFQ 框架。这个表述限定在不使用真实图片校准的设定,不能扩大为“首次研究 CLIP 量化”;论文相关工作已经讨论了其他视觉语言量化方法。
提示集合和模型已有知识影响覆盖范围。 180 个代表性概念在这些分类基准上有效,但罕见概念、细粒度类别和专业领域能否被充分覆盖,仍需额外实验。前景与背景对比也是一种结构先验,并不等同于真实物体边界或完整的自然图像分布。
性能改善不等于隐私证明或硬件验证。 不用真实图片做校准确实减少了这一步的数据访问需求,但论文未给出正式隐私保证;计算量估算也无法替代设备上的速度测试。
D4C 的贡献可以归结为一个具体的方法选择:用 CLIP 的文本分支指导合成图片的语义,再用前景与背景对比和随机扰动改善校准样本。实验支持它成为本文设置下更有效的 DFQ 方法;要得到可靠的部署方案,还需同时解决敏感层量化、目标任务评估与硬件执行问题。
来源与配图说明
本文依据 Wenlun Zhang 等人的 D4C v2 论文及官方代码仓库撰写。实验表格为原文数据的节选和重排,“提升”列按原始准确率计算。
正文四幅配图均来自上述作者的原论文图 1–4,依 CC BY 4.0 使用,仅裁去周围正文与图注并转为 WebP,图内内容未修改;中文图注和讲解为本文补充。封面为本站绘制的概念示意图。本文发布时间为 2026 年 10 月 3 日,实验与实现结论以所引用版本为准。
See also
- DVD-Quant 论文解读:无需校准数据的视频 DiT 低比特量化 2026-10-05
- P4Q 论文解读:用提示学习和低位宽适配器修复 CLIP 的图文对齐 2026-10-05
- 一次完整的 WSL2 安装排障:从 BIOS、TPM 判断到 Windows 11 修复安装 2026-07-07
- 把一个 SPA 博客补成可预渲染、可同步、可持续部署 2026-05-29
- 把宿舍 Windows 主机改成可远程训练的 WSL 工作站 2026-05-27