遮挡感知 6D 位姿估计论文解读:深度引导图编码与跨语义融合如何服务机器人抓取
机器人抓取需要的不只是“物体在哪”,而是完整的 6D 位姿:三维位置 + 三维朝向。遮挡是这条链路最现实的失败模式:目标被其他物体挡住一部分,关键点缺失、轮廓不完整,位姿就容易漂。ICRA 2025 的这篇工作没有直接回归 ,而是把问题拆成两件事:用深度引导的图建模表面点之间的关系,用 mask 和二进制码两种语义建立 2D-3D 对应,最后用 PnP 解位姿。
本文按“动机—方法—实验—边界”展开。图片截取自原论文,版权归原作者与 IEEE;图 2 的编号标注与图 4 的局部放大为本文整理,仅用于学习解读。实验数字来自作者报告,未经独立复现。
论文信息与关键术语
| 项目 | 信息 |
|---|---|
| 论文题目 | Occlusion-aware 6D Pose Estimation with Depth-guided Graph Encoding and Cross-semantic Fusion for Robotic Grasping |
| 作者 | Jingyang Liu、Zhenyu Lu、Lu Chen、Jing Yang、Chenguang Yang |
| 发表信息 | 2025 IEEE International Conference on Robotics and Automation(ICRA),Atlanta,2025-05-19~23,pp. 5011–5016 |
| DOI | 10.1109/ICRA55743.2025.11128248 |
| 任务 | 从单帧 RGB-D 估计已知物体的 6D 位姿,面向机器人抓取 |
| 数据 | LMO(LINEMOD-Occluded)、YCBV(YCB-Video);真实 RealSense + UR5e 场景 |
| 指标 | ADD(-S) recall;平均处理时间 |
| 对比方法 | GDR-Net、SO-Pose、ZebraPose、PR-GCN、FFB6D、SegDriven |
| 关键组件 | depth-guided graph、mask、binary code、PnP |
| 术语 | 含义 | 在本文中的作用 |
|---|---|---|
| 6D 位姿 | 3D 位置 + 3D 朝向,通常写成 | 机器人抓取的输出 |
| RGB-D | 彩色图 + 深度图 | 外观 + 几何 |
| CAD keypoint | CAD 模型上的 3D 点 | 二进制码的身份锚点 |
| Binary code | 每个关键点一个 位 0/1 码 | 逐像素预测,匹配 2D-3D |
| Mask | 可见区域的前景概率 | 区域先验,过滤背景/遮挡物 |
| GNN | 图神经网络 | 建模表面点之间的关系 |
| PnP | 用 2D-3D 点对解相机位姿 | 最终 |
| ADD(-S) | 6D 位姿召回指标,对称物体用最近点距离 | 越高越好 |
动机:遮挡破坏的是“证据”和“关系”
抓取是机器人交互的基础能力,6D 位姿是视觉到抓取的关键接口。遮挡下,目标的一部分没有观测,外观和关键点证据同时缺失;如果网络只从全局 RGB 特征直接回归 ,它没有显式约束去推断被挡部分,位姿容易多解。
论文把现有方法分成四类,并逐一指出缺口:
- 模板 / 手工特征:依赖人工设计的特征和模板匹配,遇到对称物体和遮挡容易失效。
- 直接回归 / 关键点 + PnP:依赖纹理和可见关键点;遮挡下关键点投票会漂,而且很少显式建模表面点之间的非邻接关系。
- 遮挡专用技巧:amodal mask、多尺度融合、二值化卷积、隐藏特征预测等,提升了鲁棒性,但更多是把遮挡当噪声去增强特征,没有把“可见点如何约束不可见点”变成结构。
- 已有 GNN 方法:有的主要用深度,有的主要用 RGB,或者面向 LiDAR 点云;没有把 RGB 语义、深度几何、mask/code 两类语义放进一个框架。
作者的切入点是:物体表面点不是独立的,可见部分的相对几何仍然约束整体。深度提供几何,图提供关系传播,mask 和二进制码提供“哪里”和“哪个点”。
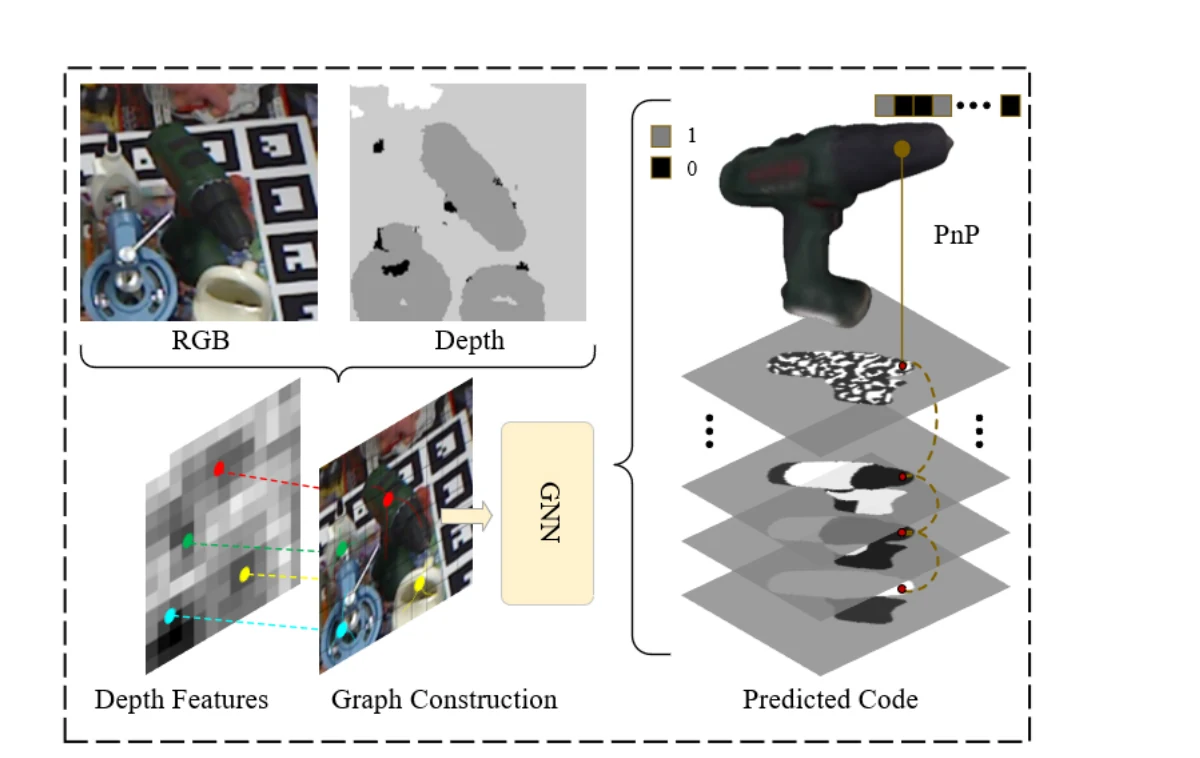
图1|论文 teaser。左边 RGB 和 Depth 都不完整;中间用深度特征参与构图,GNN 在表面点关系上传播;右边每个 CAD 关键点对应一串唯一二进制码,网络预测码图,再通过码匹配 + PnP 得到位姿。图片截取自原论文。
这张图把动机视觉化了:遮挡掉一部分并不可怕,只要可见像素还有“身份码”和“几何关系”可用。作者希望网络不是“猜”被挡部分,而是用可见部分的身份和几何去约束位姿。
方法总览:三路特征、两次融合、一个求解器
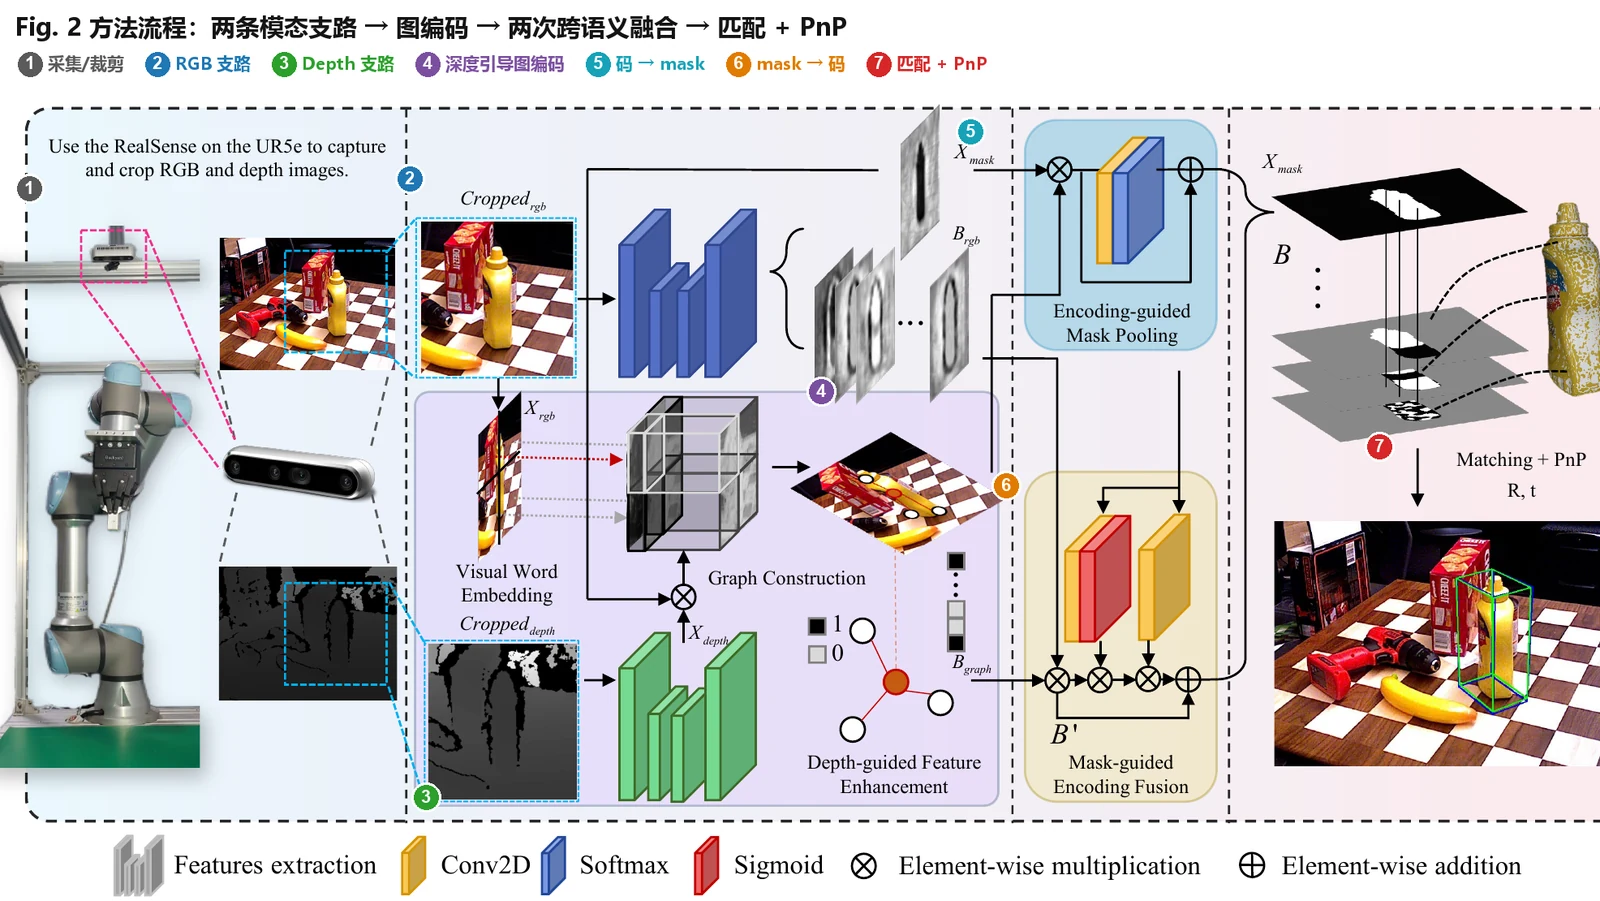
图2|方法总览。① 采集/裁剪;② RGB 支路出 mask 特征、码特征和 visual word;③ Depth 支路出几何特征;④ 深度引导图编码;⑤ 码→mask;⑥ mask→码;⑦ 匹配 + PnP。原图来自论文,编号与中文说明为本文整理。
Fig. 2 里其实有两层“分支”,先分清:
- 外层:RGB 支路 vs Depth 支路(两条模态支路)。
- RGB 支路内部:mask 支路 vs binary code 支路(两条语义支路)。
后面的图编码、两次融合、PnP 都是为这两层分支服务的。数据流可以写成:
RGB-D → 检测/裁剪
   ├─ RGB   → X_rgb(图节点)、X_mask(区域)、B_rgb(身份码)
   ├─ Depth → X_depth(几何)
   └─ X_rgb + X_depth + X_mask → 图 → B_graph(图增强码)

B_graph + B_rgb + X_mask → 两次跨语义融合 → B
B → 码本匹配 → 2D-3D 对应 → PnP → R,t
是怎么来的
一句话:RGB crop → 共享 backbone → mask head → 特征图 → 1×1 卷积 + sigmoid → 可见 mask; 监督。
- 是 mask 分支的特征图,不是最终二值 mask;最后接一个 1×1 卷积 + sigmoid,才得到 1 通道的可见 mask 概率图,阈值化后才是黑白 mask。
- 论文没有展开 mask head 的具体结构;概念上就是一个轻量分割头。
- 它是 visible mask,不是 amodal mask:瓶子被盒子挡住时,被挡部分在 mask 里是 0,不补全。
- 实验里用预训练 FCOS 提供分割结果来初始化区域提取/裁剪;FCOS 不等于 , 是姿态网络内部学的 mask 特征。
- 有两个阶段:初始版在 Eq. 1 里过滤深度;Eq. 3 用码更新后的版本,再在 Eq. 4/5 里门控码。
二进制码是怎么来的
一句话:CAD 关键点 → 每个关键点一个唯一的 位二进制码(码本);code head 从同一组 RGB 特征预测 ;图模块增强为 ;融合为 ; 与码本匹配得到 2D 位置,再和 3D 关键点做 PnP。
- 码是逐像素的 位向量;每个像素的码 = 它所属关键点的 ID。
- 码不是 mask:mask 是 1 通道前景概率;code 是 通道的“关键点身份证”。mask 回答“哪里是物体”,code 回答“是物体的哪个 3D 点”。
- 码本、关键点数量、码长 、匹配细节,论文都没有展开;这是复现时要确认的。
用分割来类比:
- mask = 二类前景分割,1 通道;
- code = K 类关键点 ID 分割,标签用 位二进制码表示, 通道,损失用 Hamming;
- mask 是所有关键点区域的并集;code 是对这个并集的划分。
- code 的 个通道是 bit plane:单独看一层没有语义,叠起来才是“哪个关键点”。
| 维度 | Mask | Code |
|---|---|---|
| 输出形式 | 1 通道前景概率 | 通道码向量 |
| 语义 | 区域/轮廓 | 关键点身份 |
| 粒度 | 物体级 | 点级 |
| 空间变化 | 物体内基本一致 | 不同位置不同 |
| 监督 | :可见 mask 的 L1 | :逐位 Hamming |
| 作用 | 筛背景/遮挡物、过滤深度、门控码 | 建立 2D-3D 对应,供 PnP |
| 遮挡下 | 只覆盖可见部分 | 可见像素仍提供关键点身份 |
深度引导图编码:把“表面点关系”变成结构
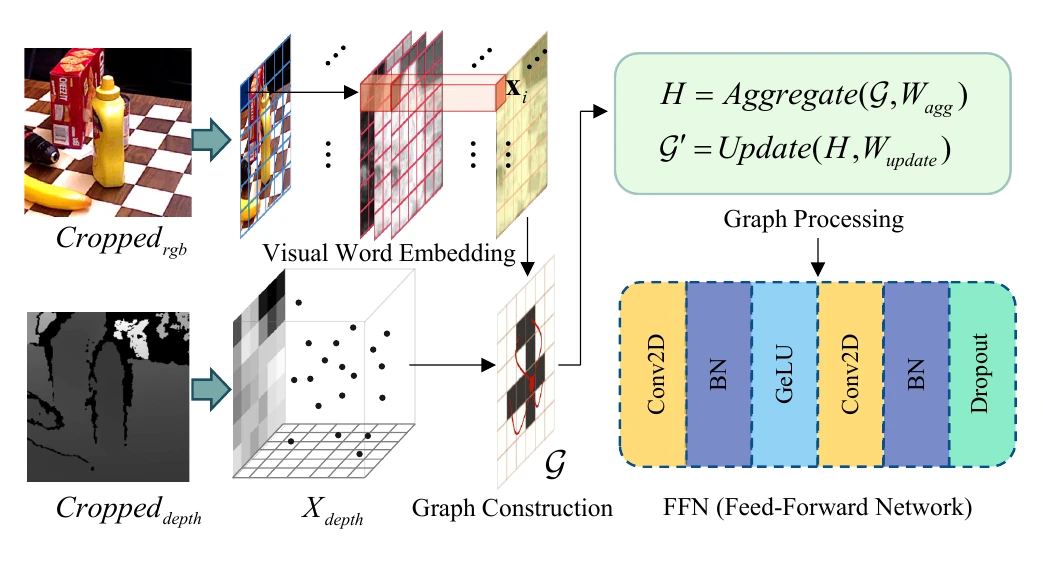
图3|图编码细节。RGB 分块作为节点,深度参与构图和节点更新,GraphConv 聚合邻居差异,FFN 防止过平滑。图片截取自原论文。
图模块解决的是“非邻接关系”。遮挡会把同一物体的可见部分在图像上分开;CNN 的局部卷积只能看邻域,图可以把空间上不相邻、但属于同一物体的块连起来。深度在这里的作用是让图“带几何”,而不是只按外观相似度连边。
具体做法:
- 节点:把 RGB 特征图切成 个局部块,每块压成 维向量 ,得到 ;每个 对应图节点 。这就是论文说的 visual word,类似 ViT 的 patch token,但这里是 CNN 特征块。
- 连边:对每个节点 取 个最近邻,形成有向边 ,得到稀疏图 。KNN 是前向构图步骤,不是可学习参数。
- 图卷积:对节点 ,先算它与邻居的差异,再 Aggregate/Update;用差异而不是简单求和,是为了强调相对关系。
- FFN:图卷积后接 FFN,防止深层 GNN 的过平滑,同时把节点特征映射到码空间。
对应公式:
Eq. 1 里四项的作用分别是:
- :把 RGB 节点特征投影到图空间;
- :用 mask 把深度几何限制在目标区域,作为图卷积的几何引导;
- :把图卷积输出投影回与 相同的维度,才能做残差;
- :残差保留外观信息,避免图卷积把 RGB 特征冲掉。
Eq. 2 是图 3 中 FFN 的抽象写法;图 3 给出的具体结构是 Conv2D → BN → GeLU → Conv2D → BN → Dropout。残差 的作用和 Transformer FFN 类似:保留节点差异性,防止过平滑。
参数 vs 张量:、、、、、、Conv2D 卷积核是可学习参数;、、 是前向计算出的张量; 是超参数,不是学出来的。
遮挡下的直观作用:比如瓶子中段被盒子挡住,瓶颈和瓶底还可见。CNN 的局部卷积很难直接把颈和底联系起来;如果图能把它们连起来(取决于 KNN 和深度引导),深度告诉它们的三维相对位置,GraphConv 就可以把一侧的码信息传给另一侧。这样被挡中段的码不是凭空猜,而是被可见两端的几何关系约束。
但要看清一个边界:论文动机说的是“surface points”,实现上是 RGB 局部块节点 + 深度引导,是 2D patch 图上的近似,不是真正的 3D 表面图/点云图。它更像一个“2.5D 图”:节点是外观,边/更新是几何。遮挡把可见块在 2D 上分开时,KNN 是否能把它们连起来,论文没有专门分析。
跨语义融合:先码引导 mask,再 mask 引导码
这是标题里 “cross-semantic fusion” 的核心。两个模块的方向正好相反:
| 模块 | 谁引导谁 | 公式 | 作用 |
|---|---|---|---|
| Encoding-guided Mask Pooling | 码 → mask | Eq. 3 | 用码响应找目标区域,更新 mask 特征 |
| Mask-guided Encoding Fusion | mask → 码 | Eq. 4/5 | 用 mask 可靠性筛码,残差保留信息 |
Encoding-guided Mask Pooling(Eq. 3)
分三步看:
- :码特征和 mask 特征先逐元素相乘,让码初步调制 mask。
- Conv2D + softmax:在所有像素位置 上做空间 softmax,得到一个权重图;响应越像目标的区域权重越大。
- 再乘回 :得到更新后的 mask 特征,聚焦到目标区域。
注意这里的 softmax 是空间竞争:所有像素权重和为 1,最像目标的区域会被放大;这和后面 Eq. 4/5 的 sigmoid 逐位置门控不一样。论文把它叫 “pooling”,但从公式看更像软空间注意力/软选择,不是常见的 max/avg pooling。
Mask-guided Encoding Fusion(Eq. 4/5)
- Eq. 4:先把 和 两路码逐元素相乘,做一次“码-码”融合;再乘 mask 门控,只保留目标区域的码响应。这里的 是 Eq. 3 更新后的 mask 特征。
- Eq. 5:把门控后的 mask 特征作为残差加回 ,得到最终融合码 。残差的作用是防止门控把信息完全压掉,保证 mask 信息有一条旁路。
为什么先 Eq. 3 再 Eq. 4/5? 从数据流看,作者是先用码把 mask 聚焦,再用聚焦后的 mask 去筛码;顺序不是随便的。如果先用未聚焦的 mask 去门控码,背景/遮挡物的错误会被放大。
符号复用要小心:Eq. 1 里的 是初始 mask 特征;Eq. 3 等号左边是更新后的版本;Eq. 4/5 用的是更新后的版本。论文没有换符号,读的时候要按阶段区分。
监督与位姿求解:Hamming + PnP
- :可见 mask 的 L1,只在目标区域内计算。
- : 位码的加权 Hamming 距离; 是第 位的权重,论文没有展开具体设定。
- :按 trial and error 设定;从权重看,码损失是主监督,mask 更像是辅助约束。
- 图模块和融合模块没有额外监督,它们靠 端到端训练。也就是说,图学到的“关系”是为了让码/mask 更准,而不是显式的 3D 几何监督。
最后,融合码 与 CAD 关键点码匹配,得到 2D-3D 对应点,PnP 解出 。网络不直接回归旋转和平移,几何约束留给 PnP——这也是它和“直接回归位姿”的方法在思路上的根本区别。
论文没有展开的细节:码本如何生成、码长 、关键点数量、匹配算法、外点剔除、Hamming 不可导时怎么反传、 和 的取值、backbone 结构。这些是复现时要先确认的。
实验:遮挡重时优势更明显,但平均提升有限
设置
- 数据集:LMO(LINEMOD-Occluded)和 YCBV(YCB-Video)。
- 训练:真实 + 合成数据,比例约为 1:9;RTX 3090;学习率 0.0001。
- 分割:预训练 FCOS 提供初始分割/区域提取;位姿用 PnP。
- 指标:ADD(-S) recall;平均处理时间。
主结果
| 数据集 | 本文 | 最强对比 | 说明 |
|---|---|---|---|
| LMO | 78.1 | ZebraPose 76.9 | 平均 +1.2 |
| YCBV | 82.4 | ZebraPose 80.5 | 平均 +1.9 |
论文报告的单物体提升更醒目:YCBV 的 Obj_02 从 62.6 到 95.5(+32.9),Obj_11 从 71.2 到 88.0,Obj_37 从 71.8 到 81.3;LMO 的 ape 从 57.9 到 61.1。摘要里的 “up to 30%” 指的就是这类单物体提升,不是平均值。
速度方面:本文约 279 ms/物体,比 ZebraPose 的 250 ms 慢 29 ms;比 FFB6D 的 75 ms、GDR-Net 的 65 ms 慢很多。它适合准静态抓取,不是高速动态抓取。
也要看到反例:YCBV 上 ZebraPose 在 Obj_05(80.5 vs 72.1)、Obj_07(70.5 vs 54.3)、Obj_61(99.3 vs 88.0)等物体上仍然更高;LMO 的 holepuncher,PR-GCN 97.2,本文 83.5。平均更高不等于每个物体都更好。
消融
| 配置 | LMO ADD(-S) |
|---|---|
| baseline | 76.9 |
| + Depth-guided Feature Enhancement | 77.1 |
| + Encoding/Mask-guided Module | 77.2 |
| both | 78.1 |
单独加图模块 +0.2,单独加 mask/encoding +0.3,两个一起 +1.2。增益不是简单相加,说明两者有互补/协同;但单个模块的增益很小,方法的价值集中在遮挡重的物体上。
定性结果:Fig. 4 怎么读
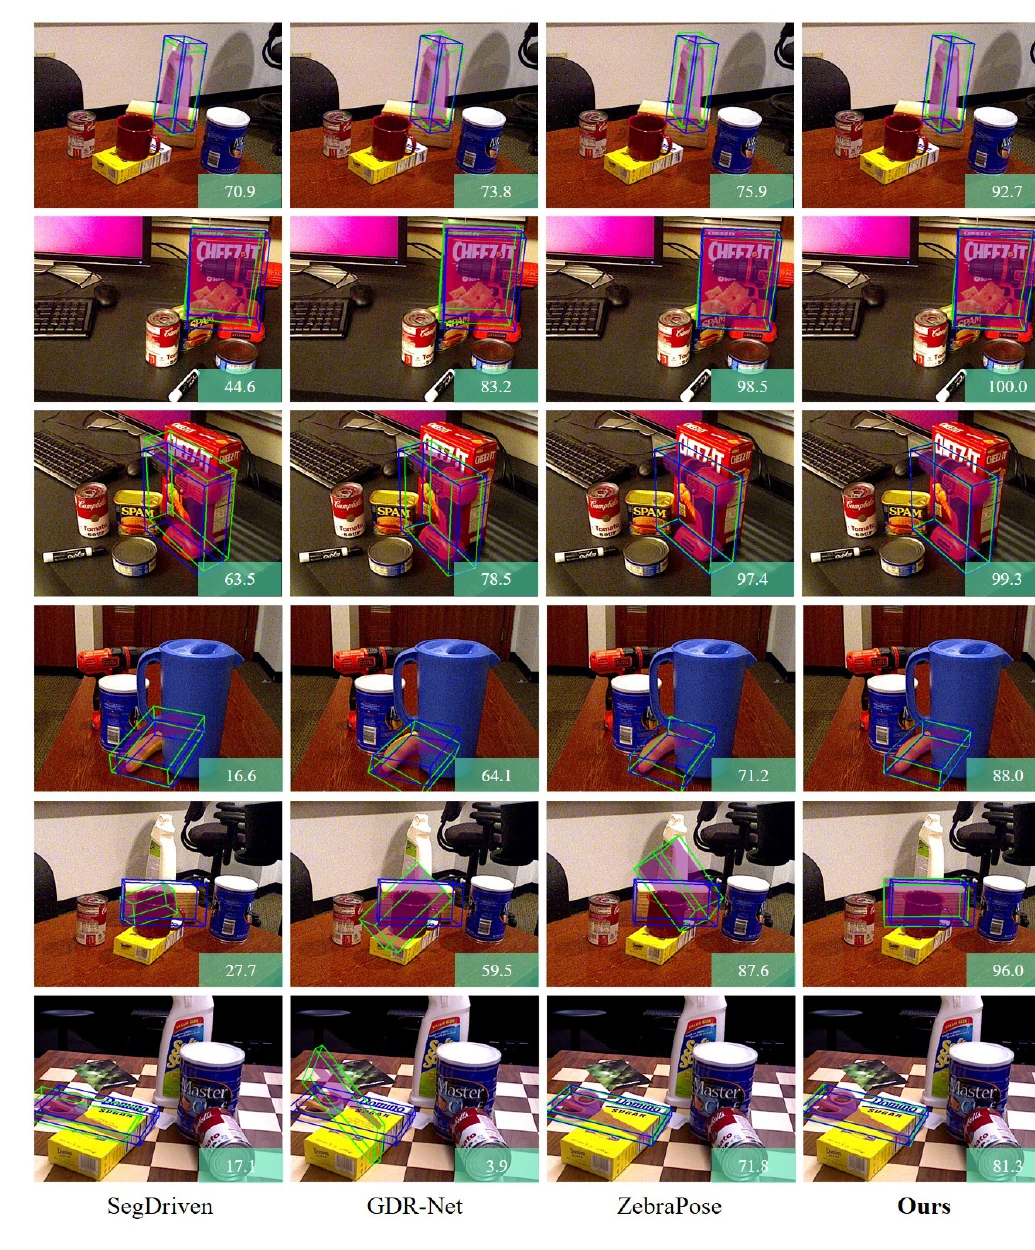
图4|YCBV 定性结果。蓝线为 GT,绿线为预测;右下角数字是该物体在 YCBV 上的平均 ADD(-S) recall,不是这一帧的分数。图片截取自原论文。
先记住三个读图规则:
- 6 行 = 6 个 YCBV 物体/示例帧;4 列 = SegDriven、GDR-Net、ZebraPose、Ours。
- 蓝框 = GT,绿框 = 预测;看两者是否重合。框是 3D bounding box,不是 2D 检测框。
- 右下角绿色数字条 = 该物体的平均 ADD(-S) recall;对照 Table II 可以一一对上。
前 3 行是中等遮挡/杂乱场景,基线也不弱;后 3 行遮挡更重,差距拉大:
- 第 4 行(芥末瓶被蓝色水壶挡住):16.6 / 64.1 / 71.2 / 88.0;SegDriven 绿框太小/偏移,GDR-Net 倾斜,ZebraPose 接近但仍偏,Ours 贴住瓶身。
- 第 5 行(紫色盒子被罐子挡住):27.7 / 59.5 / 87.6 / 96.0;Ours 与蓝框基本重合。
- 第 6 行(黄色盒子被蓝色杯子挡住):17.1 / 3.9 / 71.8 / 81.3;GDR-Net 绿框完全跑偏,Ours 最好。
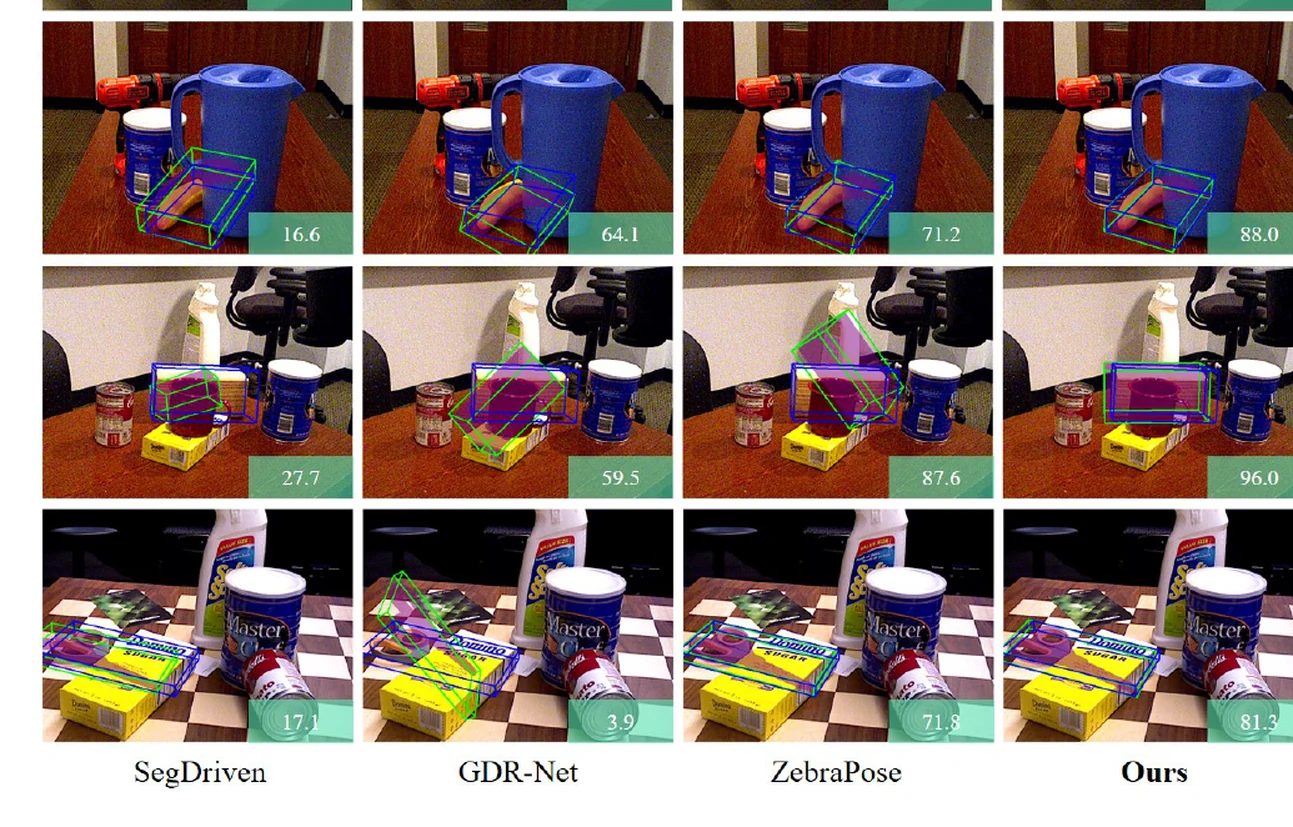
图5|Fig. 4 第 4–6 行放大,遮挡最重的三个例子。图片截取自原论文,局部放大为本文整理。
读图 caveat:这 6 行都是 Ours 最高的例子;Table II 里也有 ZebraPose 更高的物体。6 行是不同物体,不是同一物体的不同遮挡等级,不能当成受控的“遮挡梯度实验”。图是定性示例,定量结论仍看 Table II 和消融。
真实场景:Fig. 5 / Fig. 6
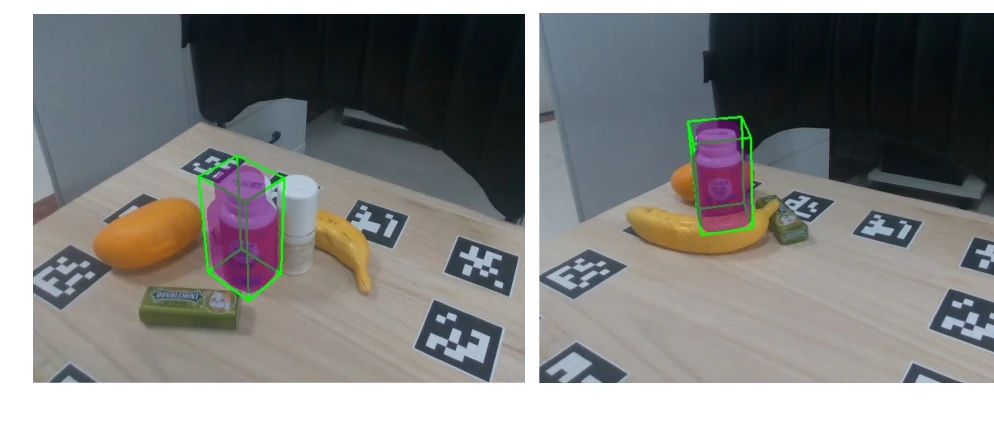
图6|真实场景位姿估计与模型渲染。绿色 3D 框为预测位姿;没有蓝框 GT,属于定性验证。图片截取自原论文。
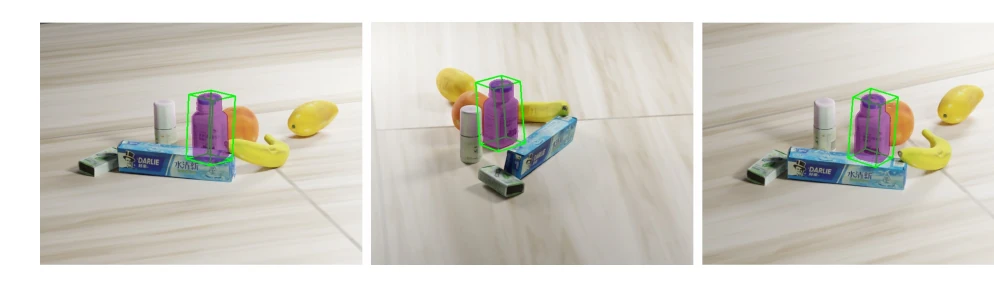
图7|自建虚拟场景的严重遮挡/重叠。图片截取自原论文。
Fig. 5 的读法:
- 真实场景:Intel RealSense + UR5e;桌上放着紫色瓶子、香蕉、罐子等杂物。
- 绿色 3D 框 = 预测位姿渲染到图像上,不是 2D 检测框;它显示位置、朝向、尺度。
- 左图瓶子较完整;右图瓶子被香蕉/杂物遮挡更多;两张图的绿框都贴住瓶子的几何轮廓。
- 没有蓝框 GT:真实场景没有 ground truth,所以这是定性验证,不是定量对比。
它证明了什么:方法不只在 LMO/YCBV 上有效,在真实 RealSense/UR5e 场景里也能跑出合理的 6D 位姿;被遮挡的瓶子,绿框仍然贴住物体。它没证明什么:只有两个典型场景,没有定量误差/成功率,没有失败案例,不是真实世界 benchmark;按方法设定,目标需要 CAD/关键点,这是已知物体的验证,不是开放世界泛化。
创新与边界:哪些是新的,哪些不是
真正的贡献
- 把“表面点关系”显式建成图:不是只加一个深度分支,而是用深度引导图,让码特征带邻域几何一致性。
- mask 和 binary code 的双向融合:码引导 mask 找关键区域,mask 门控码去掉背景/遮挡物;两个方向不是简单的 concat。
- 保留 PnP 的几何求解链:网络负责建立对应,位姿由 PnP 解,解释性比直接回归好。
- 遮挡场景的系统验证:LMO/YCBV + 真实/虚拟场景,至少把“遮挡”作为主线,而不是只报平均。
需要打折的地方
- 二进制码本身不是本文独有:ZebraPose 一类工作也用 binary code;本文的增量主要是“图增强码 + mask 门控码”,不是码本身。
- 动机是 3D 表面点,实现是 2D patch 图:节点是 RGB 局部块,深度只是引导;遮挡把可见块在 2D 上分开时,KNN 是否连通没有分析。
- mask 是 visible mask,不是 amodal:不补全被挡部分;可见关键点太少时 PnP 会欠约束。
- 依赖深度和检测/分割:透明/反光物体、深度缺失时,图的几何引导会退化;FCOS/检测误差会传导。
- 逐物体 CAD/关键点:需要 CAD 模型和码本,不是 category-level 或开放世界方法。
- 实现细节缺失:码本、、、、backbone、匹配/外点、Hamming 反传都没有展开。
- 速度 279 ms:比 ZebraPose 慢 29 ms,适合准静态抓取。
- 平均提升有限:LMO +1.2、YCBV +1.9;单物体提升大,但 Table II 里有不少物体不如 ZebraPose。
- 真实实验是定性:Fig. 5 只有两个典型场景,没有量化真实世界 benchmark。
- 输入模态不完全一致:对比方法里既有 RGB-only,也有 RGB-D/点云方法;本文用 RGB-D,深度是额外信息,读数字时要注意。
如果审稿,我会问
- 增益到底来自深度、图,还是 mask/code 融合?需要 RGB-only、RGB-D、无图、无 mask 的同架构消融。
- 图真的能把被遮挡物分开的可见块连起来吗?需要图连通性/注意力可视化,而不只是最终位姿。
- mask 质量差时性能掉多少?用 FCOS 噪声 mask 或人工扰动做鲁棒性实验。
- 深度缺失/噪声/透明物体时怎么办?论文没有覆盖。
- 码匹配的外点率、PnP 内点率、匹配失败案例是多少?这些对实际部署很关键。
结论
这篇论文的定位很清楚:不是提出一种全新的位姿表示,而是把“深度引导图 + mask/code 跨语义融合”组合成一个遮挡感知的 RGB-D 6D 位姿框架。 它的动机—设计—实验是自洽的:遮挡导致可见证据不完整,就用可见点的身份码和几何关系去约束位姿;mask 提供区域可靠性,code 提供 2D-3D 对应,graph 提供关系传播,PnP 负责几何求解。
如果把它当应用/系统论文看,它是有价值的:遮挡主线明确、LMO/YCBV 都有提升、真实机器人场景有验证、速度还能接受。
如果把它当方法论文看,它的新意有限:二进制码与 ZebraPose 同源,图是 2D patch 图,平均提升只有 1–2 个点,很多实现细节没有展开。
最值得记住的结论是:遮挡下不是“把被挡部分补出来”,而是“用可见部分的身份 + 几何关系去约束位姿”。 这也是 mask、code、graph 三个组件真正的分工。
参考来源
- Liu, J., Lu, Z., Chen, L., Yang, J., & Yang, C. (2025). Occlusion-aware 6D Pose Estimation with Depth-guided Graph Encoding and Cross-semantic Fusion for Robotic Grasping. 2025 IEEE International Conference on Robotics and Automation (ICRA), 5011–5016. DOI: 10.1109/ICRA55743.2025.11128248
- Su, Y., Saleh, M., Fetzer, T., Rambach, J., Navab, N., & Stricker, D. (2022). ZebraPose: Coarse to Fine Surface Encoding for 6DoF Object Pose Estimation. CVPR 2022.
- Guo, S., Dang, J., Wang, Y., et al. (2021). GDR-Net: Geometry-Guided Direct Regression Network for Monocular 6D Object Pose Estimation. CVPR 2021.
- He, Y., Huang, H., Fan, H., Chen, Q., & Sun, J. (2021). FFB6D: A Full Flow Bidirectional Fusion Network for 6D Pose Estimation. CVPR 2021.
- Hu, Y., Hugonot, J., Fua, P., & Salzmann, M. (2019). Segmentation-Driven 6D Object Pose Estimation. CVPR 2019.
- Hodan, T., Michel, F., Brachmann, E., et al. (2018). BOP: Benchmark for 6D Object Pose Estimation. ECCV 2018.
图片说明:图1–图4、图6–图7 截取自原论文,版权归原作者与 IEEE;图2 的编号标注、图5 的局部放大为本文整理,仅用于学习解读。
See also
- SCGATN 论文解读:用 Chebyshev 图卷积与图注意力预测海表盐度 2026-11-02
- 双路径循环框架论文解读:用光流引导预测海表温度 2026-11-01
- PCFNet 论文解读:用频域特征与物理约束预测海表温度 2026-10-28
- AutoPrune 论文解读:让 LLM 设计视觉 Token 剪枝规则 2026-10-22
- OFA-MAS 论文精读:一个通用模型,怎样为不同任务选择智能体并生成协作图 2026-10-20