BrainRiem 精读:跨医院脑网络诊断,为什么原型必须长在黎曼流形上
论文信息
论文题目:BrainRiem: Riemannian Prototype Learning for Source-Free Cross-Site Brain Network Diagnosis
作者:Kunyu Zhang(郑州大学)、Tianxiang Xu(北京大学),共同一作。
版本:arXiv:2606.29200v1 [cs.LG],2026-06-28。版式是 Springer LNCS 会议稿,正文未写接收会议。PDF 未给 GitHub;代码状态按「未公开」读。
任务设定:源自由域适应(SFDA)下的跨站点精神疾病二分类。输入是静息态 fMRI 做成的 功能连接矩阵,输出是 ASD / 正常(ABIDE)或 MDD / 健康对照(REST-meta-MDD)。训练阶段源站点有标签;适配阶段目标站点只有无标签数据,不允许再碰源数据。
先看结论
BrainRiem 要同时堵住三件事:扫描仪把疾病信号冲掉、医院之间不能交换原始脑图、功能连接矩阵并不是普通向量。作者的答案不是再训一个更大的图网络,而是 把源站点知识压成少数几张仍然合法的脑连接原型,送到目标站点当锚点。
| 组件 | 职责 | 通俗角色 |
|---|---|---|
| Log-Euclidean 参数化 | 原型永远是对称正定矩阵 | 先把矩阵摊平到切空间再平均,避免「吹肿」 |
| 双层优化 | 内层用原型训学生,外层看源验证集 | 原型要能当教材,不是聚类中心的摆设 |
| Dirichlet 能量校准 | 原型频谱对齐真实脑网络 | 别把扫描仪噪声学成疾病特征 |
| 教师一致性 + 流形邻域 | 类别可分、局部测地距离不漂 | 诊断语义和几何形状一起锁住 |
| 目标站熵最小 | 无标签目标上自信分类 | 本地模型围着锚点转,不再回传源数据 |
关键数字(Accuracy %;表内 Avg 是 全部站点 平均,不是表上那 5 列的平均):
| 设定 | BrainRiem | 最强对照 |
|---|---|---|
| ABIDE LOSO,15 站点平均 | 71.4 | StruRW 70.4,NRC 69.3 |
| REST-meta-MDD LOSO,23 站点平均 | 70.2 | StruRW 64.0,NRC 63.7 |
| NYU 重识别 Rank-1 | 3.8% | 原始 FC 100%;随机约 1.3% |
| NYU 成员推断 AUC | 0.53 | 原始 FC 0.99 |
正文写 ABIDE 单源迁移相对 StruRW「平均提升 5.8%」。Table 1 的 20 次迁移简单平均是 68.06 vs 62.86,差 5.2 个百分点。后面以表格为准。
背景:跨医院脑诊断卡在三件事上
静息态 fMRI 在测什么
人躺着不做任务,扫描仪每隔一两秒拍一张全脑。每个脑区会得到一条随时间晃动的 BOLD 信号。两个脑区如果一起涨、一起落,就认为它们「功能上连着」。把 AAL 图谱的 116 个脑区两两算相关,得到一张 的 功能连接(FC)矩阵。这一张图就是后面所有模型的输入。
自闭症(ASD)和抑郁症(MDD)的临床诊断大量依赖量表和行为观察。rs-fMRI 的承诺是:疾病会在这张连接图上留下可重复的生物学痕迹。ABIDE、REST-meta-MDD 这类多中心数据,本意就是把痕迹做稳。
第一坑:站点一换,模型就掉
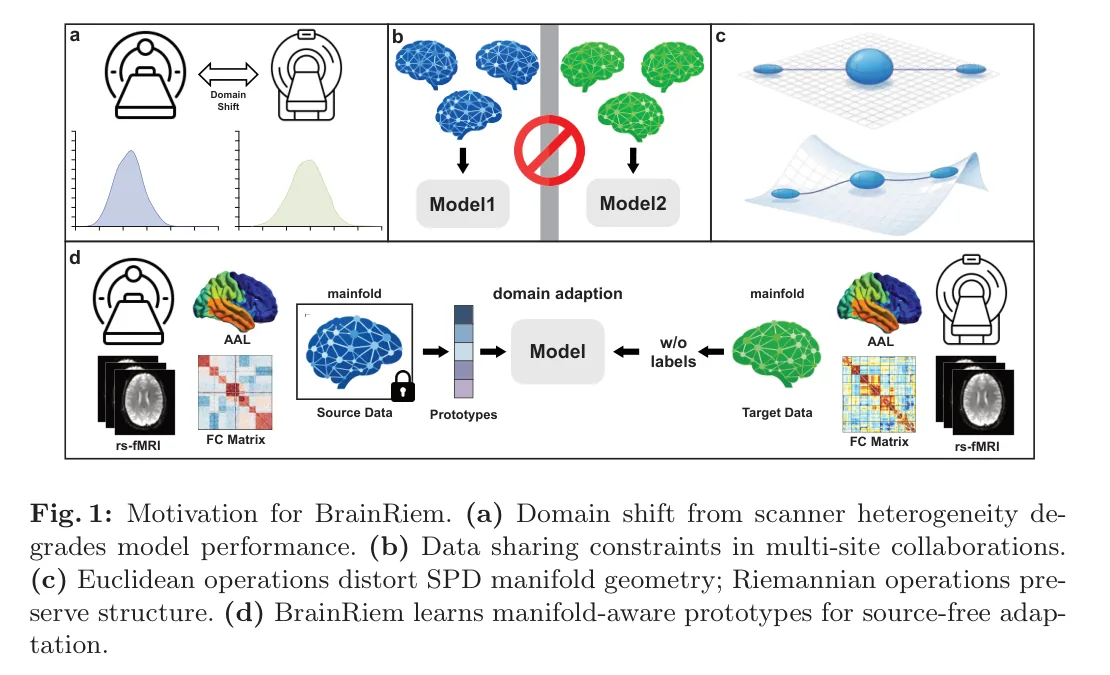
同一套疾病,Siemens / Philips / GE、场强、采集协议、年龄和性别比例都不一样。模型在 A 医院学到的「疾病样子」,到 B 医院可能一半是扫描仪指纹。这就是 域偏移。普通做法是域适应:源域和目标域数据同时拿来对齐。医院场景里这一步经常直接违法——GDPR / HIPAA 不允许把原始神经影像传来传去。
第二坑:源自由,不等于「把模型快递过去就完了」
源自由域适应(SFDA) 只允许带走:一个在源站点训好的模型,外加目标站点自己的无标签数据。SHOT、NRC、G-SFDA 这条线就是这么做的。问题是它们几乎都在欧氏特征空间里对齐。脑连接矩阵不是欧氏向量。
第三坑:FC 矩阵住在 SPD 流形上
一张合法的相关矩阵必须 对称 且 正定(所有特征值 > 0),数学上记成
这不是一块平坦的黑板,而是一块弯曲的曲面,叫 黎曼流形。在曲面上用欧氏加减,会出现经典的 swelling effect(溶胀效应):把几张瘦的协方差「平均」一下,得到的矩阵行列式被吹大,像一群瘦人的平均体重变成了一个更胖的人。生物上这张「更胖」的脑网络往往不存在。
既有工作各堵一坑:传统域适应(DANN、CORAL)要同时看到源和目标;SFDA 方法不碰源数据,但不管 SPD 几何;SPDNet、流形 GNN 管几何,却通常还要源数据。BrainRiem 的主张是三件事一起做:可迁移、仍然是合法 SPD、并且只传匿名原型。
方法:先把教材写成合法脑图,再寄到另一家医院
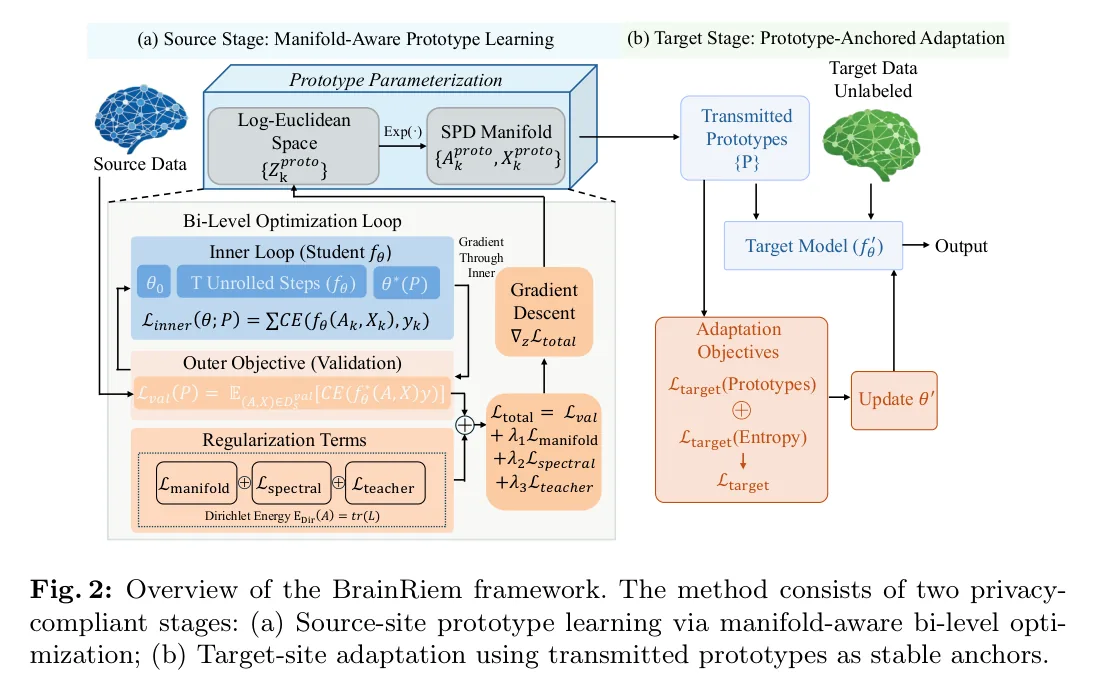
每个被试写成图 。 是 FC 矩阵, 是单位阵——节点特征就是 ROI 的身份,不另学一套节点 embedding。源阶段只在 上工作;目标阶段只有无标签 。要学的是一小撮原型
实验里每类 ,二分类就是 8 张矩阵。寄走的是这 8 张图,不是几百人的原始 fMRI。
通俗比喻:切空间里做算术,再贴回曲面
在球面上,两点的「平均」不能把三维坐标直接相加,否则平均点会掉进球里。正确做法是:把点拨到切平面上(平坦、能加减),平均完再指数映射贴回球面。
SPD 矩阵同一套戏:
把 SPD 矩阵变成对称矩阵(切空间), 再变回去。优化变量是 ,所以普通梯度下降就能用;每次 出来的 自动正定。这就是 Log-Euclidean Metric(LEM)。消融里拿掉这一步,掉点最大——几何不是装饰。
双层优化:原型必须能当教材
只做黎曼均值,得到的是「长得像平均病人」的矩阵,不一定能教会分类器。BrainRiem 把原型质量定义成:
一个 只看过原型、没看过源数据 的学生模型,在源验证集上还能分对。
内层:学生 在原型上做交叉熵,跑 步展开(一阶近似,类似 MAML / 数据集蒸馏):
外层:把这个学生拿到源验证集上打分,再加上三项正则:
梯度穿过内层更新 ,源数据本身不进入目标站点。超参网格搜完固定为 。教师项权重大,说明原型首先要像「有病 / 没病」,几何和频谱是约束而不是主任务。
Dirichlet 能量:别把高频噪声写成疾病
把 FC 看成图, 是拉普拉斯。Dirichlet 能量
这里 ,所以 。它衡量图信号有多「皱」:扫描仪伪影、运动残差往往把能量推向高频。频谱损失让每张原型的能量靠近源域期望:
通俗说:原型的「皱法」要像真脑网络,不能像一张被噪声抓皱的纸。
教师一致性与局部测地
教师损失:源模型对原型的类别预测要和原型标签一致,防止双层优化把原型漂成另一类。
流形损失:每个原型在 Log-Euclidean 距离 下找 个源样本邻居,要求精炼后的距离不要远离初始化距离 。这是在说:原型可以动,但不能把局部邻域撕开。
目标站点:锚点监督 + 熵最小
源阶段结束只寄 。目标模型 的损失是
。第一项:继续认识那 8 张教材;第二项:对无标签目标样本的预测要自信(熵小)。原型和教师模型冻结,只更新 。
实验是怎么做的
数据有多不齐
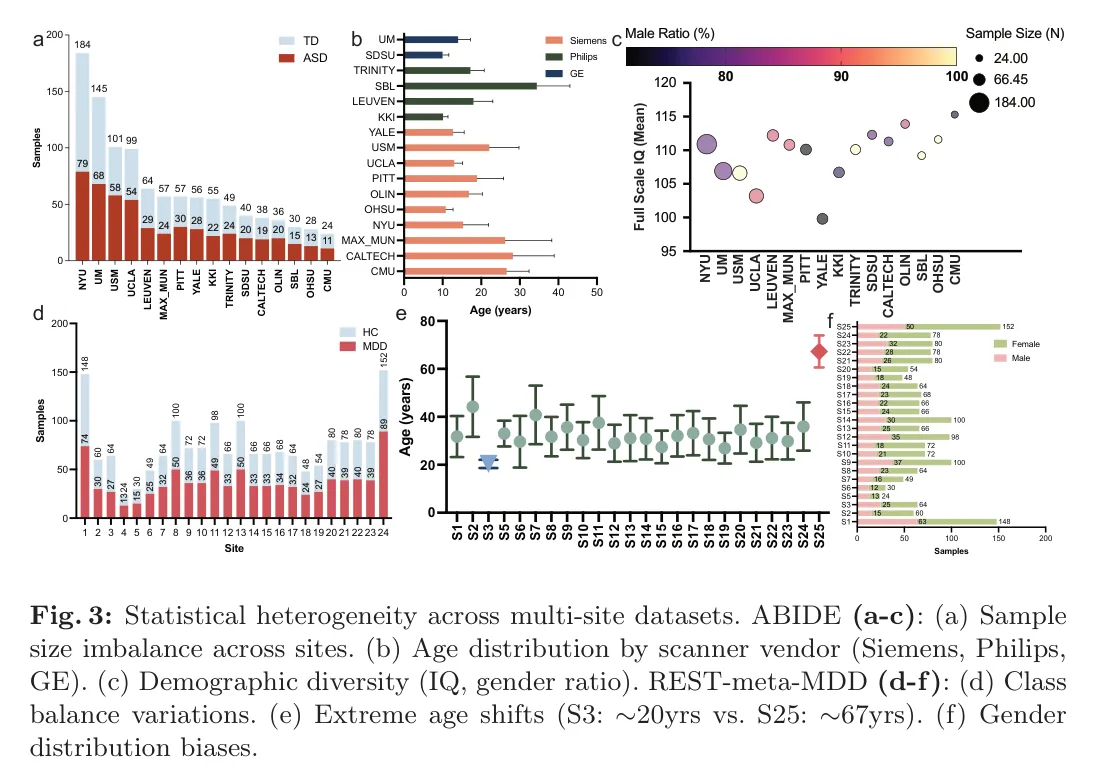
两套公开多中心 rs-fMRI:
- ABIDE:自闭症 vs 典型发育。质控后去掉 Yale(FC 文件不完整),15 个站点。NYU 最大,约 184 人;CMU 最小,约 24 人。Siemens / Philips / GE 混用。
- REST-meta-MDD:抑郁症 vs 健康对照。去掉 S20,23 个站点。S3 年龄约 20 岁,S25 约 67 岁,跨年龄迁移是这条基准的硬核。
预处理做成 FC,细节在附录 B.1。正文没有逐步列出头动阈值、滤波频段;复现要靠附录。
两种迁移,都是归纳式 SFDA
单源迁移 :选一个大站点当有标签源,逐个适配其余站点。源模型 5 折交叉验证。测的是「一家医院的数据,能不能救另一家」。
留一站点(LOSO):目标站点整站藏起来当无标签目标,其余站点合并当源,站点均衡采样。更接近「联邦式多中心已经训好,新医院加入」。
硬约束:
- 被试级划分,训练 / 适配 / 测试不相交;
- 超参 只在源域验证集上选一次,对所有目标站点锁定;
- 不用目标标签、不做目标站点模型选择。
这是归纳式 SFDA,不是把目标无标签数据泄漏进选模型。
实现细节
PyTorch,8 张 RTX 4090。骨干是 GIN(图同构网络),不是 BrainGNN 本体。Adam,,weight decay ,100 epoch,batch 64。每类 4 个原型。所有基线用官方实现并在本数据上调参。
对照分五类:
| 类别 | 方法 | 适配时能否看源数据 |
|---|---|---|
| 源自由 DA | SHOT、NRC、3C-GAN、G-SFDA | 否 |
| 传统 DA | DANN、CORAL | 是 |
| 图 DA | UDA-GCN、StruRW | 是 |
| 仅源域 | SPDNet、SPD-GNN、BrainGNN、A-GCL | 不适配 |
公平性上有两点要分开看:DANN / StruRW 比 BrainRiem 多看到源数据,仍被超过,这是加分;SPDNet / SPD-GNN 在 MDD 上接近随机,它们是「不管域偏移的流形网络」,不是最强流形 SFDA。另外,基线表把 SPDNet 标成参考文献 [13],而 [13] 是 Grassmann 网络、[12] 才是 SPDNet,引用串了。3C-GAN 原文是疟疾图像 CycleGAN,当作通用 SFDA 基线,说服力弱于 SHOT / NRC。
主结果:数字以表为准
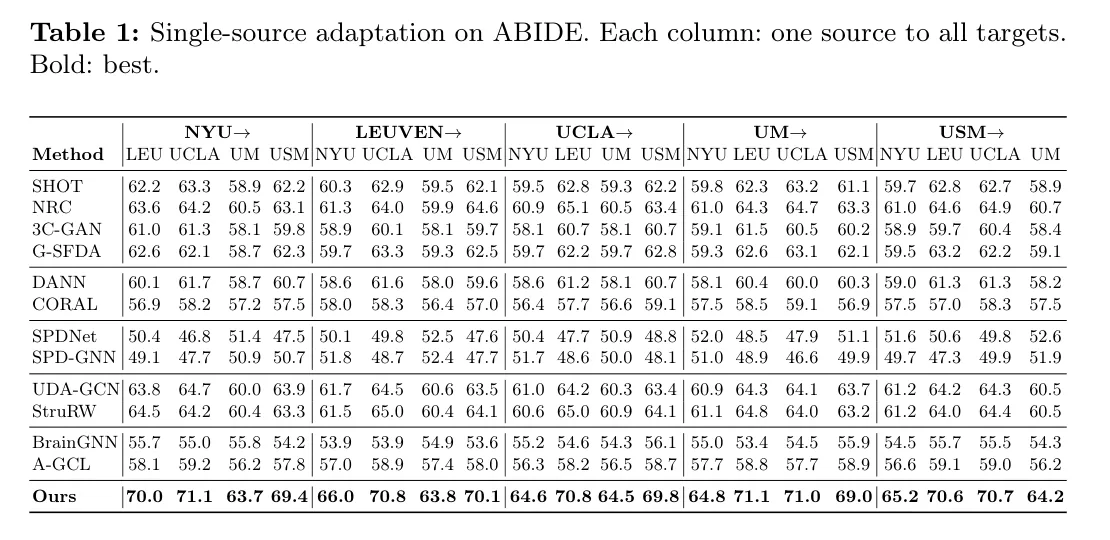
Table 1 共 20 次迁移,BrainRiem 全部加粗。20 次简单平均 68.06,StruRW 62.86(差 5.2 个百分点),NRC 更低一档。UM 作为目标普遍最难(Ours 也只有 63.7–64.5),说明几何原型不是万能钥匙,站点本身的可分性仍在。
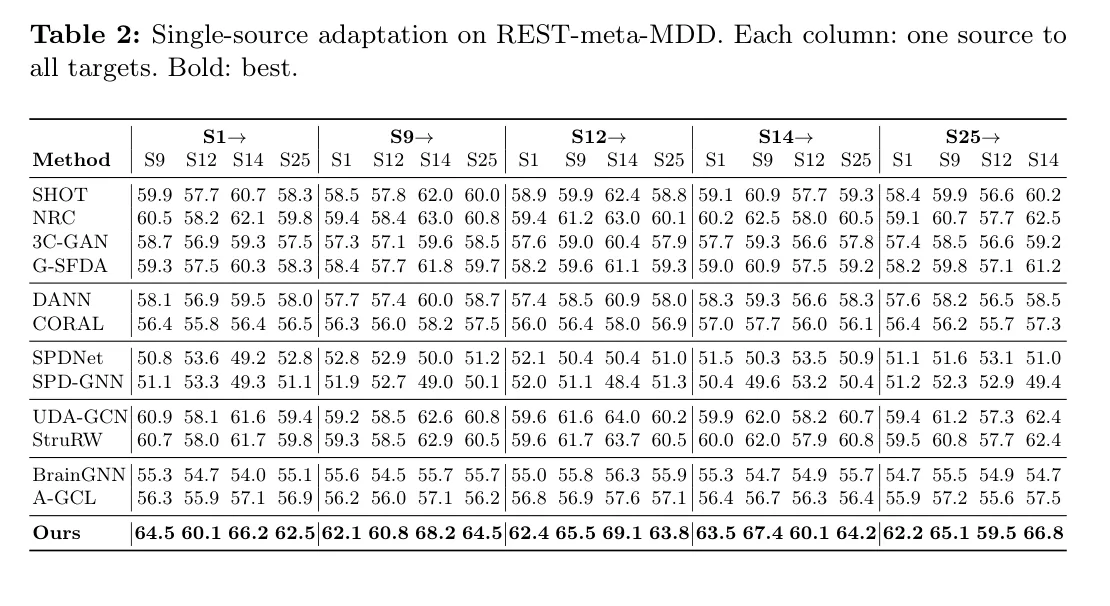
Table 2 同样 20/20 最优。简单平均 63.93 vs StruRW 60.40(差 3.5 个百分点)。正文举的跨年龄例子 S25→S14:66.8 vs 62.4,和表一致。抑郁症单源比自闭症更难,绝对准确率低一截,符合多中心 MDD 的既有印象。
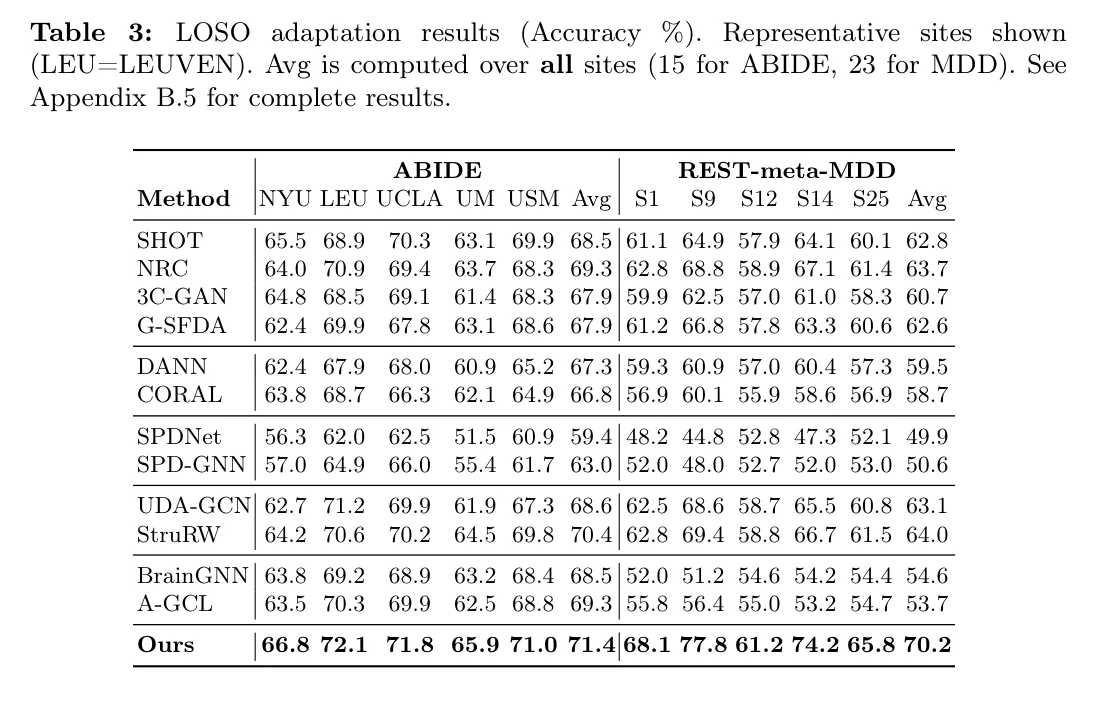
Table 3 展示 5 个代表站点,Avg 明确写了按全部站点计算:
| NYU | LEU | UCLA | UM | USM | Avg(15) | S1 | S9 | S12 | S14 | S25 | Avg(23) | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| NRC | 64.0 | 70.9 | 69.4 | 63.7 | 68.3 | 69.3 | 62.8 | 68.8 | 58.9 | 67.1 | 61.4 | 63.7 |
| StruRW | 64.2 | 70.6 | 70.2 | 64.5 | 69.8 | 70.4 | 62.8 | 69.4 | 58.8 | 66.7 | 61.5 | 64.0 |
| Ours | 66.8 | 72.1 | 71.8 | 65.9 | 71.0 | 71.4 | 68.1 | 77.8 | 61.2 | 74.2 | 65.8 | 70.2 |
ABIDE 上 5 列平均是 69.52,全文平均 71.4——没展示的 10 个站点把均值拉高了。MDD 上 5 列平均 69.42,全文 70.2,方向相同。MDD 相对 StruRW 的 +6.2 个百分点,比 ABIDE 的 +1.0 显眼得多;S9 77.8、S14 74.2 是极端人口统计站点上的高峰。S12 只有 61.2,仍然难。完整 15+23 列在附录 B.5,正文看不见每一站。
消融:几何是主因,初始化不能乱
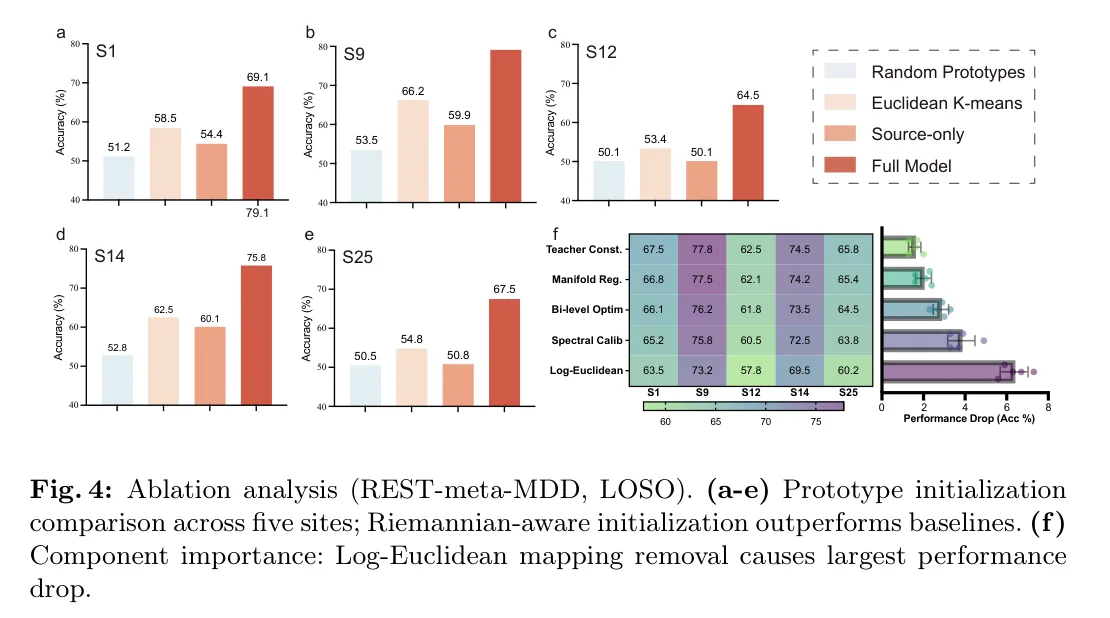
(a–e) 四根柱:随机原型约 50%(等于瞎猜);欧氏 K-means 好一些,但仍当脑网络是向量;Source-only 直接搬源模型,被域偏移咬一口;Full Model 最高。
(f) 热图从上到下是去掉该项之后的准确率,右侧是掉点。去掉 Log-Euclidean 掉得最多。正文写「约 5.7%」;把 Full 近似成 Teacher 行、Log-Euclidean 行相减,五站掉点是 4.0 / 4.6 / 4.7 / 5.0 / 5.6,平均约 4.8 个百分点。数量级一致,精确值以热图为准。
频谱校准、流形正则次之,教师项和双层优化掉点更小。因果链是:
没有合法 SPD 原型 → 后面所有损失都在错的空间里优化
有 SPD 但频谱不齐 → 扫描仪高频混进疾病
频谱齐了但没有双层/教师 → 原型不像教材
有一处要对齐:图 4(a–e) 的 Full Model 柱(S1 69.1、S12 64.5、S14 75.8、S25 67.5)和 Table 3 同行(68.1、61.2、74.2、65.8)并不逐格相同。S9 热图 77.8 与 Table 3 一致。主文 LOSO 以 Table 3 为准,图 4 只承担「谁被拿掉更痛」。
超参:每类 4 个原型就够
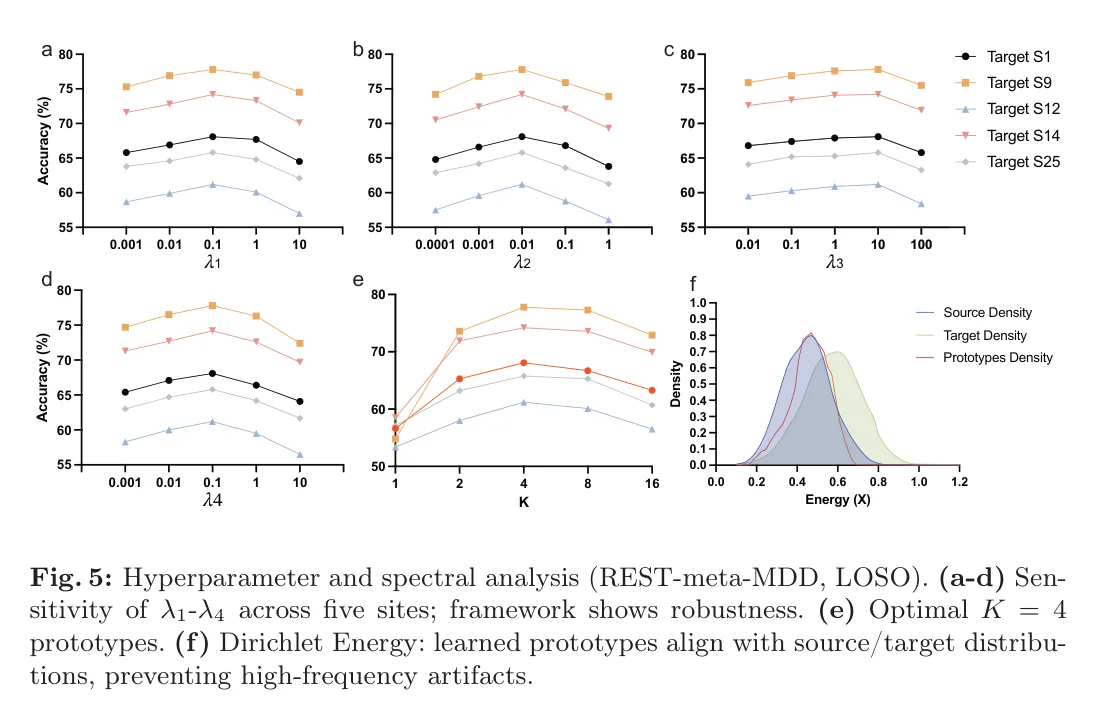
:太少盖不住类内多样性,太大开始拟合站点噪声。作者选 。四个 λ 在一个数量级内都还稳;目标熵 过大时准确率掉得更明显——无标签熵最小是辅助项,不是主损失。
图 5(f) 是频谱校准的直观证据:目标域 Dirichlet 能量往高频挪,原型密度仍贴着源域。作者把它解释成几何低通:留下诊断模式,抹掉个体指纹。
隐私:评的是两种攻击,不是差分隐私
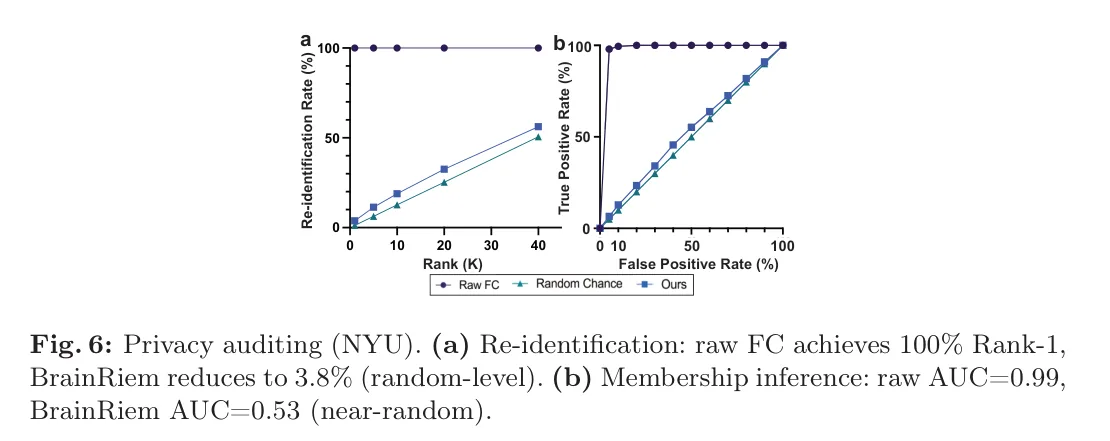
协议:NYU 对半切,做重识别和成员推断(附录 B.4)。原始 FC 几乎是指纹,Rank-1 100%、MIA AUC 0.99。原型把 Rank-1 压到 3.8%、AUC 0.53。随机猜测 Rank-1 约 ,3.8% 仍高于随机约三倍,所以正文措辞是 「在所评估的攻击下降低泄漏」,不是「不可识别」或 -DP。
传输量也小:每任务 张矩阵。这是工程上的隐私,不是密码学保证。
原型长什么样
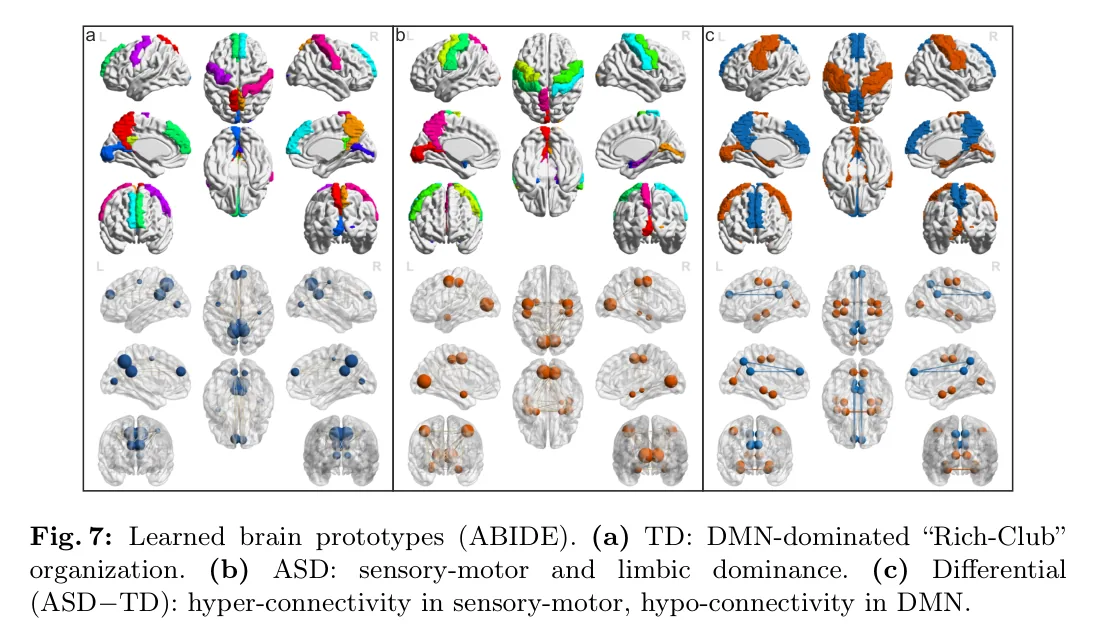
可视化用的是 Log-Euclidean 均值
不是把矩阵当数组加起来。TD 原型呈现默认网络(DMN)主导的 Rich-Club;ASD 原型转向感觉运动和边缘系统,和「感觉主导」假说同向;差分图是感觉运动环路高连接、DMN 低连接,对应「DMN 欠连接」文献。这是事后解释,不是独立的临床验证:颜色和边是学出来的连接,不是神经外科刺激证实的因果边。
局限与讨论
- 摘要 / 正文的 5.8% 和 Table 1 对不上。 20 次 ABIDE 单源对 StruRW 的简单平均差是 5.2 个百分点。LOSO 上 ABIDE 相对 StruRW 只有 +1.0(71.4 vs 70.4),真正拉开的是 MDD 的 +6.2。不能把「全面大幅超过图域适应」读成 ABIDE LOSO 的故事。
- Table 3 的 Avg 不是展示列的平均。 5 个 ABIDE 代表站点平均 69.52,全文 71.4。没展示的站点在拉高均值;S12 仍只有 61.2。完整表在附录。
- 消融图和主表同一站点数字不完全重合。 图 4 Full Model 柱与 Table 3 差 1–3 个百分点;正文「去掉 LEM 约 5.7%」与热图平均掉点约 4.8 也不锁死。主结论「LEM 最痛」成立,精确百分点不要混用两张图。
- 隐私不是差分隐私。 Rank-1 3.8% 仍高于 。没有 预算,也没有模型反演、梯度泄漏。换一种攻击,结论需要重测。
- 质控去掉了 Yale 和 S20。 原因是 FC 文件不完整。这是存储问题,但少掉的站点无法确认是不是最难的那一档。
- 、静态 116 区 AAL。 节点没有 BOLD 时间序列特征,也没有动态 FC。结论里作者自己列了多尺度图谱、动态连接、开集亚型,等于承认当前设定偏静态、偏图谱绑定。
- 无代码、会议未落地。 双层展开步数 、邻域 、预处理频段都以附录为准;基线里 SPDNet 引用编号和 3C-GAN 任务来源都不干净。数字可以读,流水线暂时不能一键复现。
- 准确率绝对值仍在辅助诊断区间。 70% 左右的跨站点二分类,离临床可用还有距离。方法贡献在「源自由 + 几何」这个组合,不在「已经能替量表」。
总结
BrainRiem 可迁移的顺序是:问题约束 > SPD 几何 > 能当教材的原型 > 少传数据。跨医院 rs-fMRI 的失败模式,经常不是 GNN 不够深,而是:(1) 欧氏平均把正定矩阵吹肿;(2) 对齐分布需要源数据,医院给不了;(3) 扫描仪高频被当成疾病。Log-Euclidean 负责合法性,双层优化负责「寄出去的矩阵真能教人」,Dirichlet 能量负责别学噪声,目标站熵最小负责本地适应。ABIDE LOSO 相对最强图域适应只高 1 个点,MDD 上高 6 个点——读结果时按数据集拆,不要被摘要的「consistently outperforms」抹平。隐私审计证明的是「这两种攻击下原型不像指纹」,不是形式化保密。没有代码之前,这篇更适合当 流形 SFDA 的问题定义和实验协议 来用,而不是当可部署的诊断软件。
See also
- TEIE-RAG 精读:工程信息抽取的可信度,先从分块别把方案名切丢 2026-09-20
- VAST 精读:CLIP 持续学习里,视觉分支为什么忘得比文本快 2026-09-11
- StyCona 精读:SVD 把域偏移拆成风格与内容,数据增强各打各的 2026-09-04
- PHFNet 精读:全阶段并行 CNN–Transformer,线性注意力里把弱红外目标补回来 2026-09-03
- GLCNet 精读:小波打散相干斑,全局-局部协作做真实 SAR 去斑 2026-09-02