TEIE-RAG 精读:工程信息抽取的可信度,先从分块别把方案名切丢
论文信息
论文题目:Toward trustworthy engineering information extraction using retrieval-augmented generation
作者:Jie Shen(通讯)、Hongyan Zhu、Binbin Zhang;电子科技大学计算机科学与工程学院。
来源:Knowledge-Based Systems 348 (2026) 116418。2026-02-22 投稿,2026-05-19 修回,2026-06-07 接收,2026-06-11 在线。DOI:10.1016/j.knosys.2026.116418。数据声明为 available on request,正文未给 GitHub。
任务设定:工程信息抽取(EIE)——从水电工程可研/设计文档里抽出工程特征变量(ECV:装机容量、库容、设计洪水、厂房坝段宽度等),要求数字可追溯、冲突可暴露,而不是聊天式问答。
先看结论
TEIE-RAG 解决的不是「再换一个更强的 LLM」,而是工程文档里一组会直接毁掉信任的现象:同一特征量在不同章节、不同方案、不同精度和单位下反复出现;普通分块一旦切掉方案名或上下游位置,模型会一本正经地抽出邻方案的数字。
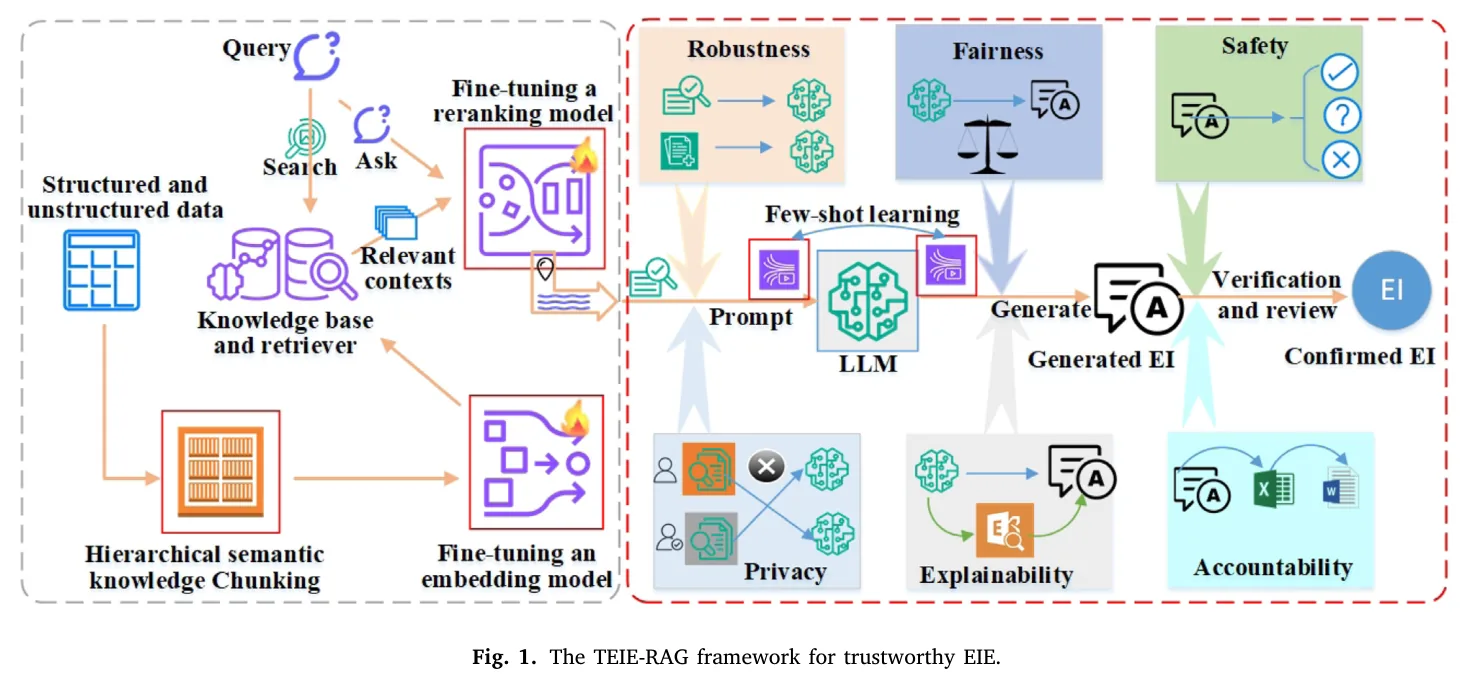
方法把可信度拆成 RAG 三阶段上的六维,核心可落地的动作其实只有四件:
| 组件 | 职责 | 通俗角色 |
|---|---|---|
| 层次语义分块 | 把标题树路径写入每个 chunk 再做 embedding | 给每段话贴上门牌:方案 / 章节 / 条目 |
| Hard-negative LoRA | 微调 BGE-M3 与 BGE-Reranker-Large | 专门学「长得很像但答案不对」的段落 |
| 自适应 few-shot | 用高忠实度样本当同类题示范 | 先看做过的同名变量,再按格式填表 |
| 溯源核对 | 同时挂出支持段落与冲突段落 | 不只给数字,把卷宗摊开给人审 |
关键数字(水电合作方文档;生成用本地 Qwen2.5-72B,评价用 Qwen3-32B):
| 指标 | 数字 | 对照 |
|---|---|---|
| 8 文档自适应 few-shot 平均抽取准确率 | 93.10% | 无示例 88.71%,固定示例 90.18% |
| 重排序平均召回 | 96.23% | 未微调 90.19%;标准差 6.18% → 3.65% |
| 人工植入错误的识别率 | 92.31%(36/39) | Embedding@top-60 召回 100% |
| 单变量平均抽取时延 | 3.5 s | 部署目标 ≤ 5 s |
有两处需要把摘要和表格分开看:摘要写的「93.10% Top-5 extraction accuracy」在实验里对应的是 few-shot 生成准确率,Top-5 是重排序覆盖答案的口径;Table 3 的 96% 是另一套协议(一份完整中文工程文档、100 个变量、对比在线模型),不能和 93.10% 混成「全面 SOTA」。细节放在局限一节。
背景:工程抽取为什么不能直接喂给大模型
水电项目文档动辄上千页,拆成综合说明、枢纽布置、机电金属结构、投资估算等分册,不同专业写同一特征量时用词、精度、单位都不对齐。系统要同时做到两件事:把值抽对,以及把不一致找出来。
既有路线三条,各自卡在工程场景里:
- 规则 / 稀疏检索(BM25、SPLADE、合同毒条款规则):匹配快,但吃不了长文本同义与「 对应 200 年一遇」这类领域写法。
- 深度学习抽取(BiLSTM-CRF、BERT QA):能建模上下文,但长文档并行与长程依赖仍差,扩展到整套可研成本高。
- 直接生成或裸 RAG:LLM 有格式鲁棒性,却会幻觉、lost-in-the-middle;RAG 虽能外挂知识,却把新风险引进来——分块切断语义、通用 embedding 分不清邻方案、生成对高频错误值过拟合、输出无法回溯。
可信度在文中按六维展开:稳健、隐私、公平、可解释、安全、可问责。TEIE-RAG 的主张是:这六维要嵌进检索—生成—复核三条流水线,而不是事后加一个引用脚注。
方法:先把门牌贴上,再让检索会打架,最后把卷宗钉在数字上
稳健之一:层次语义分块——别把「15 MW 方案」切丢
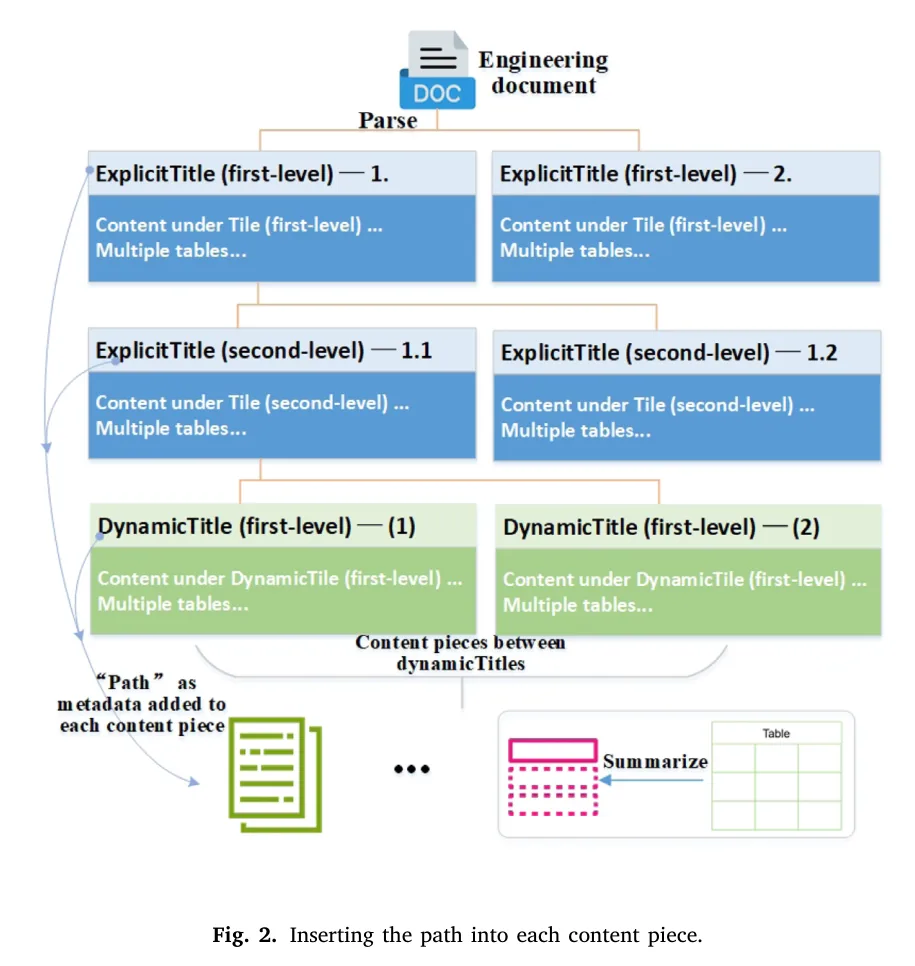
普通固定窗、递归、语义切分都是局部的。工程文档里最致命的失败不是词没匹配上,而是 两段几乎一样、只有数字不同 的方案对照:chunk 里如果没有方案名,LLM 往往从 prompt 开头或结尾抄一个看起来更眼熟的值。
DOCX 被看成元素序列(标题、段落、表)。算法分两层标题:样式里的 ExplicitTitle,以及正文里其实是标题的 DynamicTitle(如 (1) XX)。栈维护当前路径,非标题元素继承最近标题路径。随后按规则成块:
- 不足 512 字符则向后合并,滑窗重叠 20%;
- 遇到标题或完整表就新开一块,表不被拆;
- chunk 不跨标题;
- embedding 的对象是
path + chunk_content,不是裸正文。
通俗比喻:检索看的不是一段孤立摘录,而是「第 X 章 / 15 MW 方案 / (2) 引水渠」这张门牌 + 正文。门牌进向量,邻方案才分得开。
稳健之二:难负样本微调——检索要会认「长得像但答案不对」
通用 BGE-M3 / BGE-Reranker-Large 在网页语料上够用,对工程查询风格不够。TEIE-RAG 用 LoRA 改密集层 ,只训 (),推理不增加延迟:
Embedding 用 batch 内多重负例排序(MNR)损失:一条 query 一个正例,同 batch 其余当负例。Reranker 把 query–chunk 相关性当成二分类,用 BCEWithLogitsLoss。
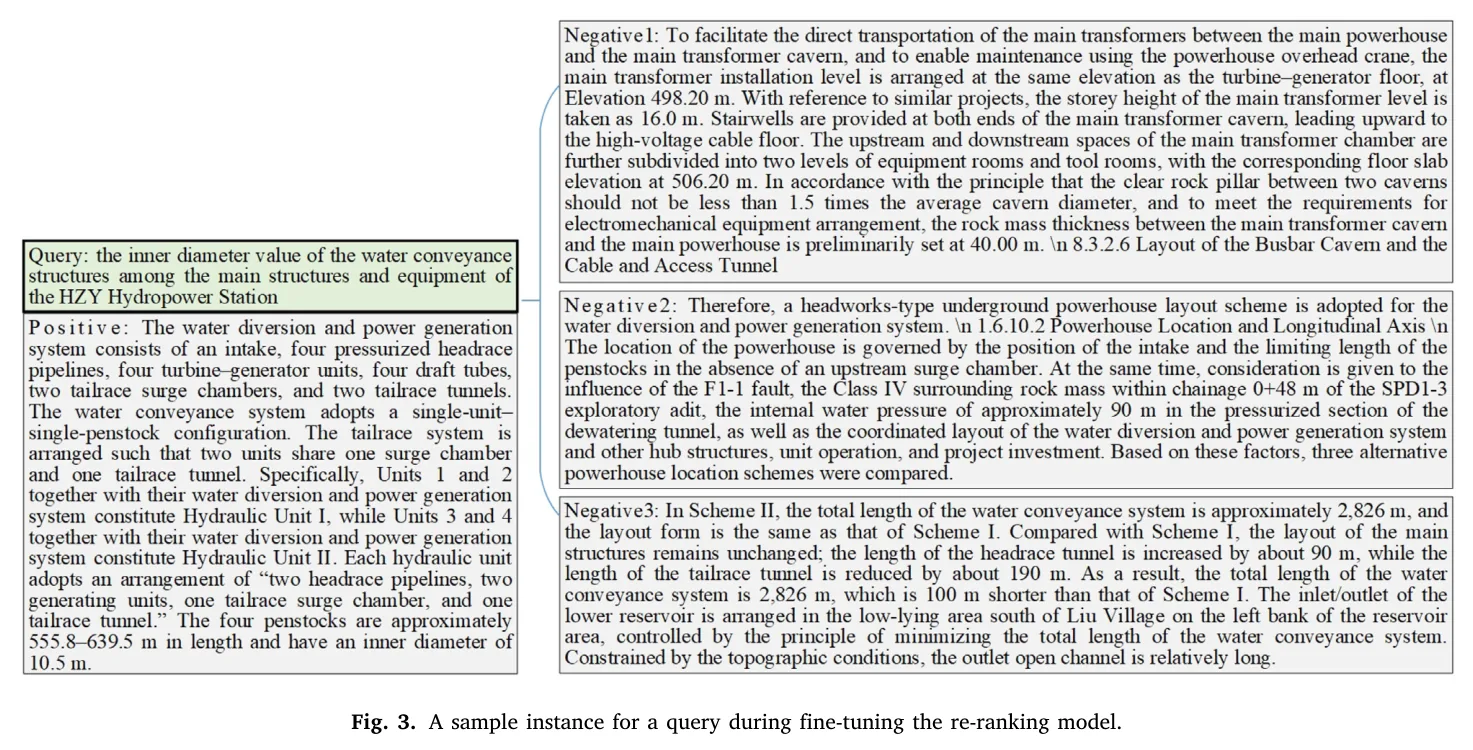
真正起作用的是 难负例怎么挖:正例是「排序后含正确答案的最高 chunk」;负例不是随机段落,而是同一来源或语义相近、排序在 3–100 名里再抽 3 条——句子像,答案差得远。
两阶段 embedding:先 LoRA rank 128、PiSSA 初始化,lr 、bs 12、4 epoch,把覆盖 0.99 召回所需的 从 TOP-100 压到 TOP-35;再用教师模型从 TOP-30 挖难负例,bs 24、lr 、1 epoch。部署取 TOP-60 召回,给泛化留余量。Reranker 在微调后的 embedding 排序结果上构造正负例,更贴近真实 chunk 粒度。
公平与生成:自适应 few-shot,而不是改 LLM 权重
工程文档里错误值往往 出现次数更多(),检索窗里错误证据局部占优,后验会被频率抬偏。TEIE-RAG 不靠改生成模型参数来纠偏——企业文档不能进外网、也不能拿用户语料继续训 LLM——而是用 与当前变量同类的问答示范 把输出钉在给定上下文上。
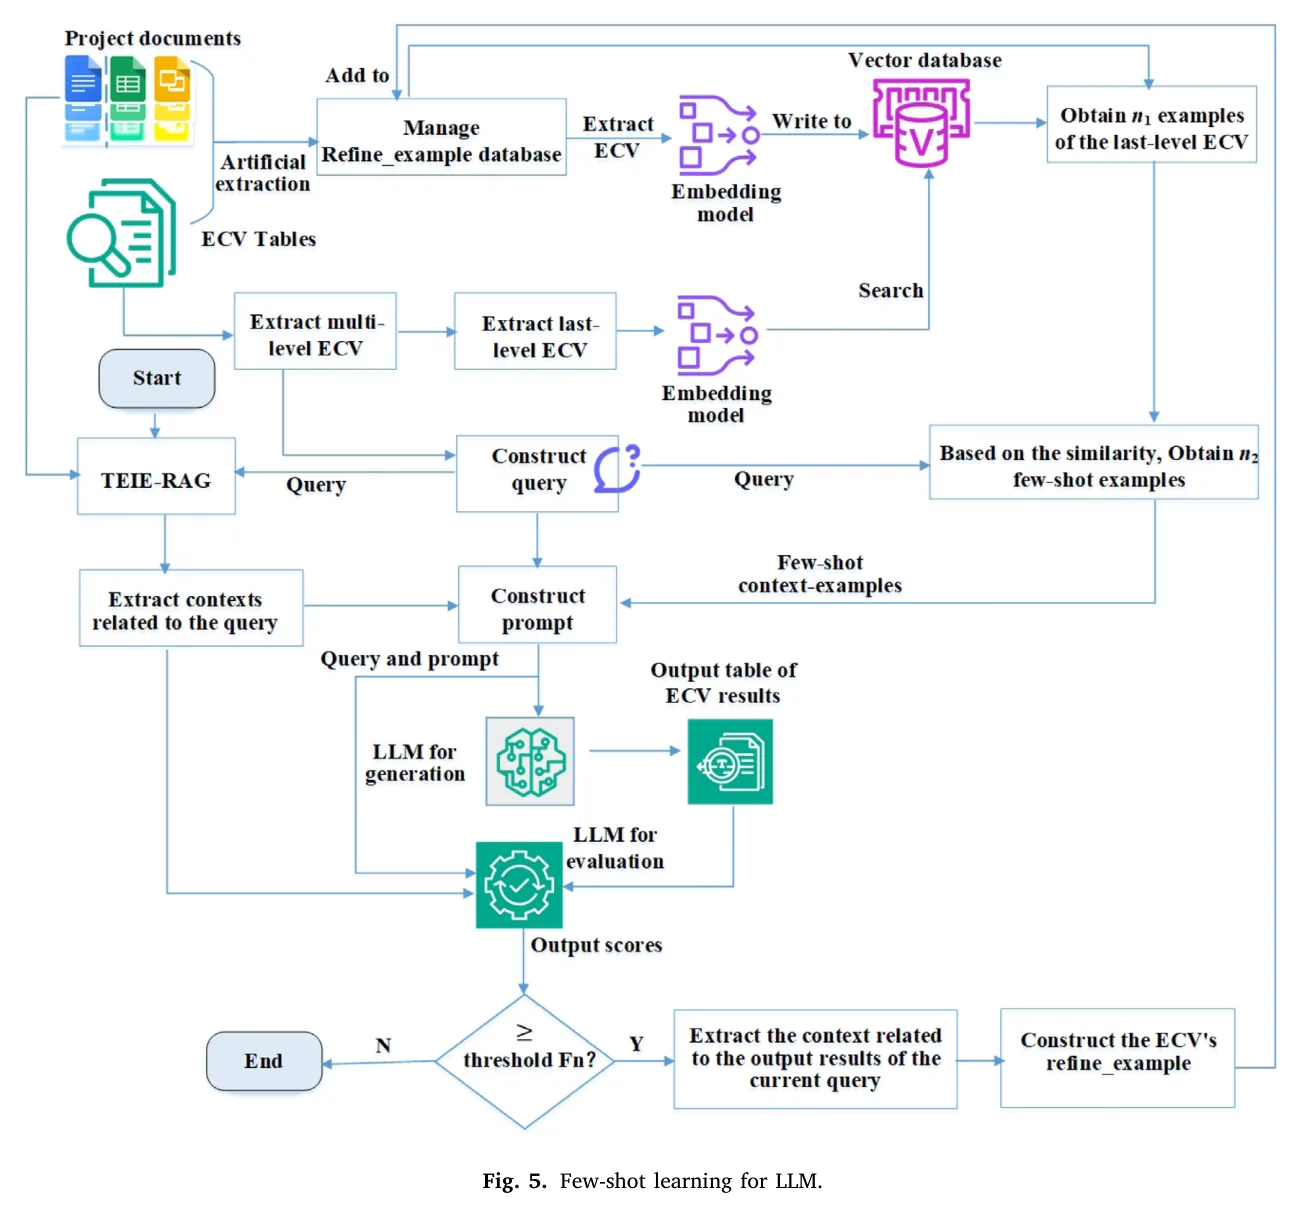
流程:ECV 多级表转成自然语言查询;prompt = 系统说明 + 问题 + Top 上下文 + 同类示例。生成后用 RAGAS Faithfulness(Qwen3-32B)打 0–1 分,阈值 才把「查询–上下文–答案」收进示例库,供后续同名变量复用。这是自举,不是一次做完的静态 prompt。
公平在文中主要指 别让错误值因为出现得多就被当成真值,不是社会群体公平。实际减偏手段是可解释 + 复核加权,加上 few-shot 限制模型用自己的参数知识胡编。
可解释:每个数字必须带回出处块号
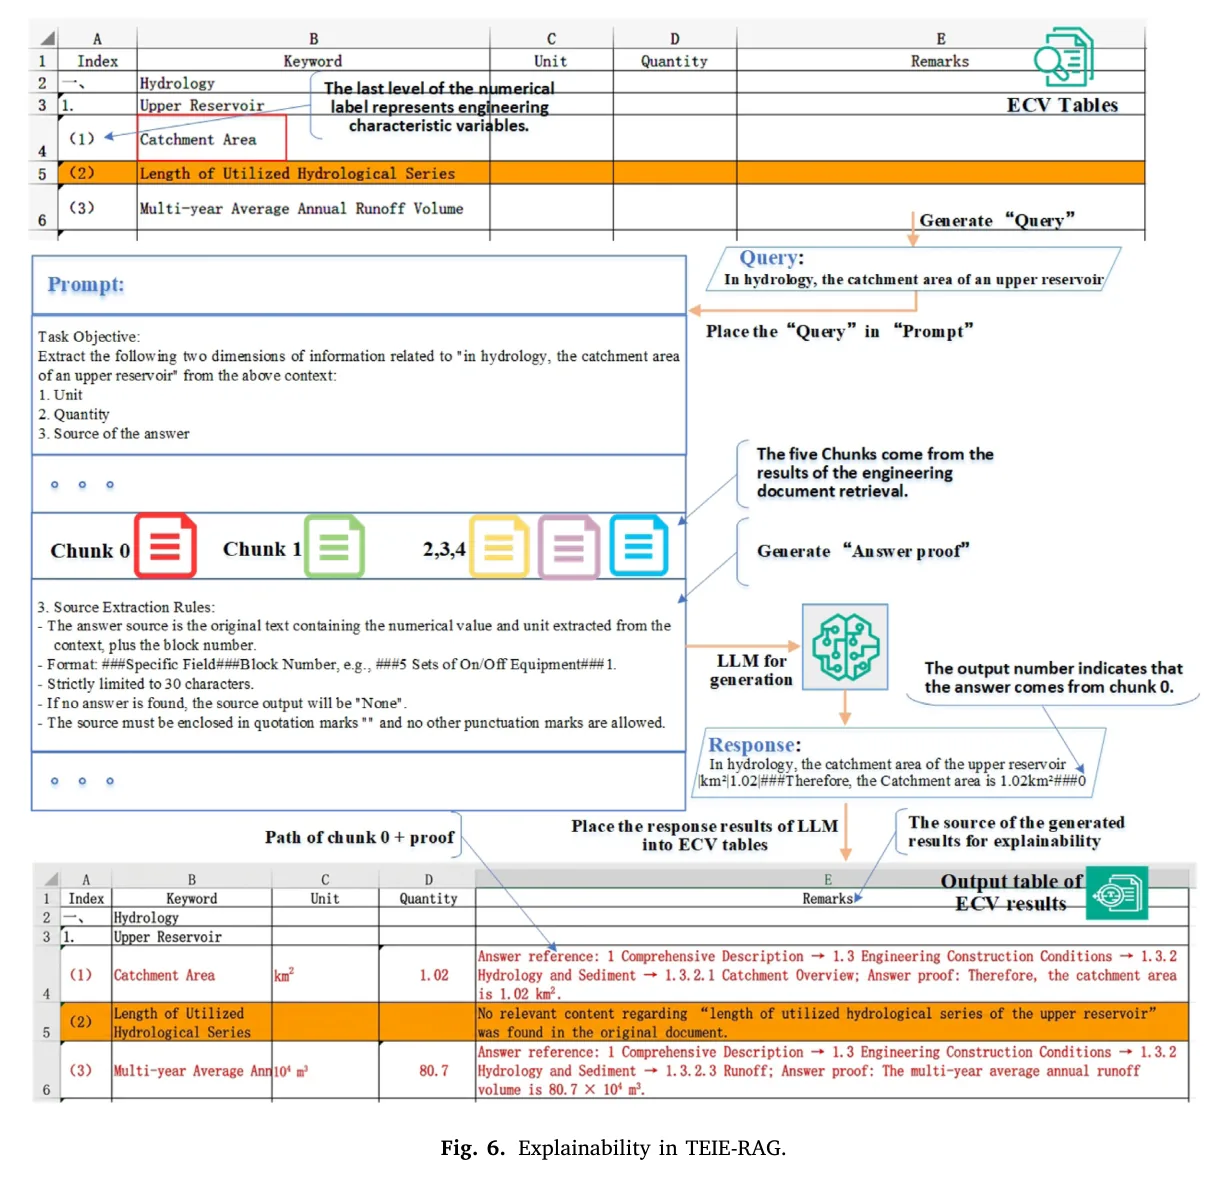
抽取阶段没有全局真值,同一变量可能出现多次。系统只产出一个候选值,但强制输出单位、数值、以及「哪一句话、哪一个 chunk」。用户看到的不是裸数字,是可以点回去的摘录。
可问责:核对阶段把冲突段落也挂出来
抽取和核对不是同一件事。抽取时不知道真值,只能给候选;核对时已经有候选,要在全文里找出 所有提到该变量的地方,尤其是和候选不一致的地方。
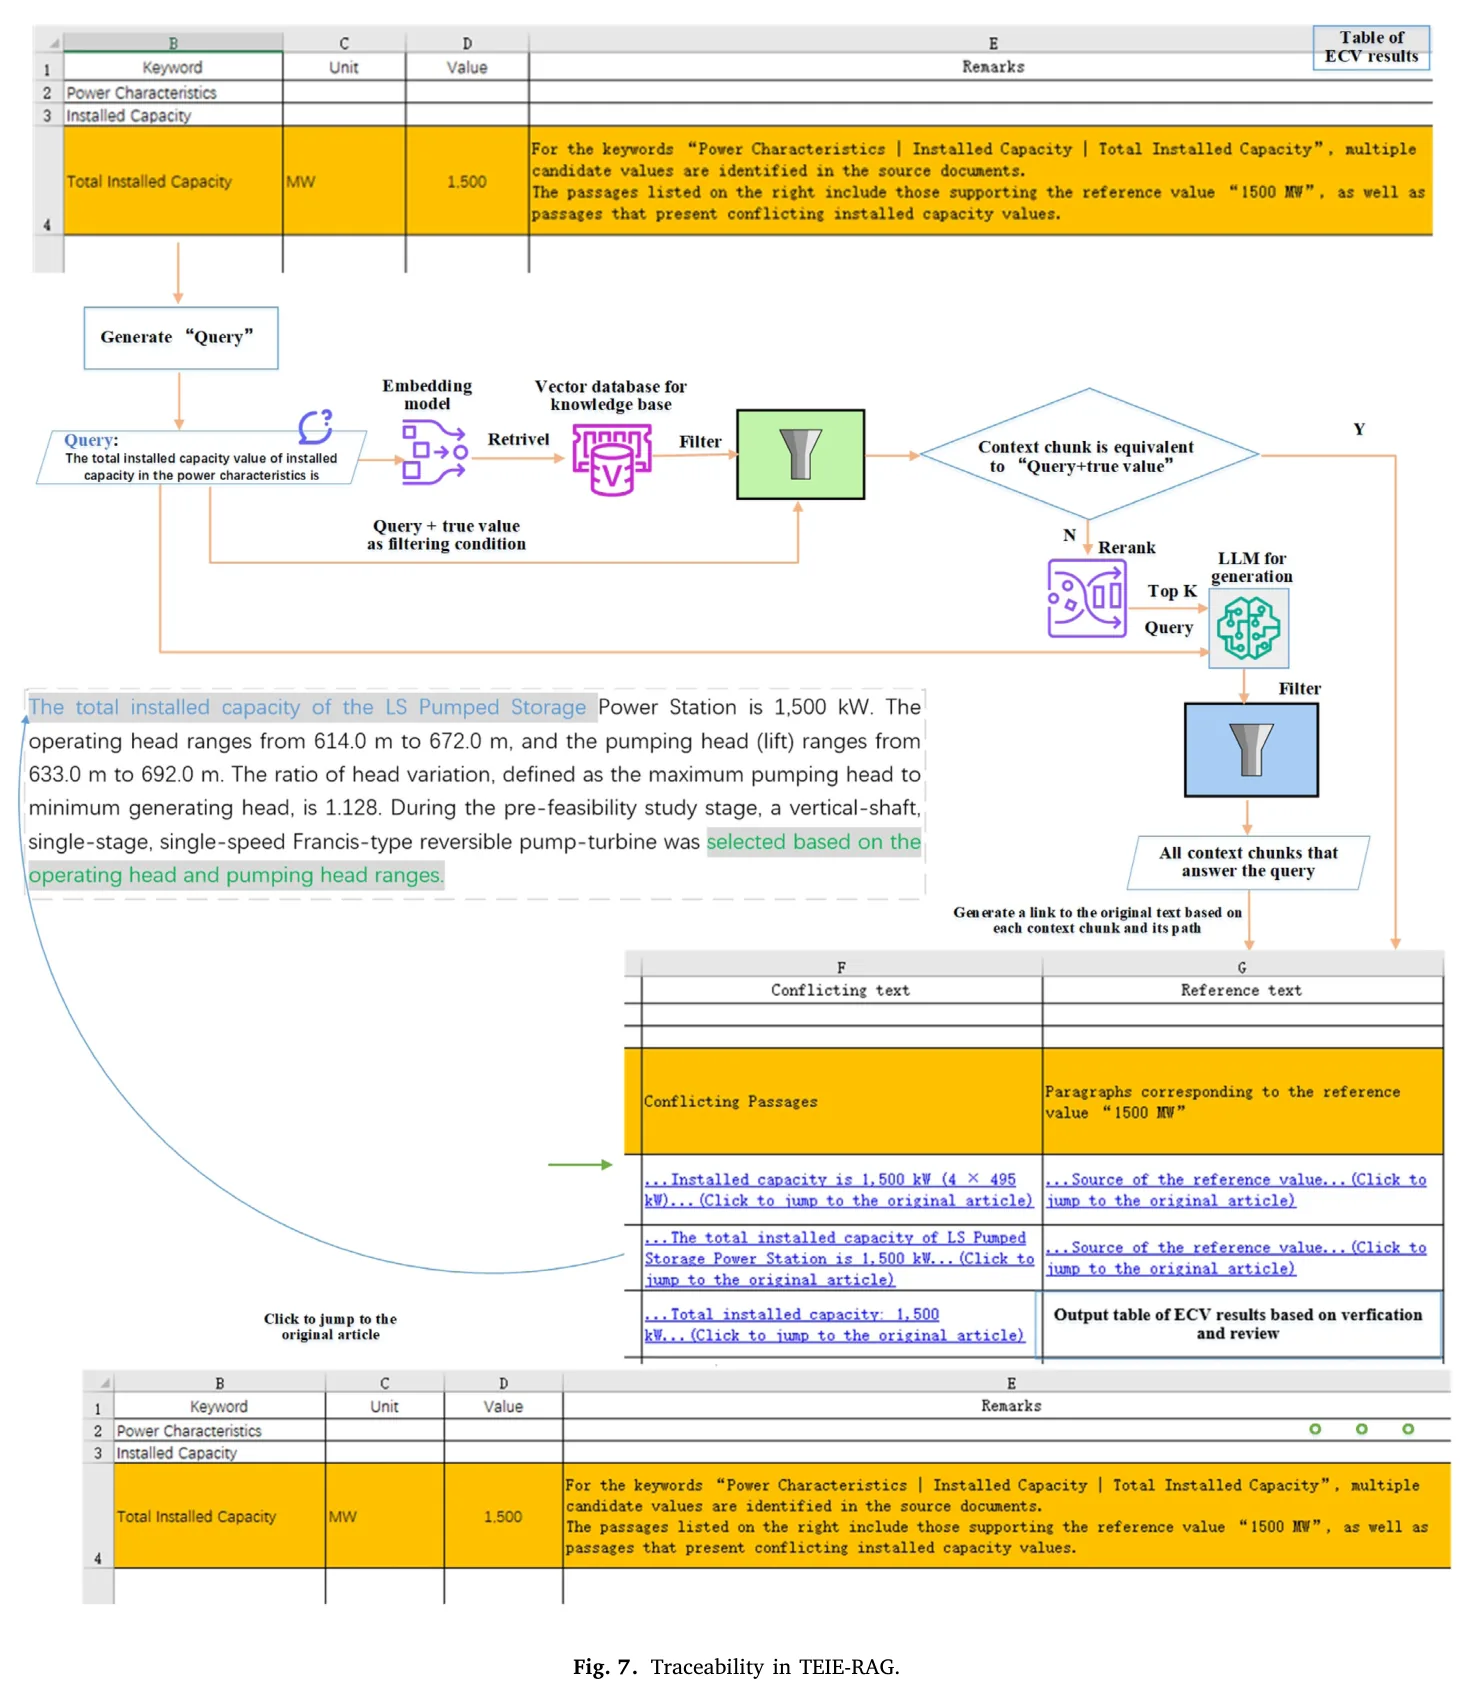
查询例:「电力特性中的总装机容量值为」。检索 → 用「查询 + 候选真值」过滤 → 重排 Top- → LLM 列出所有作答段落,分成参考文本 / 冲突文本,每条生成持久链接写回 ECV 表。工程师看到的是证据场,而不是黑盒答案。
隐私:会话级、无持久知识库
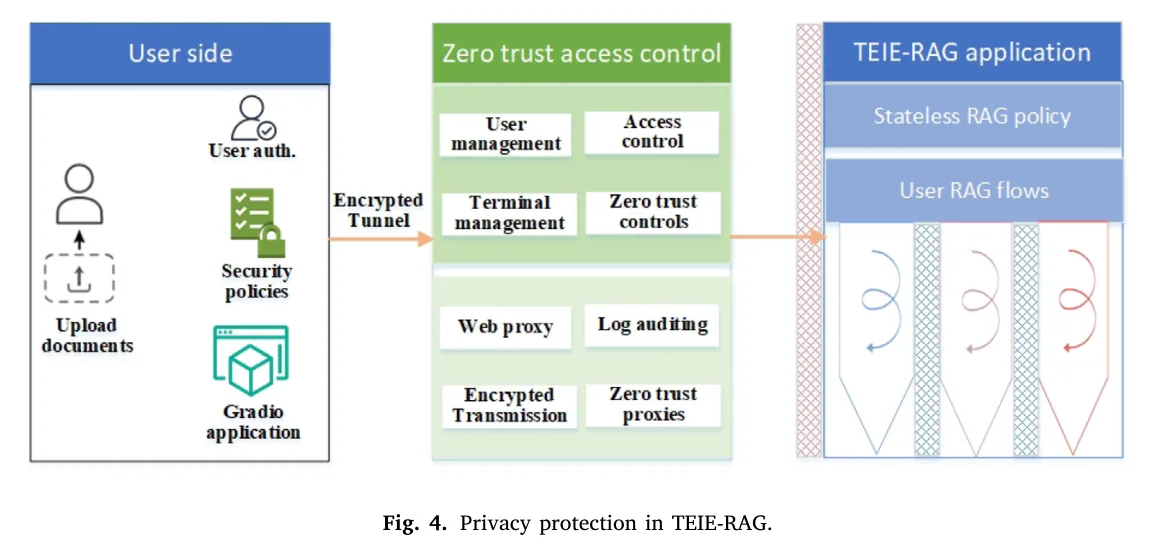
企业可研是核心资产。TEIE-RAG 假设系统接在零信任接入之后(认证、SSL 隧道、隔离),自身再加四条约束:会话作用域、不把用户文档并入全局向量库、不在应用日志里写正文、生成 LLM 不在用户语料上微调。目标写成
是本会话查询、文档与答案, 是系统持久状态。正文明确承认:为了准确率 ≥ 95%、单变量 ≤ 5 s,项目表摘要会被预处理, 实际非零。
安全:这里的安全是「错值不要流进下游设计」
文中把 security(防外部打进来)和 safety(防系统危害外部世界)分开。安全风险写成下游危害期望 ,落地是置信—弃权—人审:置信 送审,审查检出率 、纠正率 决定残差错误。公式写清楚了 怎么压低 ,实验部分没有给出这组超参的实测曲线。
实验:分块、检索、示例、溯源四段因果
数据来自水电合作方 27 份真实项目文档,三套 ECV 模板;embedding / rerank 用 1800 条(1400 训练 + 400 验证);8 份文档留作测试。§4.1 写测试集 809 个变量,§4.2 层次分块实验写成 845 个——后文按各表自己的口径引用,不在这里抹平。训练部署:4090 24 GB 跑 embedding / rerank;H100 + vLLM 跑 Qwen2.5-72B 生成与 Qwen3-32B 评价。
层次分块:方案对照和位置依赖是主因
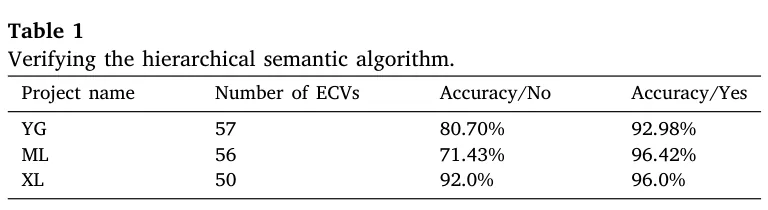
YG 80.70% → 92.98%,ML 71.43% → 96.42%,XL 92.0% → 96.0%。文内写提升幅度 4.0%–24.99%,三份文档全部上涨。注意这张表只有 3/8 份测试文档,不是全测试集均值。
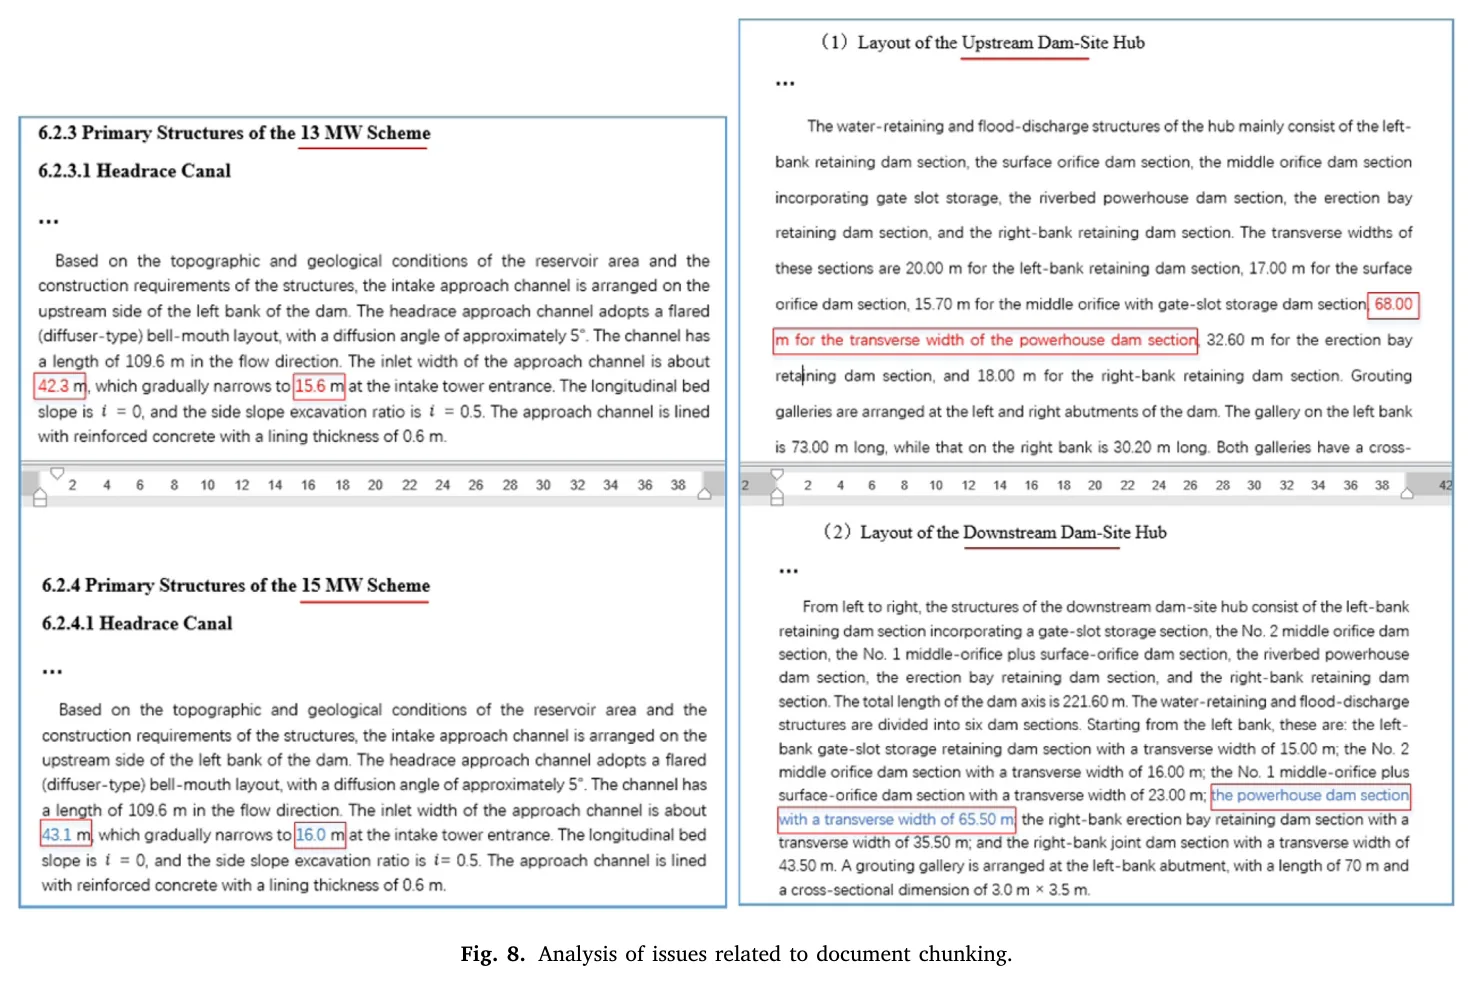
这张图是整篇文章最硬的动机:错误不是「模型不够大」,是 chunk 里没有方案名和位置。LLM 还偏好从上下文头尾取值,先出现的方案更容易被抄。
Embedding:难负例把 TOP-100 压到可部署的 TOP-60
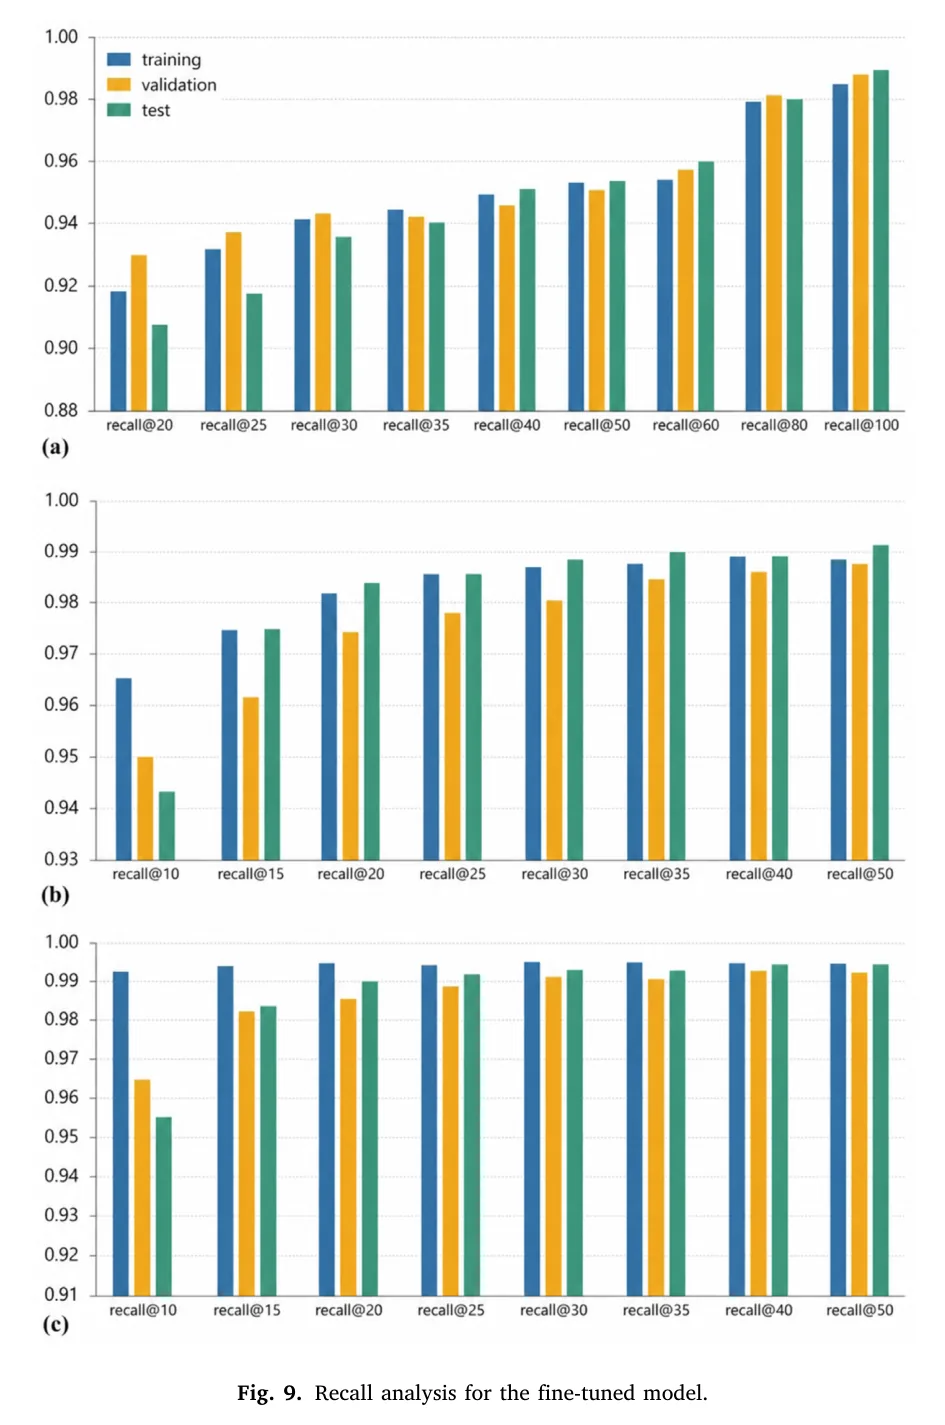
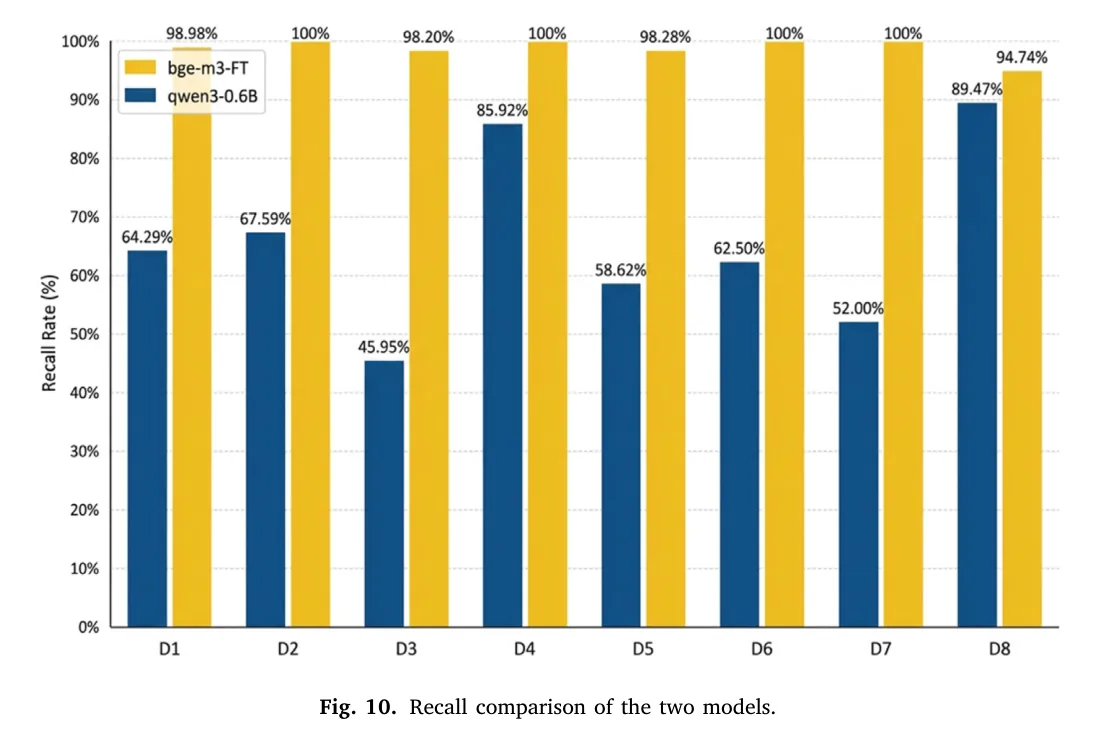
公开榜上 Qwen3-0.6B embedding 往往强于未微调 BGE-M3;这条域内对比说明 中文工程表示靠的是难负例微调,不是换更新的通用模型。部署仍取 TOP-60 而不是曲线上刚好够用的 TOP-30。
Rerank:答案集中到 TOP-1 / TOP-2,均值和稳定性一起涨
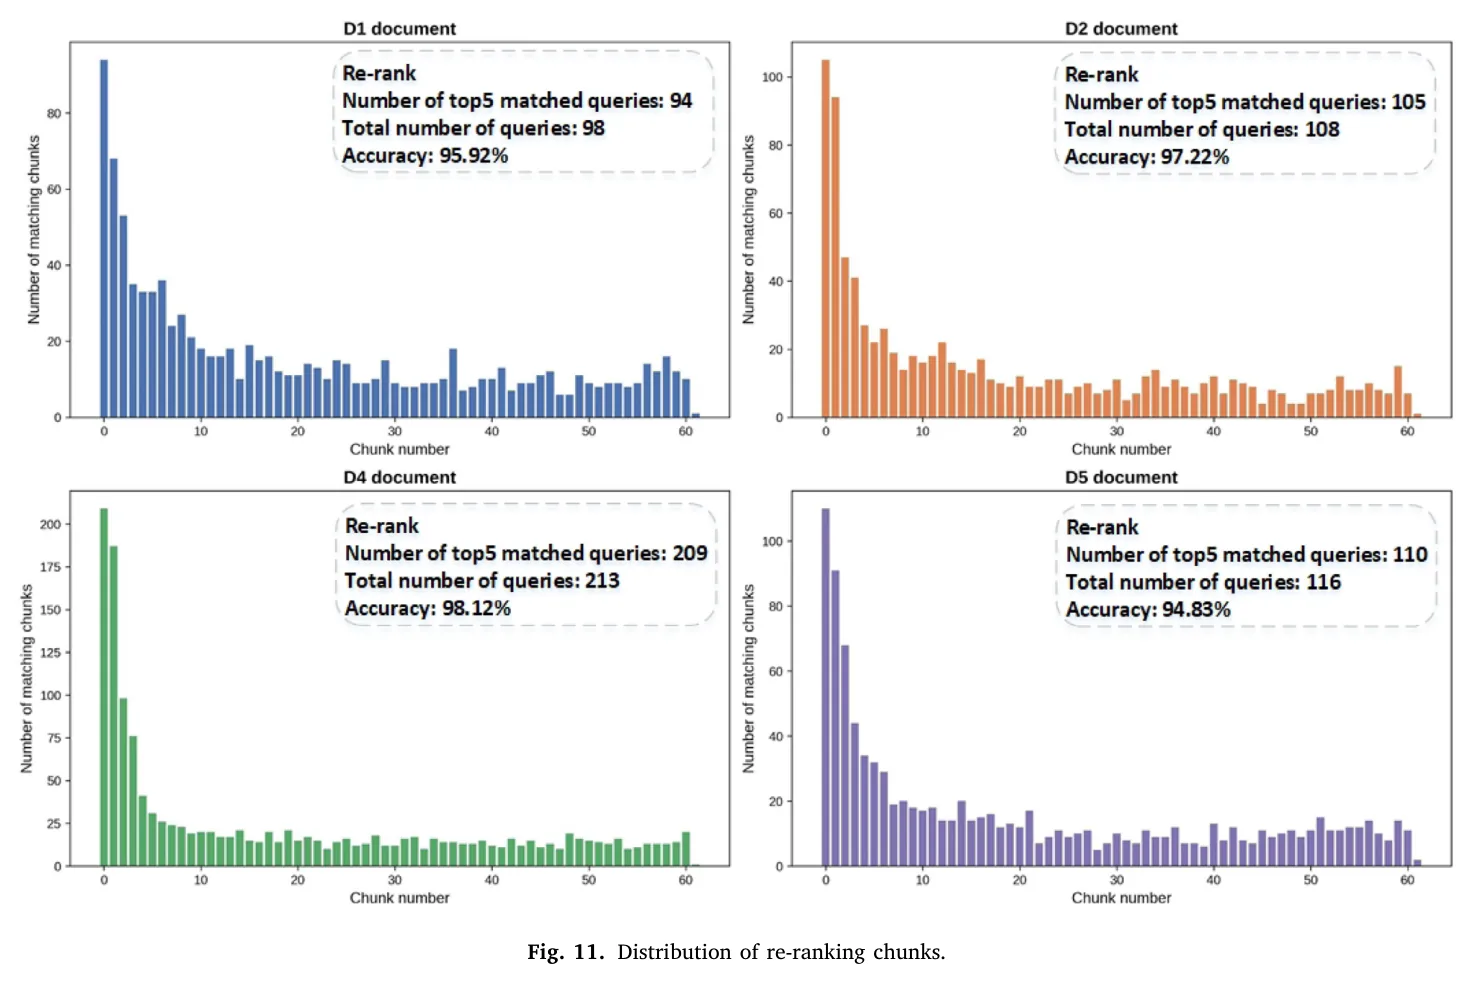
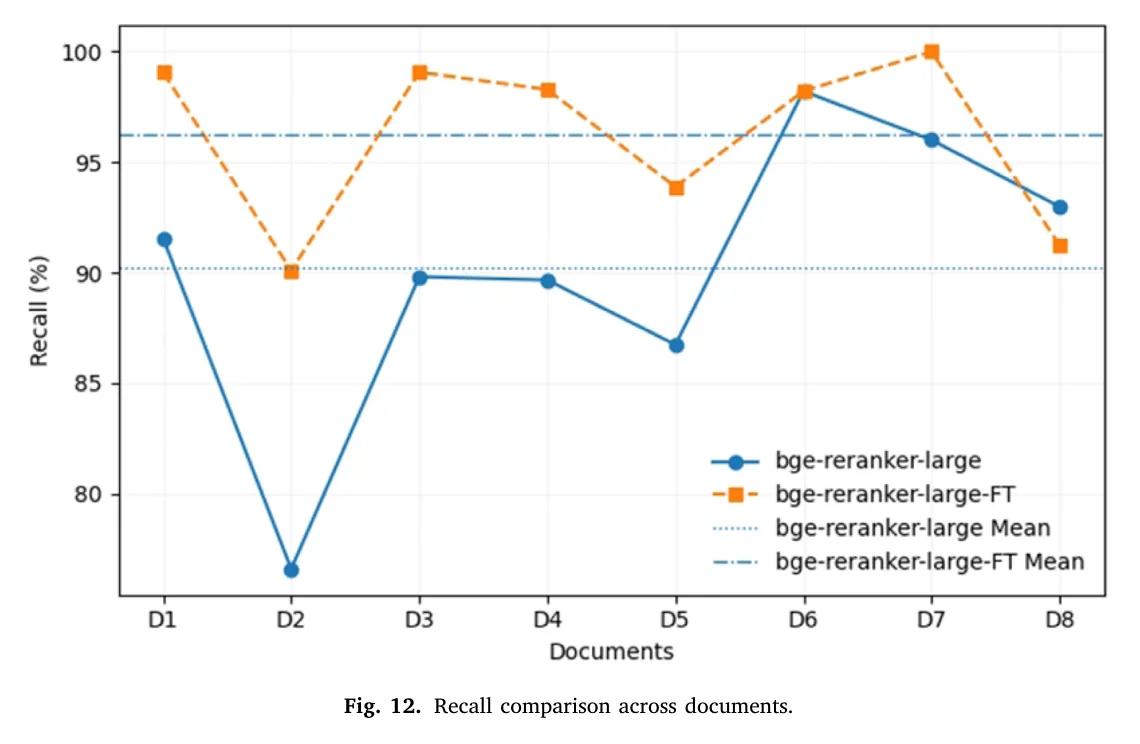
文中据此说实际系统 Top-5 基本覆盖答案。D2、D5 上未微调波动大,微调后点更贴均值——稳健性来自动均值,也来自方差下降。
Few-shot:格式示例有用,同类题才拉满
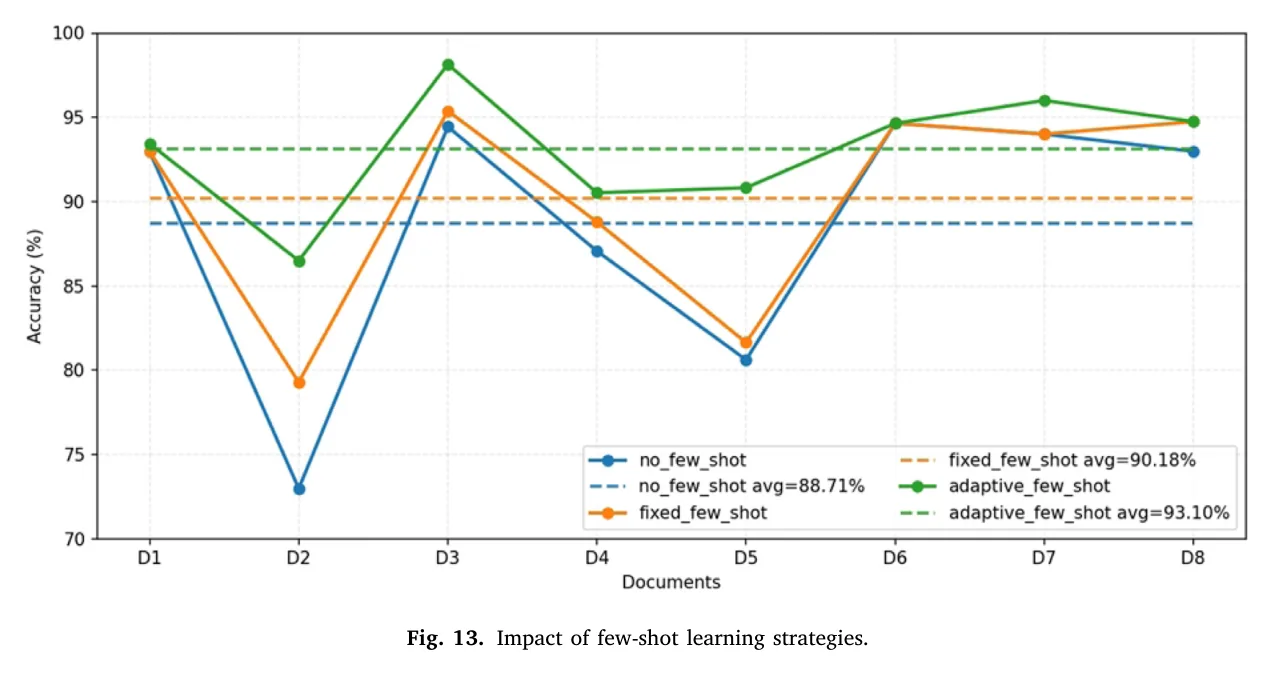
无示例 88.71%,固定示例(只给格式、与当前查询无关)90.18%,自适应 93.10%。D2 相对无示例 +13.52%,D5 +10.21%。结构示范能减少胡编格式,语义对齐的示范才能在异构文档上稳住。
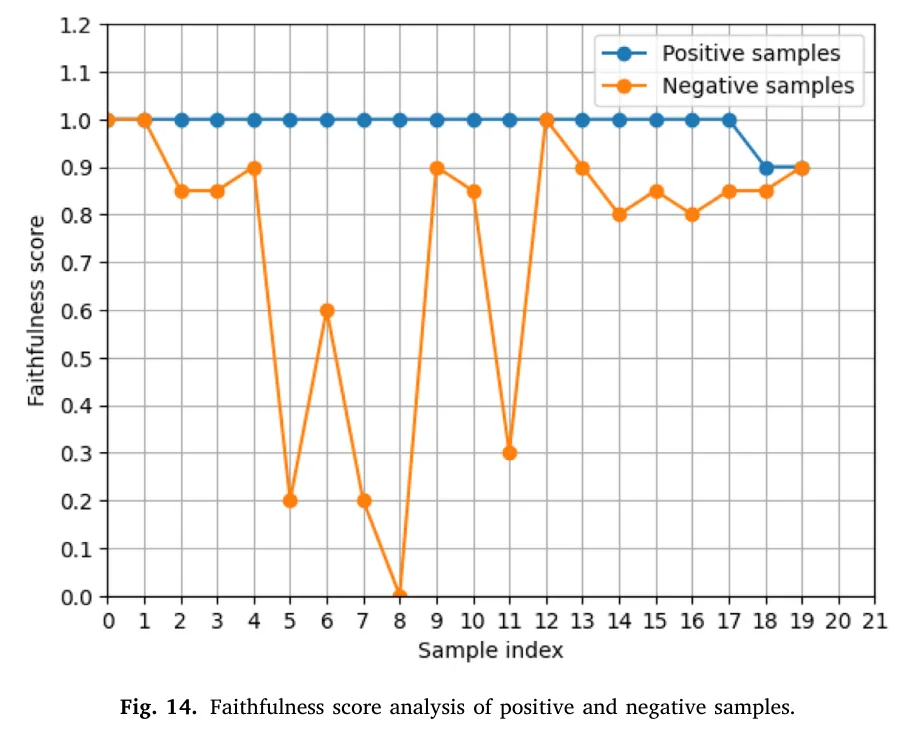
阈值 0.96 大体能挡住「上下文里根本没有该值」的样本,避免污染示例库。文内也拆了打分失误:正例 GT=1030 m、模型输出 770 m 且忠实度低于阈值(没进库,正确);负例用户给的 GT 不在文档里,模型根据相似 chunk 输出 3451.87 亩并拿到 1.0——评价模型会把「上下文里确实有一个像答案的数」判成忠实。后续仍要靠核对阶段纠。
溯源:先保证错误段落进得了检索窗
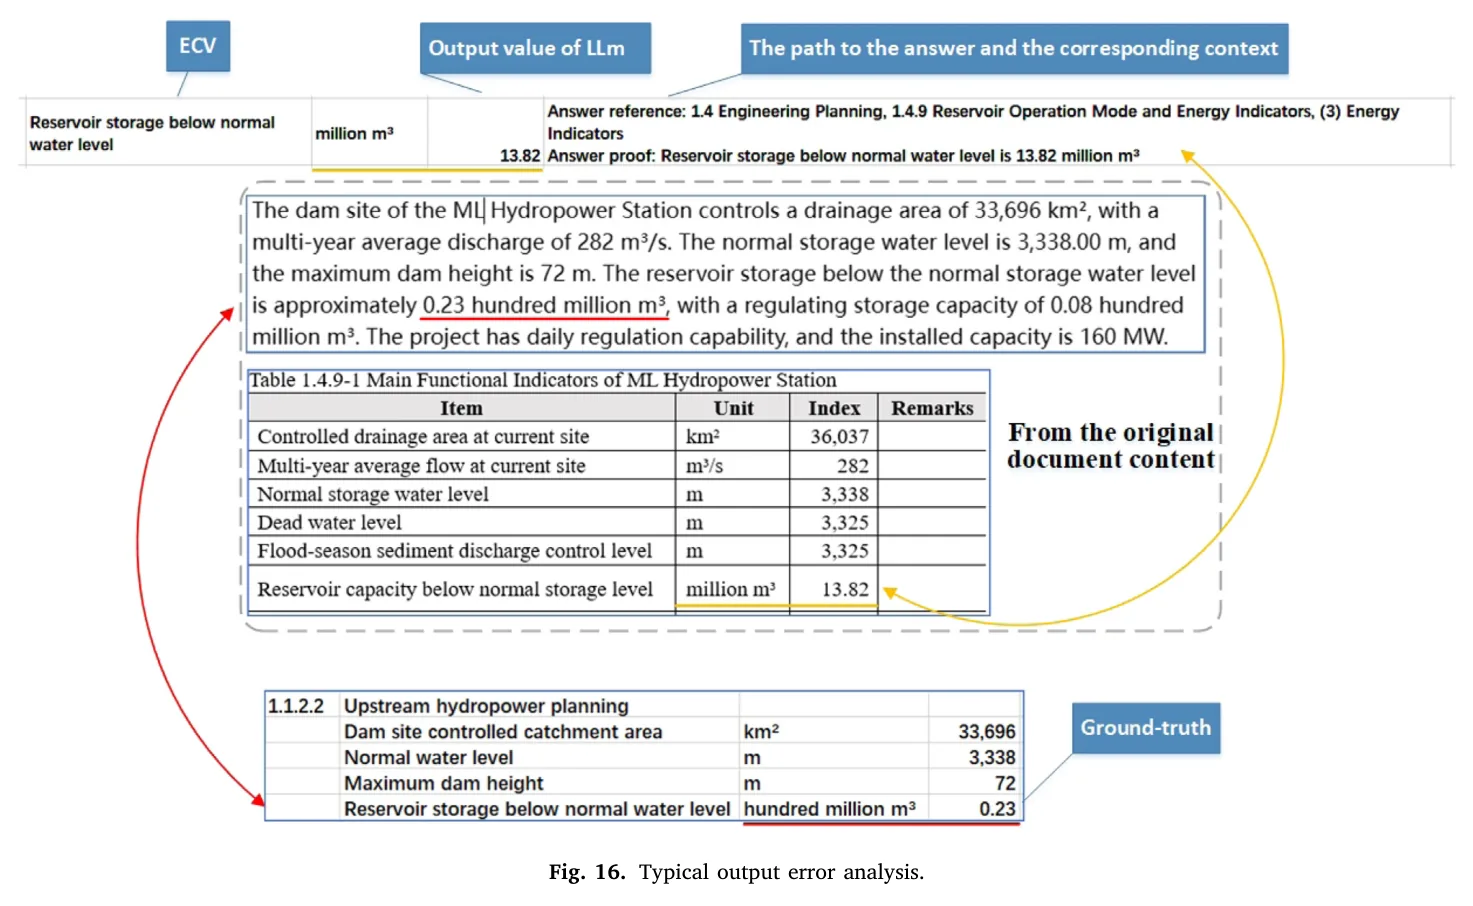
这类错的特征是 数值差一个数量级,上下文几乎同句。分块、检索、few-shot 都解决不了「两个都像真的」,只能把两边都亮给工程师。
验证方式:两份终审通过的文档,把多次出现且一致的 ECV 人工改成数值 / 精度 / 单位冲突,再看系统能不能把改动找回来。
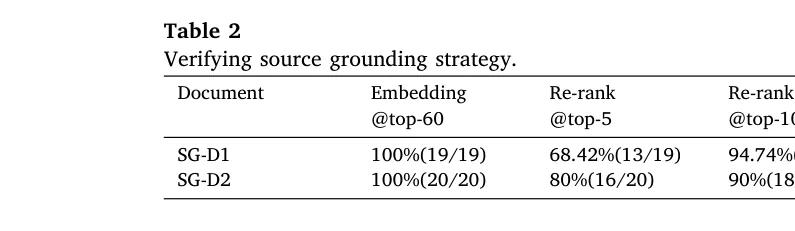
| 文档 | 错误条数 | Emb@60 | RR@5 | RR@10 | RR@30 | SG-Acc@30 |
|---|---|---|---|---|---|---|
| SG-D1 | 19 | 100% (19/19) | 68.42% (13/19) | 94.74% (18/19) | 100% (19/19) | 94.74% (18/19) |
| SG-D2 | 20 | 100% (20/20) | 80% (16/20) | 90% (18/20) | 95.0% (19/20) | 90.0% (18/20) |
合并识别率 ,与摘要一致。Top-5 重排召回只有 68%–80%,错误识别主要吃的是 Top-30 窗口,不是 Top-5。
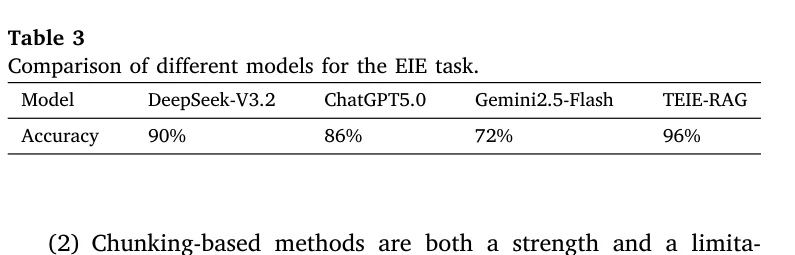
DeepSeek-V3.2 90%,ChatGPT 5.0 86%,Gemini 2.5 Flash 72%,TEIE-RAG 96%。这是单文档、100 变量、把整份中文材料交给在线模型的协议,和 8 文档 93.10% 不是同一张测试表;「ChatGPT / Gemini 中文理解更弱」也只建立在这一次对比上。
局限与讨论
- 摘要口径和实验口径不完全同名。 「93.10% Top-5 extraction accuracy」在 §4.5 是自适应 few-shot 的平均生成准确率;Top-5 是重排序覆盖答案的说法。Table 2 里错误上下文的 Top-5 召回只有 68%–80%。把 93.10% 读成「Top-5 检索准确率」会高估检索、低估生成侧示例的贡献。
- 96% 与 93.10% 不是同一评测。 Table 3 是一份文档 100 个变量对在线模型;93.10% 是八份文档上的自适应 few-shot。两套数字都对,但不能写成「全面 96%」。
- 测试集规模自相矛盾。 §4.1 写 8 文档 809 个 ECV,§4.2 写 8 文档 845 个。Table 1 只用了 YG / ML / XL 三份。层次分块的 4.0–24.99 个点是三份文档的全距,不是八份的置信区间。
- 溯源实验是人工植入错误,不是自然错误分布。 在「已经终审通过、原本一致」的文档上改数值 / 精度 / 单位,召回上限被构造得很干净;真实可研里定义不同、方案并列、表文冲突会更脏。Embedding@top-60 = 100% 说明窗够大,不等于现场冲突都能被 LLM 正确分类。
- 公平、安全两维偏定义、偏公式。 频率致偏有后验不等式,人审管道有 ,正文没有对应的分组公平指标,也没有 扫描或审查检出率。隐私目标 随即被「表摘要预处理导致 」收回。
- 评价模型会错放行。 忠实度由另一台 LLM 打分;负例里「上下文有一个像答案的数」可以拿到 1.0。自举示例库在阈值之上仍可能灌进错例,论文自己把这条写进了未来工作。
- 对照偏弱、无法复现。 没有在同一 809/845 变量上对比 GraphRAG、其他工程 RAG 或未分块的长上下文基线;数据依请求提供,无代码仓库。Qwen2.5-72B + H100 的栈也决定了这不是「换个开源 7B 就能复现」的系统。
- 文档结构假设偏 DOCX 标题树。 PDF 转 DOCX、表结构丢失、标题层级不规范,是作者自己列的下一项;当前增益不能直接外推到扫描件或无标题施工日志。
- 正文有多处缩写抖动(TEIR-RAG、TEIE-TAG),引用框架图时以 TEIE-RAG 为准。
总结
TEIE-RAG 的可迁移顺序是:问题场景 > 分块门牌 > 难负例检索 > 溯源把冲突摊开。工程抽取里最常见的不信任,不是模型不会读中文,而是同一变量在邻方案、上下游、表与正文里各写一次,普通 chunk 把它读成「差不多的一段话」。层次路径解决的是语义完整性,难负例解决的是「像但不对」,自适应 few-shot 解决的是格式和同类题,溯源解决的是分块解决不了的表文冲突。六维可信度里,稳健和可问责有表、有图、有失败案例;隐私、公平、安全更多是部署约束和风险分解——读的时候按这个权重分配注意力,数字就不会被摘要里的 Top-5 / 96% 带跑。
See also
- VAST 精读:CLIP 持续学习里,视觉分支为什么忘得比文本快 2026-09-11
- StyCona 精读:SVD 把域偏移拆成风格与内容,数据增强各打各的 2026-09-04
- PHFNet 精读:全阶段并行 CNN–Transformer,线性注意力里把弱红外目标补回来 2026-09-03
- GLCNet 精读:小波打散相干斑,全局-局部协作做真实 SAR 去斑 2026-09-02
- DCRM-ViT 精读:冻结骨干,按样本现调参数的多域视觉 Transformer 2026-08-28